
為什麼 AI 寫入不能直接落庫:QTable 的 Preview → Confirm → Apply
當 AI 開始修改業務資料,最危險的失敗不再是一句答錯的話,而是過期、越權或理解錯誤的決定成為持久的業務事實。本文結合 QTable 目前的 Action Plan、版本檢查、權限重驗證與 ChangeSet 審計鏈路,拆解 Preview → Confirm → Apply 為什麼應該成為系統邊界。
如果 AI 只是在聊天視窗裡給建議,答錯了通常還有機會在真正影響工作之前修正。
但當同一套系統開始修改任務負責人、截止日期、狀態、依賴關係,甚至批次建立新任務之後,錯誤就不再只是一段不準確的文字。它會直接進入業務事實。
真正麻煩的地方還不只是「模型會不會犯錯」。人也會犯錯。更棘手的是,AI 做出決定的那個瞬間,和真正寫入資料的那個瞬間,不一定處在同一個世界裡。
舉一個很普通的時間線。
10:02,Agent 讀取任務 A,看到它仍是「進行中」,Record version 是 12,於是建議把截止日期改到下週一。
10:03,一位同事剛好編輯同一條任務,改了狀態和截止日期,Record 變成 version 13。
10:04,使用者回到 AI 面板,看到剛才那條建議,按下確認。
如果系統把「使用者確認過」理解成「現在可以無條件執行」,那條基於 version 12 產生的舊建議,就可能覆蓋 version 13 裡已經存在的新工作。
這也是 QTable 為什麼沒有把 AI 寫入設計成「模型回傳 JSON,然後直接 update database」。
我更希望它遵守一條簡單但嚴格的路徑:
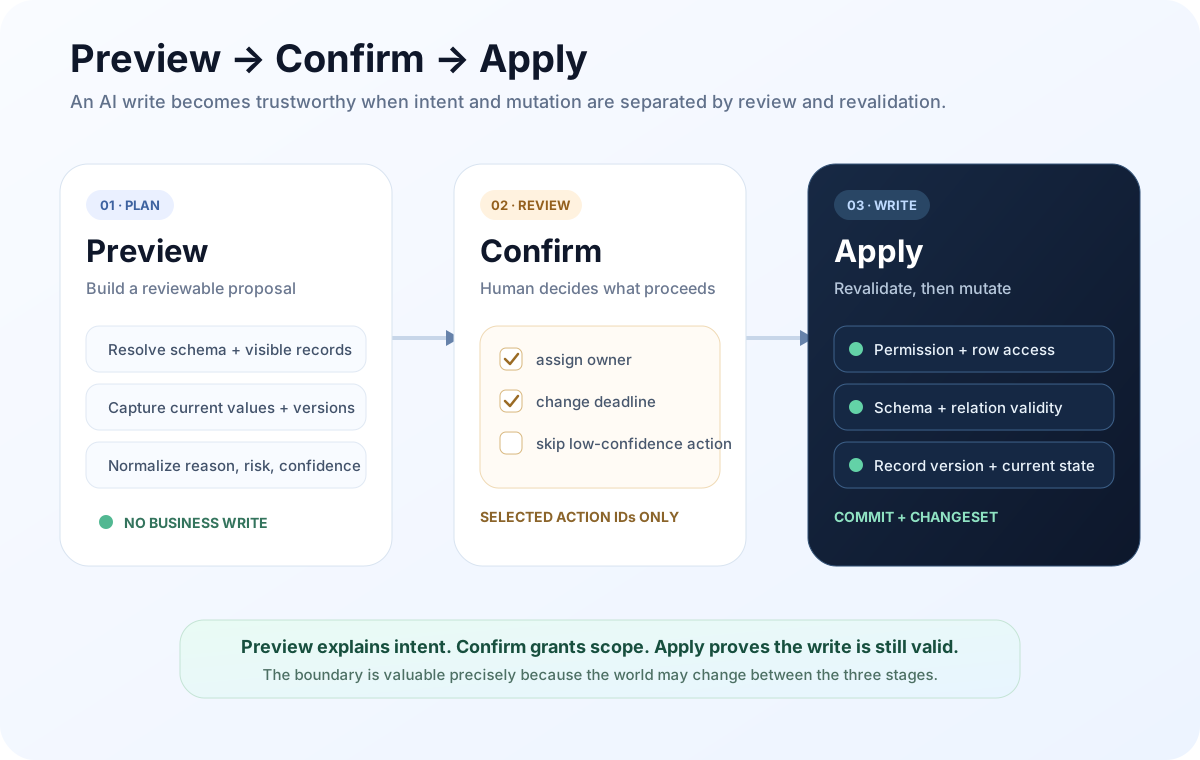
Preview → Confirm → Apply
這三個詞看起來像互動流程,但真正重要的是背後的系統邊界。
Preview 不是「先展示一下」,而是一次沒有業務寫入的計畫生成
很多產品也有 AI Preview,但它經常只是一層 UI:模型已經決定要改什麼,前端先把結果顯示出來,使用者按一下按鈕,後端照單執行。
這和我理解的 Preview 不是同一回事。
QTable 目前的 ai_action_plan.py 在 Preview 階段會先把建議收斂成結構化 Action Plan。它會解析目前診斷、目標表、欄位定義、使用者可見紀錄,以及當下的 record version,再把候選動作正規化成領域層能驗證的業務操作。
目前支援的動作包含負責人、優先級、截止日期、狀態、標籤、依賴與建立任務。對應的請求契約定義在 app/schemas/ai_action_plan.py。
更重要的是:Preview 本身不修改業務紀錄。
倉庫裡的測試 tests/test_ai_action_plan.py 專門驗證了這件事:產生 Action Plan 後,Record 資料和版本維持不變,也不會產生業務 ChangeSet,但會保存一份狀態為 previewed 的 AiActionPlanBatch。
這份 Preview 不是自然語言摘要。它會保留之後 Apply 真正需要的狀態,例如:
- 目標 Table 和 Record;
- 動作型別和建議值;
- 目前值與建議值;
- Preview 當下看到的 record version;
- 相關欄位型別、成員與 relation 目標;
- reason、risk warning、confidence;
actionId,讓後續選擇要執行的動作有穩定身份。
這一步的價值,是把「模型覺得應該這樣做」變成「系統可以檢查的一份候選變更」。
如果 Preview 只是一張漂亮卡片,卻沒有保留當時的資料版本、權限範圍和具體動作身份,那麼後面的 Confirm 其實沒有可靠的物件可以確認。
Confirm 的意義不是「相信 AI」,而是確定寫入範圍
Confirm 很容易被理解成一句話:使用者按了「確認」,所以 AI 可以執行。
這還不夠準確。
在 Action Plan 這條鏈路裡,Confirm 更像是人對一組具體動作做選擇。QTable 的 Apply 請求接受 planId 和一組 actionIds,也就是說,使用者可以只放行其中一部分,而不是把整個 AI 建議一次性授權。
假設一份計畫裡有四個動作:
- 把任務 A 交給 Bob;
- 把任務 A 截止日期改到週一;
- 把任務 B 優先級提高;
- 建立一條新的回歸測試任務。
使用者可能認可前三個,但不希望第四個現在就建立。
有意義的 Confirm 必須保留這種選擇,而不是只有「全部接受 / 全部拒絕」。
這裡還有一個實作細節值得說清楚:Action Plan 服務不需要為了概念對稱,硬造一個叫做 confirm() 的方法。 在目前這條路徑裡,確認結果透過 Apply 請求中的 actionIds 表達;另一方面,QTable 的通用 AI Runtime 也有獨立的 pending confirmation 機制和 /runtime/confirm 路徑,用來恢復被確認門攔住的工具執行。
兩套機制並不完全相同,但共同遵守同一個原則:帶有副作用的操作,不能只因為模型表達了意圖就自動跨過邊界。
從 Preview 到 Apply 之間,世界已經可能變了
這是整條鏈路裡最容易被低估的一點。
使用者可能會花幾秒、幾十秒,甚至幾分鐘檢查 Preview。他也可能切回表格核對資料。這段時間裡,其他使用者、自動化、API 或另一個 Agent 都可能繼續修改同一批紀錄。
所以 Confirm 只能說明:
「我認可剛才看到的這個意圖。」
它不能自動證明:
「剛才的意圖在現在這個狀態下仍然成立。」
兩句話差很多。
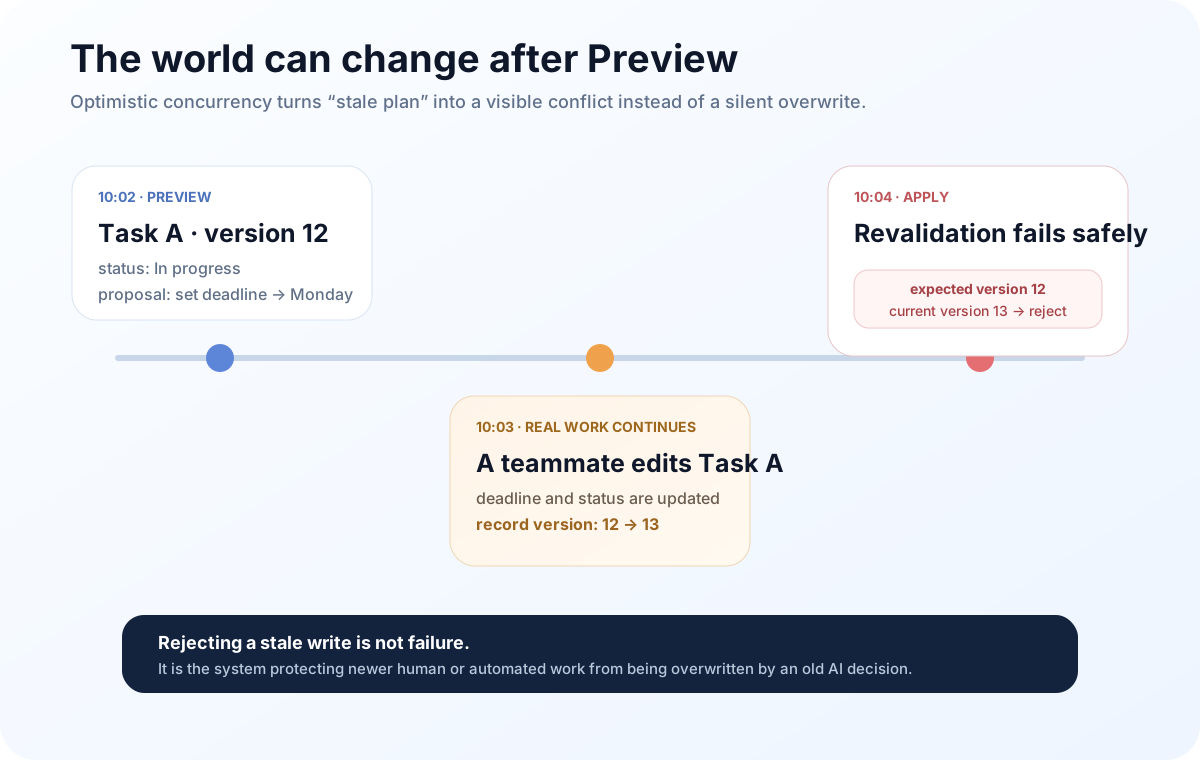
QTable 目前的 TableRecord 有單調遞增的 version。Preview 會保存當時的版本;Apply 時重新鎖定並讀取目標 Record,如果目前版本和 Preview 時不同,就拒絕這次寫入,要求重新產生 Action Plan。
程式碼裡的錯誤訊息很直接:
Record changed after preview; regenerate the Action Plan before applying.
我很喜歡這種失敗方式。
它沒有試圖「聰明地合併」一個已經失去上下文的 AI 決定,也沒有靜默覆蓋新的業務狀態,而是承認一個事實:這份計畫已經過期。
對真實工作系統來說,這種保守通常比自動修復更可靠。
Apply 不是執行 Preview,而是重新證明 Preview 仍然合法
如果只看 UI,Apply 好像只是最後一個「確定」按鈕。
但服務端真正要做的事情多很多。
目前的 AiActionPlanService.apply 會重新檢查目標狀態,而不是相信 Preview 階段的舊結果。至少包含這些邊界:
| Apply 前重新確認的內容 | 為什麼不能沿用 Preview 結果 |
|---|---|
| Table 是否仍存在 | 目標可能被刪除或移動 |
| 使用者是否仍有 update 權限 | 權限可能在確認前改變 |
| Row-level access 是否仍允許這條 Record | 紀錄可能已不再可見 |
| 負責人是否仍是有效 Workspace 成員且可存取任務表 | 成員資格或權限可能改變 |
| Relation 目標是否仍可存取 | 依賴物件可能刪除或被隱藏 |
| 欄位是否仍存在且型別一致 | Schema 可能改變 |
| Select / MultiSelect 選項是否仍有效 | 建議值可能已失效 |
| Record version 是否仍和 Preview 相同 | 防止覆蓋 Preview 之後的新修改 |
重點是:Apply 不會再去問一次模型。
到底能不能寫,是由當下的業務狀態與服務端規則決定。
所以我更願意把 AI Action Plan 看成一份帶前置條件的變更提案,而不是一批資料庫命令。
衝突應該被明確暴露,而不是藏起來
傳統 CRUD 裡,很容易把「寫入成功率」看成越高越好。
但對 Agent 來說,一味追求「只要使用者按了確認,就盡量讓它成功」反而很危險。
如果 Preview 之後:
- 紀錄被別人改了;
- 欄位從
select改成其他型別; - 建議的負責人已經離開 Workspace;
- Relation 指向的物件不再可見;
- 使用者權限被收緊;
那麼最安全的結果就是 Apply 被阻止。
QTable 的 Action Plan 測試已經覆蓋了多種這類場景:並發修改會阻止 Apply、隱藏 Row 不能進入 Preview、非 Workspace 成員不能被分配、可見的依賴循環會被拒絕、過期 Diagnosis 不能繼續產生 Action Plan。
這些測試比「模型在 Demo 裡能不能自動改五條任務」更重要,因為它們驗證的是 Agent 真正進入業務系統之後的底線。
寫入成功之後,還必須留下足夠完整的證據
安全寫入不能在資料庫 commit 成功那一刻結束。
如果三天後有人問:
「為什麼這條任務的負責人變成了 Bob?」
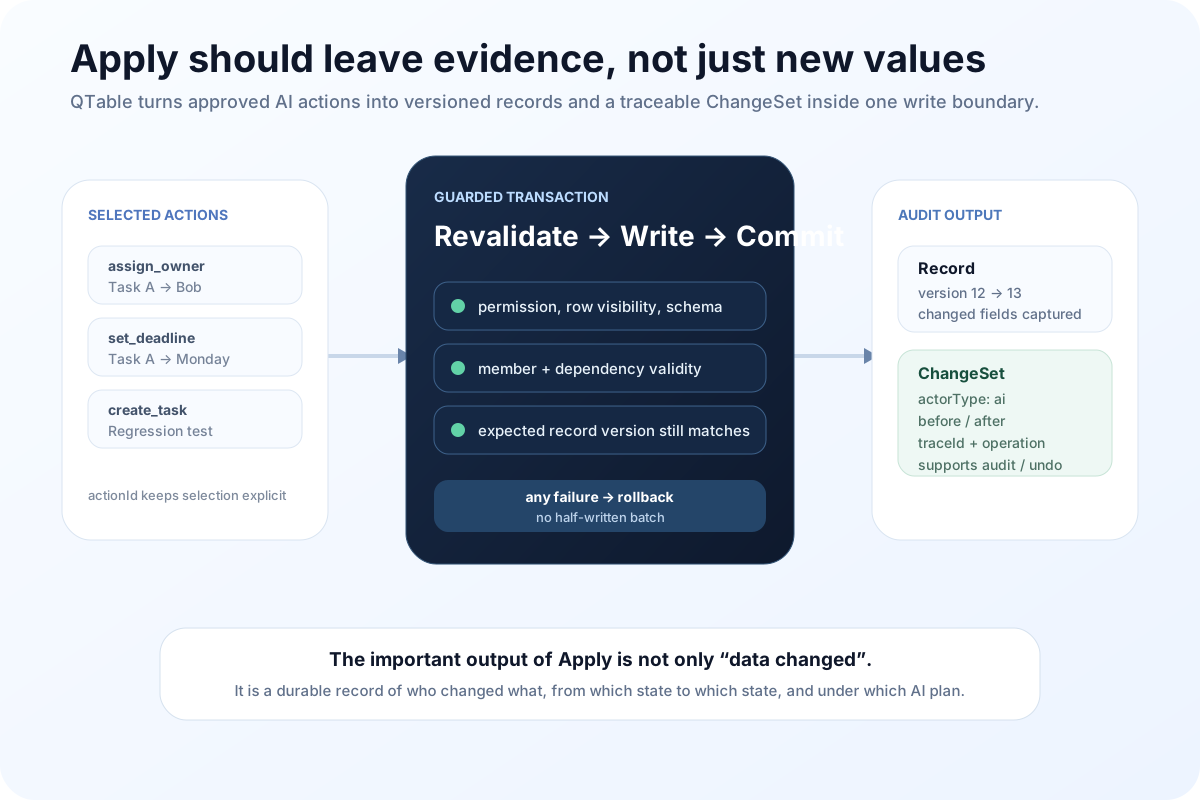
系統至少應該能回答:
- 是誰觸發的;
- 是人工、AI 還是自動化;
- 屬於哪一份 Action Plan;
- 修改前是什麼;
- 修改後是什麼;
- 哪些欄位發生變化;
- Record version 從多少變到多少。
QTable 的 change_history.py 提供 ChangeSet / ChangeItem 這一層。AI Action Plan Apply 成功時,會以 actor_type=“ai”、operation=“ai_action_apply” 寫入 ChangeSet,並記錄 before / after、version before / after、changed fields 和 trace id。
這層紀錄還有另一個價值:Undo。
但 Undo 只能是最後一道安全網,不能取代 Preview 和 Confirm。
如果 AI 一次批次誤改幾百條紀錄,就算技術上可以 Undo,使用者仍然得先發現問題、理解影響,再決定是否回滾。錯誤通知、下游自動化觸發,甚至權限相關的資訊暴露,也不一定能靠一次資料庫回滾完全消除。
更好的順序始終是:盡量在寫入前阻止錯誤,寫入後仍保留恢復能力。
Partial Apply 和 Idempotency,是很容易被忽略的工程細節
現實裡的確認不一定是「一次把整份計畫執行完」。
使用者可能先執行兩個動作,之後再回來確認第三個。網路重試也可能讓同一個 Apply 請求送出兩次。
如果系統沒有處理好這些情況,就會出現很奇怪的結果:重複建立任務、重複修改欄位,或第二次 Apply 因為第一次已經增加了 version,而錯把自己的重試判斷成並發衝突。
QTable 目前 Action Plan 會記錄已經應用過的 actionId。同一組動作再次送出時可以識別成 idempotent;部分動作已經成功後,剩餘動作仍能繼續執行。Batch 狀態也會區分 previewed、partially_applied、applied 和失敗情況。
這些設計聽起來不太「AI」。
但它們決定了 AI 功能能不能長期留在真實工作流裡。
為什麼我不想給 AI 一條特殊寫入捷徑
做 AI 功能時,有一種實作非常誘人:
模型已經給出了目標欄位和新值,那就做一套 AI-only mutation,驗證幾個參數後直接更新資料庫。
短期看很快。
長期看,它會產生第二套規則:
- 人工操作走一套權限與驗證;
- AI 操作走另一套「比較方便模型」的捷徑;
- 自動化最後可能又有第三套。
結果是同一條 Record,因為入口不同,得到不同的驗證、審計與並發行為。
QTable 現在的方向正好相反。AI Action Plan 最終仍然要回到 Workspace / Table / Record / Permission / Relation / Version / ChangeSet 這些共同的產品物件。
AI 可以更會「提出建議」,但不應該獲得一條繞過業務規則的高速通道。
Preview → Confirm → Apply 真正保護的是什麼
這套流程保護的不只是資料。
它保護的是人和 Agent 之間的責任邊界。
Preview 讓系統把意圖說清楚:我要改什麼,為什麼改,風險是什麼。
Confirm 讓使用者決定範圍:這些動作裡,哪些是我現在願意放行的。
Apply 則重新面對現實:在此刻的權限、Schema、Relation 和版本狀態下,這些動作還成立嗎?
任何一層都不能取代另外兩層。
只有 Preview、沒有 Apply 前重驗證,使用者確認的是一份可能已經過期的計畫。
只有 Confirm、沒有結構化 Preview,使用者看到的往往只是「AI 將最佳化專案」這類無法真正審查的描述。
只有 Apply 和 Undo、沒有寫入前邊界,系統其實是在用回滾能力掩蓋缺少控制。
所以對我來說,Preview → Confirm → Apply 不是一種互動設計偏好,而是 AI 真正開始修改業務資料以後,必須認真對待的一條執行邊界。
下一篇我會繼續往前追一個更基礎的問題:Preview 裡的那份計畫,到底建立在什麼 Context 上?
安全執行解決的是「AI 怎麼寫」,而 Context Engine 要解決的是另一半:AI 到底憑什麼知道自己正在處理哪個 Workspace、哪個專案、哪些表、哪些紀錄,以及目前使用者真正擁有怎樣的業務上下文。
QTable 已經開源
如果你對本文討論的資料模型、AI 工作流程或開源工程實踐有興趣,可以直接閱讀程式碼、提交 Issue 或參與貢獻。