
为什么 AI 写操作不能直接落库:QTable 的 Preview → Confirm → Apply
AI 真正进入业务系统后,最危险的并不是答错一句话,而是把一个过期、越权或理解错误的决定直接写进业务数据。本文结合 QTable 当前 Action Plan、版本校验、权限与 ChangeSet 实现,拆解 Preview → Confirm → Apply 为什么应该成为系统边界。
如果 AI 只是在聊天窗口里给建议,答错了通常还有机会改。
但当它开始修改任务负责人、截止日期、状态、依赖关系,甚至批量创建新任务之后,错误就不再只是一段不准确的文字。它会直接进入业务事实。
真正麻烦的地方还不是“模型会不会犯错”。人也会犯错。更棘手的是,AI 做出决定的那个瞬间,和真正写入数据的那个瞬间,并不一定处在同一个世界里。
举个很普通的例子。
10:02,Agent 读取任务 A,发现它还在“进行中”,版本是 12,于是建议把截止日期改到下周一。
10:03,一位同事刚好打开同一条任务,改了状态和截止日期,记录版本变成 13。
10:04,用户回到 AI 面板,看到刚才那条建议,点了确认。
如果系统把“用户确认过”理解成“可以无条件执行”,那条基于 version 12 生成的旧建议就可能覆盖 version 13 的新状态。
这也是 QTable 为什么没有把 AI 写入设计成“模型返回 JSON,然后直接 update database”。
我更希望它遵守一条简单但严格的路径:
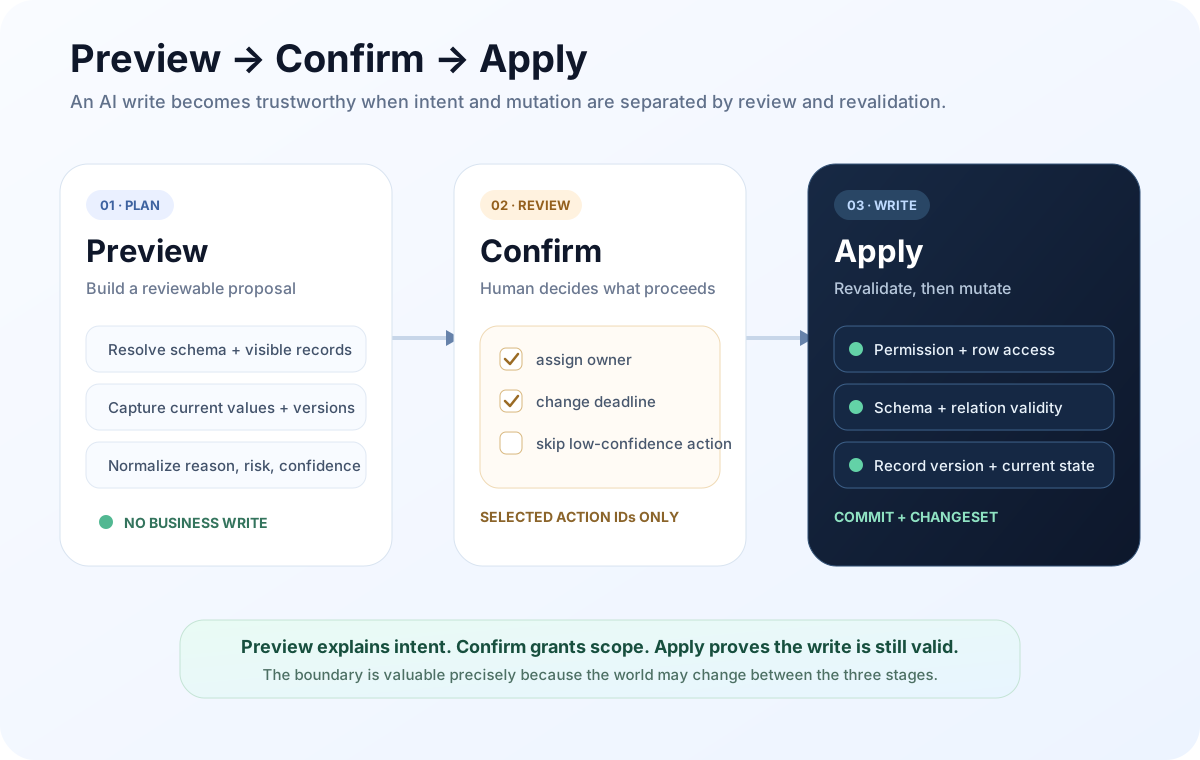
Preview → Confirm → Apply
这三个词看起来像交互流程,但真正重要的是它们背后的系统边界。
Preview 不是“先展示一下”,而是一次没有业务写入的计划生成
很多产品也有 AI Preview,但它经常只是一个 UI 层的预览卡片:模型已经决定要改什么,前端先把结果展示出来,用户点一下按钮,后端照单执行。
这和我理解的 Preview 不是一回事。
QTable 当前的 ai_action_plan.py 在 Preview 阶段会先把建议收敛成结构化 Action Plan。它需要解析当前诊断、目标表、字段定义、用户可见记录和当前 record version,再把每个候选动作规范化成系统可以理解的业务操作。
当前支持的动作包括负责人、优先级、截止日期、状态、标签、依赖和创建任务。对应的请求契约定义在 app/schemas/ai_action_plan.py。
更重要的是:Preview 本身不修改业务记录。
仓库里的测试 tests/test_ai_action_plan.py 专门验证了这一点:生成 Action Plan 之后,Record 数据和版本保持不变,也不会产生业务 ChangeSet,但会保存一份状态为 previewed 的 AiActionPlanBatch。
这份 Preview 不是一段自然语言。它会保留后续 Apply 真正需要的上下文,例如:
- 目标 Table 和 Record;
- 动作类型以及建议值;
- 当前值与建议值;
- 生成建议时看到的 record version;
- 关联字段类型、成员或依赖目标;
- reason、risk warning、confidence;
actionId,用于后续明确选择要执行的动作。
这一步的价值,是把“模型觉得应该这样做”变成“系统可以检查的一份候选变更”。
如果 Preview 只是一张漂亮卡片,却没有保存当时的数据版本、权限范围和具体动作身份,那么后面的 Confirm 其实没有可靠对象可确认。
Confirm 的意义不是“相信 AI”,而是确定写入范围
Confirm 很容易被理解成一句话:用户点了“确认”,所以 AI 可以执行。
这还不够准确。
在 Action Plan 这条链路里,Confirm 更像是人对具体动作集合做选择。QTable 的 Apply 请求接受 planId 和一组 actionIds,也就是说用户可以只放行其中一部分动作,而不是把整个 AI 建议一次性授权。
假设一个计划里有四个动作:
- 把任务 A 交给 Bob;
- 把任务 A 截止日期改到周一;
- 把任务 B 优先级提到高;
- 新建一条回归测试任务。
用户可能认可前三个,但不希望第四个现在创建。
Confirm 应该允许这样的选择,而不是只有“全部接受 / 全部拒绝”。
这里还有一个实现层面的细节值得说清楚:Action Plan 服务本身不需要为了概念完整,硬造一个 confirm() 方法。 在当前实现里,确认结果通过 Apply 请求里的 actionIds 表达;与此同时,QTable 的通用 AI Runtime 也有独立的待确认机制和 /runtime/confirm 路径,用来恢复被确认门拦住的工具执行。
两条机制解决的是相近但不完全相同的问题。它们共同遵守的原则是:有副作用的操作,不能只凭模型意图自动跨过边界。
从 Preview 到 Apply 之间,世界已经可能变了
这是整条链路里最容易被低估的一点。
用户看到 Preview 时,往往会花几秒、几十秒,甚至几分钟判断。有时他还会切回表格核对数据。与此同时,其他用户、自动化、API 或另一个 Agent 都可能继续修改同一批记录。
所以 Confirm 只能说明:
“我认可刚才看到的这个意图。”
它不能自动证明:
“刚才的意图在现在这个状态下仍然成立。”
这两句话差别很大。
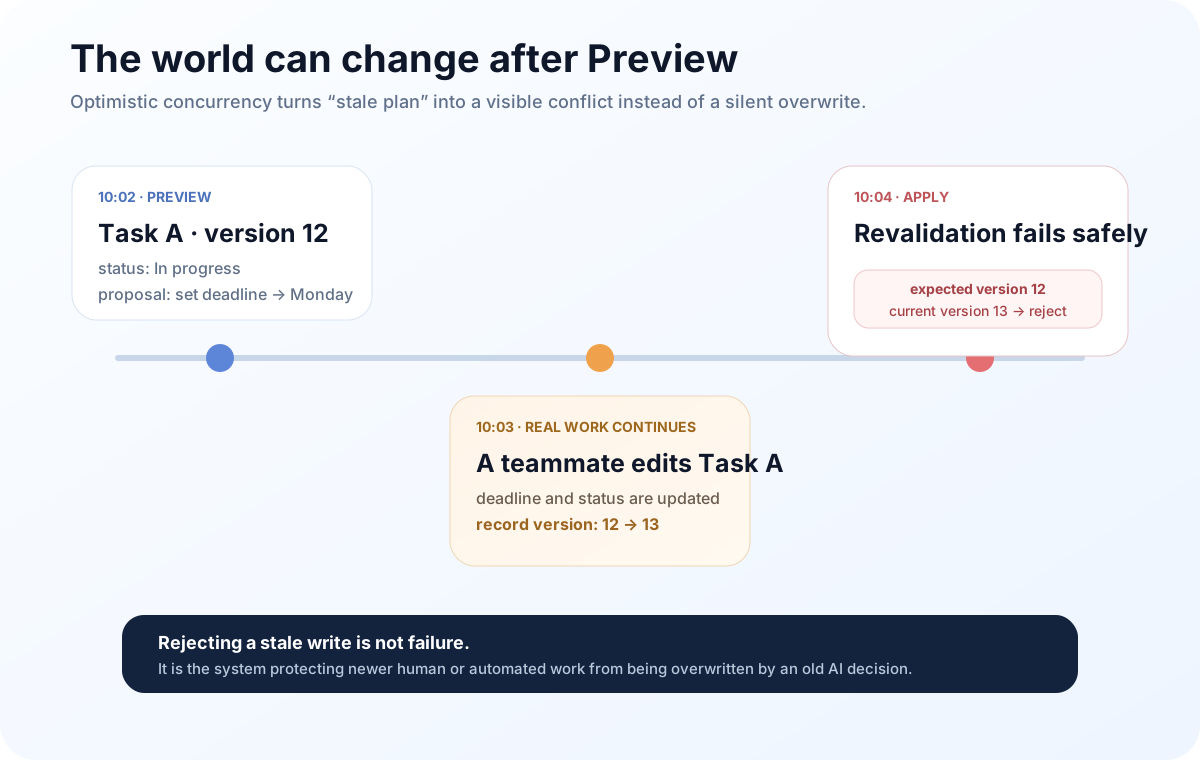
QTable 当前的 TableRecord 有单调递增的 version。Preview 会记录当时的版本;Apply 时重新锁定并读取目标 Record,如果当前版本已经和 Preview 时不同,就拒绝这次写入,要求重新生成 Action Plan。
代码里的错误信息其实很直白:
Record changed after preview; regenerate the Action Plan before applying.
我很喜欢这种失败方式。
它没有试图“聪明地合并”一个已经失去上下文的 AI 决定,也没有静默覆盖新的业务状态,而是承认一个事实:这个计划已经过期。
对于真实工作系统,这种保守往往比自动修复更可靠。
Apply 不是执行 Preview,而是重新证明 Preview 仍然合法
如果只看 UI,Apply 好像就是最后一个“确定”按钮。
但服务端真正需要做的事情比这多得多。
当前 AiActionPlanService.apply 会重新检查目标对象,而不是相信 Preview 阶段的旧结果。至少包括下面这些边界:
| Apply 前重新确认的内容 | 为什么不能沿用 Preview 结果 |
|---|---|
| Table 是否还存在 | 目标可能被删除或移动 |
| 当前用户是否仍有 update 权限 | 权限可能在确认前发生变化 |
| Row-level access 是否仍成立 | 当前记录可能已经不再对用户可见 |
| 成员是否仍属于 Workspace 且可访问任务表 | 负责人资格可能变化 |
| Relation 目标是否仍可访问 | 依赖对象可能删除或权限变化 |
| 字段是否仍存在且类型一致 | Schema 可能被修改 |
| Select / MultiSelect 选项是否仍有效 | 建议值可能已经失效 |
| Record version 是否仍等于 Preview 版本 | 防止覆盖 Preview 之后的新修改 |
注意这里的重点:Apply 不是“再问一次模型”。
真正决定能不能写的是当前业务状态和服务端规则。
这也是为什么我更愿意把 AI Action Plan 看成一种带前置条件的变更提案,而不是一组数据库命令。
冲突应该显式暴露,而不是藏起来
传统 CRUD 里,人们很容易把“写入成功率”当成一个好指标。
但对 Agent 来说,一味追求“只要用户点了确认就尽量成功”反而危险。
如果 Preview 之后:
- 记录被其他人改了;
- 字段从
select改成别的类型; - 某个负责人已经离开 Workspace;
- Relation 指向的对象不再可见;
- 用户的权限被收紧;
那么最安全的结果就是 Apply 被阻止。
QTable 的测试里已经覆盖了多种这种场景:并发修改会阻止 Apply、隐藏行不能进入 Preview、非 Workspace 成员不能被分配、可见的依赖环会在 Preview 被拒绝、过期诊断不能继续生成 Action Plan。
这些测试比“模型在 Demo 里能不能自动改五条任务”更重要,因为它们验证的是 Agent 进入业务系统之后的底线。
写入完成之后,还必须留下足够完整的证据
安全写入不能在数据库 commit 成功那一刻结束。
如果三天后有人问:
“为什么这条任务的负责人变成了 Bob?”
系统至少应该能回答:
- 是谁触发的;
- 是人工、AI 还是自动化;
- 属于哪一个 Action Plan;
- 修改前是什么;
- 修改后是什么;
- 哪些字段发生了变化;
- Record version 从多少变到多少。
QTable 的 change_history.py 提供了 ChangeSet / ChangeItem 这一层。AI Action Plan Apply 成功时,会以 actor_type=“ai”、operation=“ai_action_apply” 写入 ChangeSet,并记录 before / after、version before / after、changed fields 和 trace id。
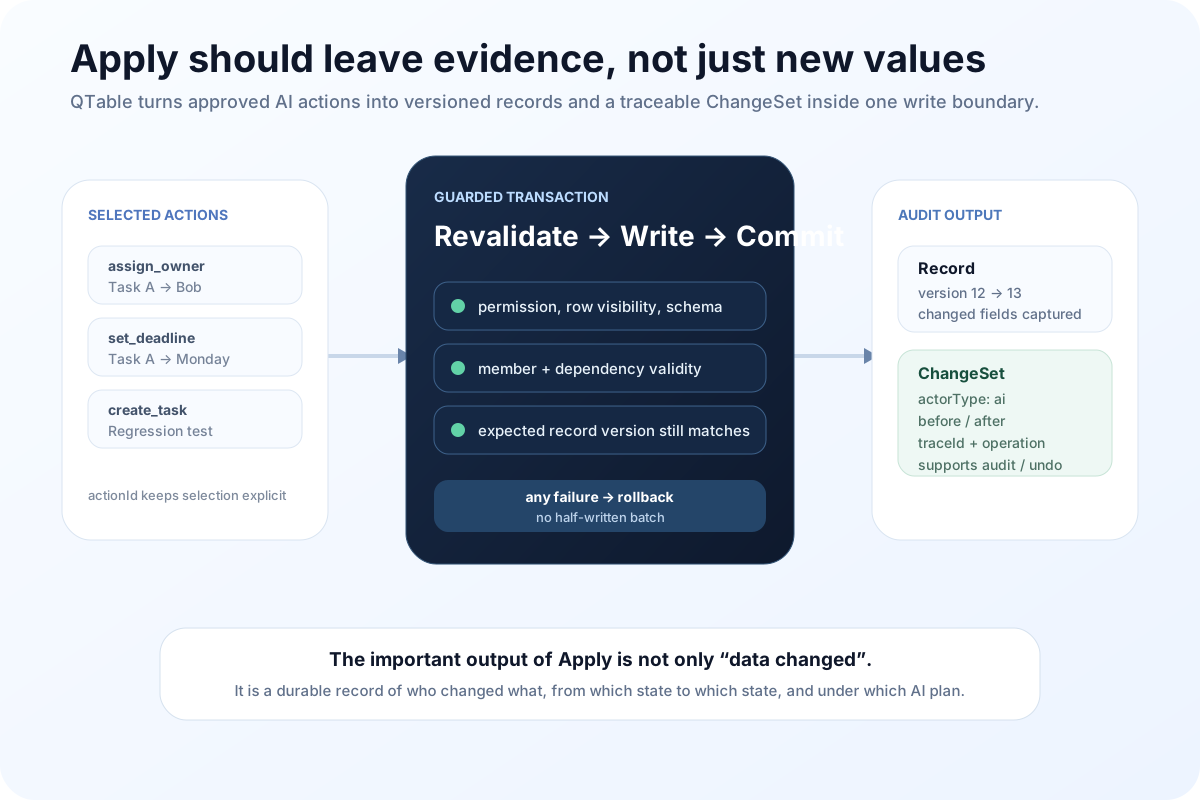
这层记录还有另一个价值:Undo。
但 Undo 只能是最后一道安全网,不能代替 Preview 和 Confirm。
如果 AI 一次批量误改几百条记录,即使技术上可以 Undo,用户仍然需要先发现问题、理解影响,再决定是否回滚。权限泄露、错误通知、下游自动化触发,也不一定能靠一次数据库回滚完全消除。
所以更好的顺序始终是:尽量在写入前阻止错误,写入后仍然保留恢复能力。
Partial Apply 和 Idempotency,是很容易被忽略的工程细节
现实里的确认并不总是“一次把整个计划执行完”。
用户可能只选两条,执行完之后再回来确认第三条。也可能因为网络重试,同一个 Apply 请求被发送两次。
如果系统没有认真处理这些情况,就会产生很奇怪的结果:重复创建任务、重复修改字段,或者第二次 Apply 因为第一次已经增加了 version 而错误地把自己当成并发冲突。
QTable 当前 Action Plan 会记录已经应用的 actionId。再次提交同一组动作时可以识别为 idempotent;部分动作已经成功后,剩余动作仍可以继续应用。批次状态也会区分 previewed、partially_applied、applied 和失败情况。
这类设计不那么“AI”,但它决定了 AI 功能能不能长期待在真实工作流里。
为什么我不想给 AI 一条特殊写入捷径
做 AI 功能时,有一种实现非常诱人:
模型已经给出了明确的目标字段和新值,那就做一套 AI-only mutation,验证几个参数后直接更新数据库。
短期看很快。
长期看,它会产生第二套规则:
- 人工操作走一套权限与校验;
- AI 操作走另一套“为了方便模型”的接口;
- 自动化可能还有第三套。
最后你会发现,同一个 Record 因为入口不同,会得到不同的验证、审计和并发行为。
QTable 现在的方向正好相反。AI Action Plan 最终还是要回到 Workspace / Table / Record / Permission / Relation / Version / ChangeSet 这些共同的产品对象。
AI 可以更会“提出建议”,但不应该拥有一条绕开业务规则的高速通道。
Preview → Confirm → Apply 真正保护的是什么
这套流程保护的并不只是数据。
它保护的是人与 Agent 之间的责任边界。
Preview 让系统把意图说清楚:我要改什么,为什么改,风险是什么。
Confirm 让用户决定范围:这些动作里,哪些是我现在愿意放行的。
Apply 则重新面对现实:在此刻的权限、Schema、Relation 和版本状态下,这些动作还成立吗?
任何一层都不能代替另外两层。
只有 Preview,没有 Apply 前重校验,用户确认的是一份可能已经过期的计划。
只有 Confirm,没有结构化 Preview,用户看到的往往只是“AI 将优化项目”这种无法真正审查的描述。
只有 Apply 和 Undo,没有写入前边界,系统其实是在用回滚能力掩盖缺少控制。
所以对我来说,Preview → Confirm → Apply 不是一个交互设计偏好,而是 AI 真正开始修改业务数据以后必须认真对待的一条执行边界。
下一篇我会继续往前追一个更基础的问题:Preview 里的那份计划,到底是建立在什么 Context 上生成的?
因为安全执行解决的是“AI 怎么写”,而 Context Engine 要解决的是另一半:AI 到底凭什么知道自己正在处理哪个 Workspace、哪个项目、哪些表、哪些记录,以及当前用户真正拥有怎样的业务上下文。
QTable 已经开源
如果你对本文讨论的数据模型、AI 工作流或开源工程实践感兴趣,可以直接阅读代码、提交 Issue 或参与贡献。