
Agent 不是系統管理員:為什麼 QTable 的 Agent 權限不能高於目前使用者
當 AI 能讀表、分析任務、呼叫 Tool,甚至修改業務資料後,最重要的安全邊界之一,不是替 Agent 另外設計一套權限,而是讓它始終受目前使用者權限約束。本文結合 QTable 目前的身份、Workspace / Item Permission、Row Permission、Skill Authorizer、Relation Sanitizer 與 Action Plan Apply 實作,拆解 Agent 權限為什麼只能收窄,不能放大。
上一篇寫 Grid、Kanban、Gantt 時,我最後提到一條邊界:
View 可以變,但權限邊界不能跟著變。
這句話放到 Agent 上更重要。
假設一個使用者在 Workspace 裡只是 Viewer。
他可以看專案進度,但不能修改任務。
這時他打開 AI Assistant,說:
「把所有延期任務重新分配給我,然後把截止日期往後延一週。」
模型完全可能理解這句話。
它甚至能正確找到任務、產生修改方案、選對 Tool。
但系統最後應該做的事情仍然很簡單:拒絕越權寫入。
不是因為模型特別不可信,也不是因為 AI 需要一套特殊的安全規則。
而是因為 Agent 本質上是在代表目前使用者操作產品。
如果一個人自己按按鈕做不到的事情,不能因為換成自然語言,再經過一次模型推理,就突然變成可以做。
所以我認為 AI 真正進入業務系統之後,有一條很重要的權限原則:
Agent 的權限上限,應該是目前使用者的權限,而不是系統技術上能做到什麼。
Agent 首先繼承的是身份,不是能力
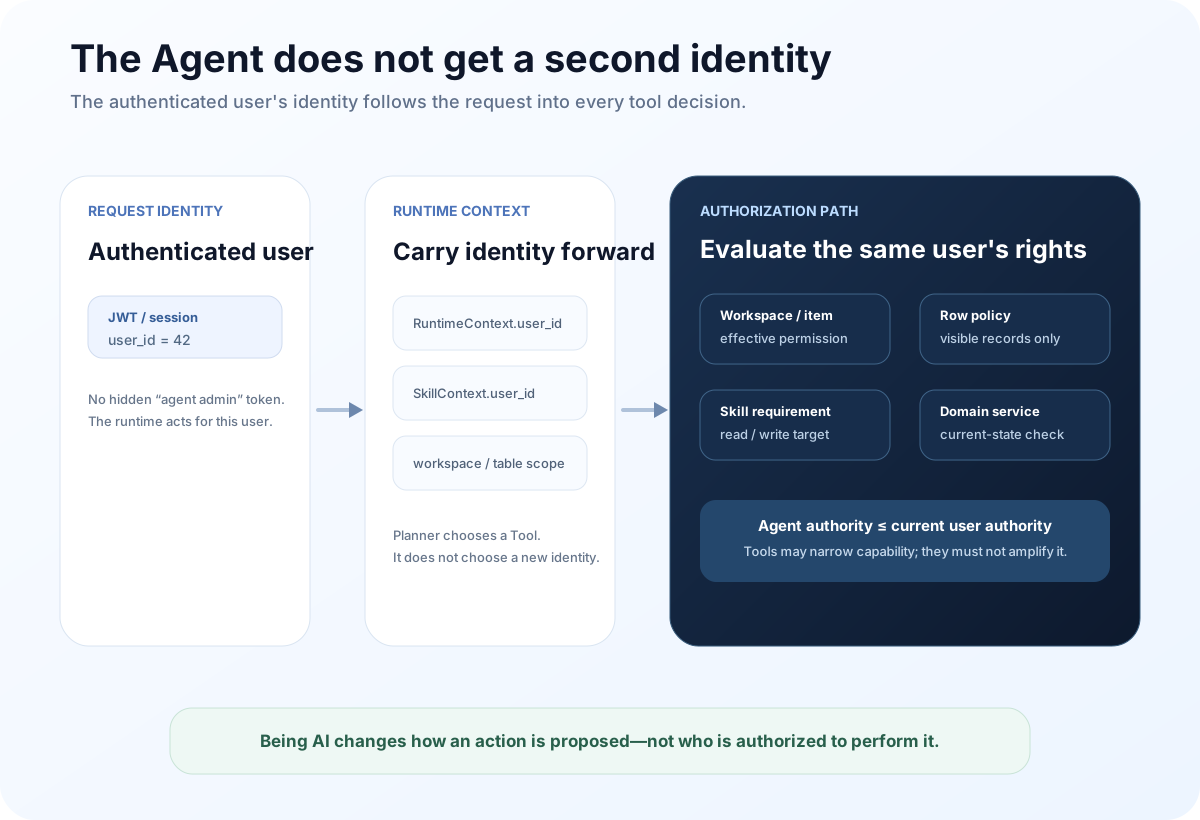
QTable 目前的認證入口會先從 Access Token 解析 user_id,再載入真實 User。
AI 請求進入 Runtime 之後,同一個 user_id 會進入 RuntimeContext。
真正執行某一個 Skill 時,Runtime 又會把同一個使用者 ID 帶進 SkillExecutionContext。
這件事看起來很普通,但它其實決定了後面所有 Permission Decision 的起點。
一個 Tool 不應該收到:
「這是 AI Request,所以請用後台管理員身份執行。」
它應該收到:
「這是 user 42 發起的請求,現在 Agent 代表 user 42 呼叫這個 Skill。」
這兩種模型的安全性完全不同。
前一種設計裡,AI Runtime 自己成了新的 Permission Principal。只要模型能走到某個 Tool,那個 Tool 就可能擁有比使用者更大的能力。
後一種設計裡,AI 只是新的互動和編排層。真正的 Authorization 還是圍繞既有 User、Workspace、Table、Record 發生。
所以我不太贊成替 Agent 建一個權限很大的 Service Account,再靠 Prompt 告訴它「只做使用者有權限做的事」。
Prompt 不是權限系統。
模型也不應該是最後決定 Authorization 的地方。
QTable 的權限不是一個 bool,而是一條逐層收窄的鏈
業務系統裡的權限通常沒有「有 / 沒有」這麼簡單。
QTable 目前至少有幾層會一起決定一個人最後能做什麼。
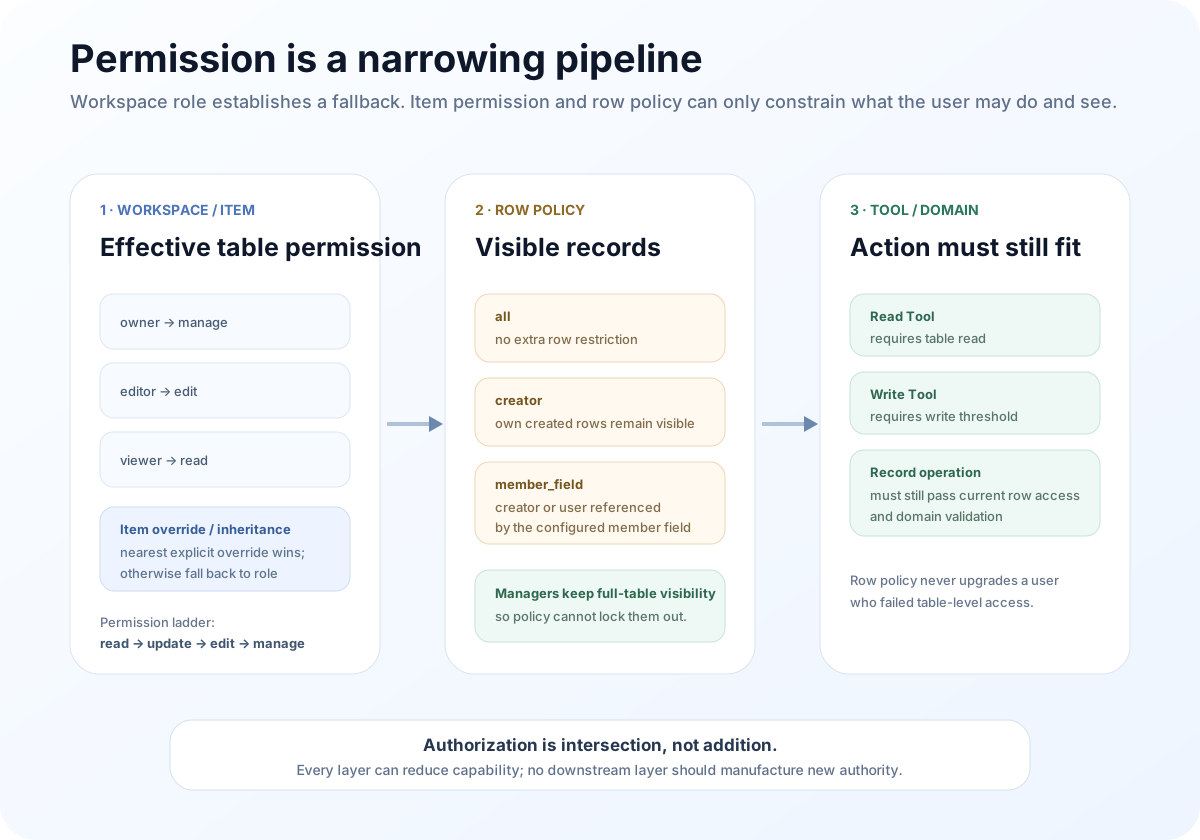
Workspace Member 先提供一個基礎 Role。
目前 Owner 對應 manage,Editor 對應 edit,Viewer 對應 read。
在具體 Workspace Item 上,還可以有單獨的 Permission Override。如果目前 Item 沒有顯式設定,就沿 Parent 往上找;整條繼承鏈都沒有 Override 時,才回退到 Workspace Role。
最後得到 Effective Permission。
目前的 Permission Ladder 是:
read → update → edit → manage
它不是四個彼此獨立的開關,而是一條有順序的能力梯度。
然後 Row Permission 再繼續收窄「這張表裡具體可以看到哪些 Record」。
最後進入 Tool / Domain 層,還要再檢查這次動作本身需要什麼權限。
所以 Authorization 比較像求交集,而不是做加法。
QTable 目前 Row Permission Service 檔案最前面的註解其實把這個原則寫得很清楚:
Row-level Permission 只限制既有的 Table Permission,不會替上層已經拒絕的使用者授權。
我覺得這比單純說「系統支援 RBAC」更能說明設計意圖。
Row Permission 解決的是「同一張表裡,不同人能看到哪些事實」
QTable 目前有三種 Row Permission Mode。
all 不增加額外 Row Restriction。
creator 讓一般使用者看到自己建立的 Record。
member_field 則使用指定的 Member Field 作為可見性規則。Creator 仍然可見,同時欄位裡包含目前使用者的 Record 也可見。
如果目前使用者有 manage 權限,則保留整張表可見,避免 Restrictive Rule 把 Manager 自己鎖在表外。
這裡有兩個小細節,我覺得比 Mode 名稱更重要。
第一,失效的 member_field Rule 對非 Manager 會 fail closed。
如果 Policy 指向的 Member Field 已經不存在,系統不會說「規則壞了,那就先顯示全部」。
這些 Record 仍然不會被視為可見。
第二,一個正在被 Row Permission 使用的 Member Field,不能直接刪除,也不能改成別的 Field Type。
Schema Layer 會要求先改 Row Permission Rule。
這避免一個看似普通的 Schema Change 悄悄破壞 Authorization Semantics。
QTableUI 的 Row Permission 面板也沿用同一條邊界。它支援 all、creator、member_field,而且只有 canManage 才能儲存 Policy。
但前端的 Disabled 狀態從來不等於 Authorization。
UI 只是體驗層。
真正的權限邊界一定要留在 Server,因為任何 Client 都可以繞過按鈕,直接發 Request。
只過濾主表還不夠,Relation 也可能洩漏隱藏資料
Row Permission 最容易遺漏的地方之一,是 Relation。
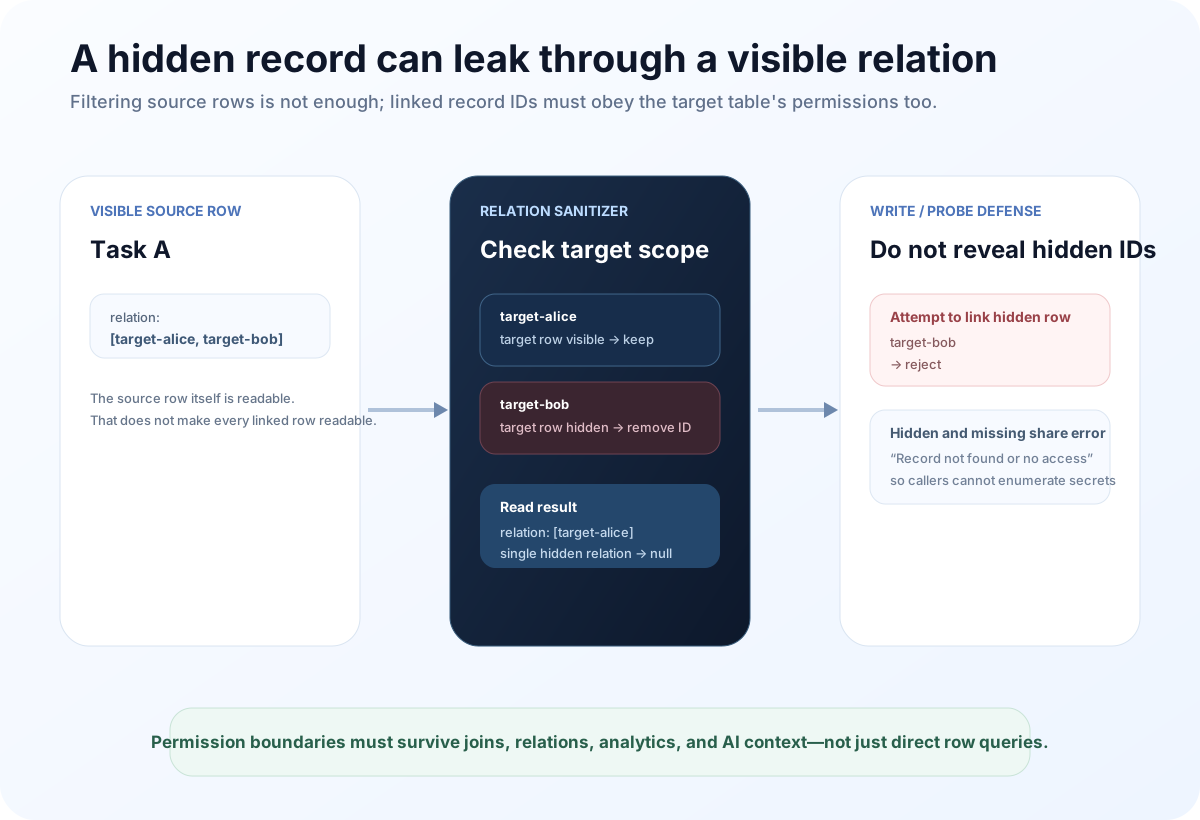
假設 Alice 可以看到 Task A。
Task A 裡的 Relation 原始值是:
[target-alice, target-bob]
Alice 可以讀 target-alice,但沒有權限讀 target-bob。
如果 Backend 只判斷 Task A 可見,然後把整個 Relation Value 原樣回傳,那麼即使沒有回傳 Bob 那條 Record 的 Title 或其他欄位,target-bob 這個 ID 本身也已經洩漏了一個隱藏物件存在的事實。
對 AI 來說,這件事更敏感。
一般 UI 也許只是多露出一個 ID。
模型很擅長把很多小線索拼起來:隱藏 Record ID、Member Name、之前的 Conversation、某個 Aggregate Count。幾個小 Leak 最後可能變成一個不該出現的推論。
所以 QTable 目前的 Row Permission Layer 還有 Relation Sanitization。
對每一個 Relation Field,它會再解析 Target Table 的 Permission Scope。
如果 Target Record 不可見,多選 Relation 會移除對應 ID;單選 Relation 會變成 null。
寫入時也一樣。
如果使用者想把 Relation 指向自己無權存取的 Target Record,操作會被拒絕。
require_record_access 還有一個我很喜歡的細節:不存在的 Record 和「存在但目前使用者看不到」的 Record,刻意回傳同一種錯誤:
Record not found or no access
這樣呼叫方就不能不斷測試 ID,判斷某個隱藏物件到底存不存在。
這是一個很小的實作細節,但它更接近真正的 Authorization Engineering,而不是只做一個 Role Settings Page。
AI 應該在「開始思考以前」就只看到目前使用者可見的資料
很多 AI 權限設計只盯著最後一步:
模型想寫資料時,再檢查能不能寫。
這還不夠。
如果 Bob 的 Private Task 對 Alice 不可見,但 Backend 為了方便,先把整張表交給 Model,最後只禁止 Agent 修改 Bob 的任務,那資料洩漏其實已經發生了。
模型已經看到了。
甚至可能在回答裡重述出來。
所以 Permission Filter 必須發生在 Context 進入模型以前。
QTable 目前的 AI Fallback 路徑裡,_load_table_snapshot 會先解析認證使用者對每張 Table 的 Effective Permission。
沒有 Read,就直接拒絕。
有 Read,再透過 Row Filter 和 Relation Sanitization 建立目前使用者可見的 Store。
最後才套用 100 筆 Record 的 Prompt Limit。
順序很重要。
不是先從整張表拿前 100 筆,再刪掉其中使用者看不到的。
而是先建立目前使用者的可見集合,再從這個集合取 Sample。
Context Engine 也是相同方向。
第四篇提過的 recordCount,在 Database Backend 下是 Permission-aware 的。Row Policy 有限制時,它計算的是目前使用者能看到的 Record 數量。
Task Split、Workload Estimate、Structured Output 等需要載入 Table Context 的 AI 功能,也已經有測試確認 Sample Rows 只會來自目前使用者可見範圍。
Task Management 的延期任務、專案進度、Member Workload、Blocking Task、Delay Prediction 也會把認證使用者的 user_id 傳進 Query。
所以「Agent 不能看更多」不能只靠最後一層 Response Filter。
它必須從業務資料第一次進入 AI Pipeline 的時候就成立。
Tool 本身也要有「我需要什麼權限」的 Contract
上一篇提過,Tool 越多不代表 Agent 越強。
權限也是一樣。
如果 Runtime 只有一張「模型可以呼叫哪些 Function」的清單,很容易把「Function 存在」誤認成「目前使用者有權執行」。
QTable 的 Skill Metadata 已經有 permissions Contract。
讀 Table Schema 的 Skill 會宣告 Table Read Requirement。
Create Record、Create Task Records 這類寫入 Tool 會宣告 Table Write Requirement。
SkillRuntime 真正呼叫 Handler 以前,會先經過 SkillAuthorizer。
Generic Authorizer 會確認 Execution Context 有 User,解析 Target Table,取得這個 User 的 Effective Permission,再跟 Skill Requirement 比對。
只有通過以後,才會進入 Input Validation、Confirmation 判斷和真正 Handler 執行。
這裡我很在意一個順序:
Authorization 在 Confirmation 之前。
沒有權限的使用者不應該收到:
「你確定要執行這個高權限操作嗎?」
而應該直接得到 Forbidden。
Confirm 只代表使用者意圖。
它不能製造 Authority。
目前實作裡,Skill Metadata 的 write Requirement 會在 Generic Authorizer 裡對應到 Table 的 edit Threshold。這個約定之後還可以再細分,但至少執行層已經不是讓 Planner 自己猜「這個人應該可以寫」。
AI 建立的資料,也要知道它代表的是誰
權限繼承還有一個很容易忽略的問題:
Agent 建立出來的 Record,Creator 應該是誰?
如果所有 AI 建立的 Record 都統一寫成「AI」,那 creator Row Permission 很快就失去業務意義。
使用者叫 Agent 建了十條任務,結果自己卻因為「Creator 是 AI」看不到。
QTable 目前的 Create Record Skill 在 Database Path 下會寫入:
created_by_user_id = current user_id
也就是說:
AI 是 Action Source。
目前使用者仍然是 Business Identity。
Audit History 可以記錄 Actor Type 是 AI,但 Ownership、Row Permission、User-scoped History 等需要使用者身份的地方,仍然知道這件事是誰授權發生的。
「由 AI 執行」和「代表 Alice 執行」應該可以同時成立。
Confirmation 不能變成一張長期有效的權限票
這裡需要把前面幾篇串起來。
Context 可以 Cache。
Action Plan 可以 Preview。
使用者可以 Confirm。
但這些都不能變成長期有效的 Authorization Grant。
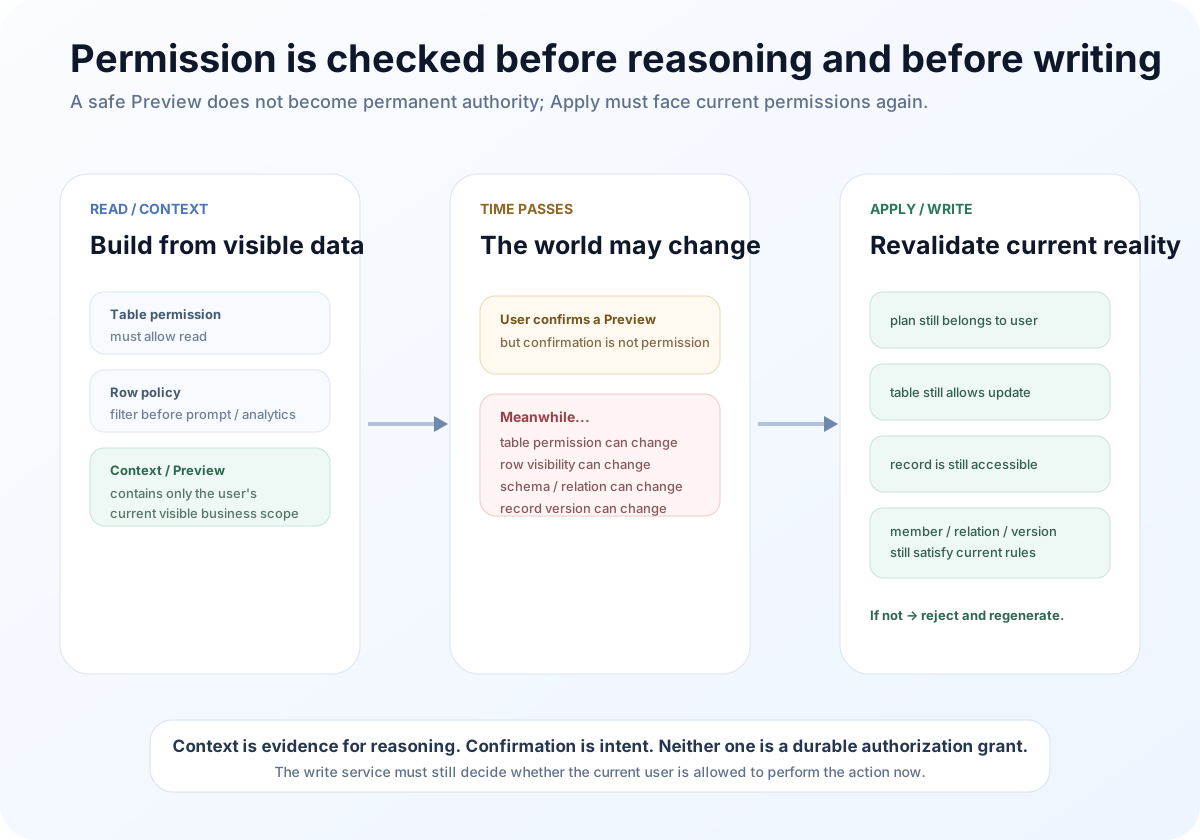
假設 10:00,Alice 對某張 Table 有 Update 權限。
Agent 產生一份 Action Plan。
10:03,管理員把 Alice 降成 Read。
10:04,Alice 回到剛才的 Preview,按下 Confirm。
如果 Apply 只看:
「這份 Plan 三分鐘前合法,而且 Alice 已經確認。」
那系統就把舊 Permission 固化成了一張執行票。
QTable 目前 Action Plan Apply 不會這樣做。
Apply 會用 user_id + plan_id 重新載入屬於目前使用者的 Plan,避免一個人去 Apply 別人的 Plan。
接著對每一張受影響的 Table 重新計算目前 Effective Permission,要求現在仍然具備 Update。
每一條要修改的 Record 再透過 require_record_access 檢查一次。
Relation Target、Member Assignment、Field Definition 和 Record Version 也會在真正寫入前重新驗證。
這和第三篇談 Record Version 是同一類問題。
資料會變。
權限也會變。
Preview 階段合法,不代表 Apply 階段還合法。
「模型沒有看到」需要靠測試證明,不是靠相信
AI 系統的 Permission Bug 很容易藏在旁路。
主要頁面可能正確 Filter Record,但 Fallback Analyzer 直接讀了 Full Store。
Context Builder 可能自己算 Count。
Analytics Tool 可能走另一套 Query。
Relation、Dashboard、Historical Learning、Cache 又可能各自多一條 Read Path。
所以我覺得權限測試最好直接圍繞資訊邊界來寫。
QTable 目前已經有幾類很值得保留的測試。
Alice 和 Bob 在同一張表,Row Policy 使用 Creator Mode 時:
AI fallback snapshot 只能出現 Alice 的 Row。
Context Builder 的 record count 只能反映 Alice 的可見範圍。
Describe Table 的 Sample Rows 只能包含 Alice 的資料。
Task Split、Workload、Structured Output 的 Table Context 只能使用 Alice 可見的 Sample。
Task Management Analytics 不能把 Bob 的 Private Task 算進 Alice 的 Overdue、Progress、Workload、Blocker 和 Delay Result。
即使 Source Relation Row 可見,也不能回傳 Bob 的 Hidden Target ID。
AI 產生的歷史結果與 Cache Key 也要依 User Scope 隔離,Alice 不能讀取 Bob 的 Task Split 或 Workload Result。
這些測試比一句「Agent respects permissions」更有意義。
因為它們真正定義了:
哪些資訊絕對不能進入另一個使用者的 AI Context。
目前權限實作還有幾個需要繼續收斂的邊界
這一篇也不應該寫成「Authorization Layer 已經全部完成」。
還有幾個地方值得繼續做。
第一,Generic Skill Authorizer 目前主要真正落實的是 Table Permission。
Permission Contract 已經可以描述 table、workspace、skill、marketplace 等 Resource,但目前 Common Authorizer 對非 Table Requirement 還沒有統一 Enforcement。
也就是說,Contract 的表達能力已經比 Generic Enforcement 更寬。
之後 Workspace / Skill Scope 應該繼續收斂到同一個 Policy Enforcement Layer,而不是依賴不同 Handler 各自補判斷。
第二,Row Permission 目前是 Database Backend 的能力。
AI Snapshot 和 Context Builder 在 DB Path 下會走 Table ACL + Row Policy;Legacy File Backend 則刻意保留舊行為,程式碼沒有假裝 File Store 也擁有 Database ACL。
這個 Boundary 應該保持明確。
真正面向多使用者和 Agent 的 Production Deployment,應該以 Database-backed Permission Model 作為 Security Baseline。
第三,現在有多條執行路徑會重複做相似的 Permission Check。
Context Builder 會檢查。
AI Fallback Loader 會檢查。
Skill Authorizer 會檢查。
Action Plan Apply 又會再檢查一次。
這裡有一部分重複是正確的,因為 Read-time Filtering 和 Write-time Revalidation 本來就應該發生在不同時刻。
但 Policy Decision 怎麼表達、怎麼記錄、怎麼解釋拒絕原因,仍然可以繼續統一。
我更希望未來是一套穩定 Authorization Contract 被不同 Layer 共用,而不是每新增一種 Agent Workflow,就再手寫一套很像的邏輯。
第四,Authorization Decision 本身也值得更好的 Observability。
QTable 已經有 Trace、Tool Event 和 ChangeSet。
下一步可以繼續補:
某個 Step 為什麼 Forbidden。
當時算出的 Effective Table Permission 是什麼。
哪一條 Row Policy 排除了這個 Record。
Apply 為什麼在 Permission Change 之後拒絕。
這些資訊不能洩漏 Hidden Data 給無權限使用者,但對 Security Audit 和 Administrator Debug 很重要。
AI Native 不應該等於 AI Privileged
做 AI 功能時,很容易自然形成一些危險捷徑。
一般 UI 走 REST / GraphQL Permission。
AI 為了「Context 更完整」,直接讀 Database。
一般使用者寫入要過 Row Permission。
Agent 為了「自動完成流程」,改用 Internal Service Account。
一般頁面不能看到某些 Relation。
模型為了「回答完整」,先拿 Full Dataset 再說。
短期看,這些做法會讓 Demo 很順。
長期看,它們會在產品底層形成兩套世界:
一套是使用者被允許看到的系統。
另一套是 AI 實際能看到和修改的系統。
一旦兩套不一致,使用者很難再相信 Agent。
所以我更喜歡一條很簡單的規則:
Agent Authority ≤ Current User Authority
如果要寫得更嚴格一點:
Executable Capability = Current User Permission ∩ Tool Permission ∩ Row Scope ∩ Current Business Constraints
Agent 可以更少。
某個 Workflow 可以只讀。
某個 Workspace 可以關掉某個 Skill。
危險操作可以要求額外 Confirm。
這些都會繼續縮小能力。
但「因為這是 AI」不應該把權限上限往上抬。
真正的安全感來自「使用同一套規則」
如果使用者在 Grid 看不到某條 Record,那 AI Context 裡也不應該出現。
如果使用者不能手動修改某張 Table,Tool 也不能繞過。
如果 Relation Target 被隱藏,Agent 不應該拿到它的 ID。
如果 Preview 之後權限被收回,Confirm 不能把舊權限復活。
如果 AI 建立一條 Record,系統仍然要知道它代表的是哪個使用者。
這些行為放在一起,才真正構成「Agent 權限不能高於目前使用者」。
它不是一個單獨的 if role == viewer。
它要求 Identity、Context、Tool、Relation、Analytics、Mutation 和 Audit History 共用同一條 Authorization Boundary。
這也是第七篇最想留下的結論:
Agent 不應該成為產品裡的 Superuser。它應該成為目前使用者既有能力的一種新介面。
第七篇寫的是「AI 被允許做什麼」。
下一篇我會把視角移到 Open Source Engineering:當一個 AI Native 系統可以執行程式碼、呼叫 Tool、處理業務資料時,發布出去之後,別人憑什麼相信 Binary、Container Image 和 Dependency 真的是從他看到的 Source Code 建出來的?
這會進入 CI、SBOM、Provenance 和 Software Supply Chain Trust。
QTable 已經開源
如果你對本文討論的資料模型、AI 工作流程或開源工程實踐有興趣,可以直接閱讀程式碼、提交 Issue 或參與貢獻。