
Agent 不是系统管理员:为什么 QTable 的 Agent 权限不能高于当前用户
AI 能读表、分析任务、调用 Tool,甚至修改业务数据之后,最重要的安全边界之一不是给 Agent 单独设计一套权限,而是让它始终受当前用户权限约束。本文结合 QTable 当前身份、Workspace / Item Permission、Row Permission、Skill Authorizer、Relation Sanitizer 和 Action Plan Apply 实现,拆解 Agent 权限为什么只能收窄,不能放大。
上一篇写 Grid、Kanban、Gantt 时,我最后提到一个边界:
View 可以变,但权限边界不能跟着变。
这句话放到 Agent 上更重要。
假设一个用户在 Workspace 里只是 Viewer。
他可以看到项目进度,但不能修改任务。
这时候他打开 AI Assistant,说:
“把所有延期任务重新分配给我,然后把截止日期顺延一周。”
模型完全可能理解这句话。
它甚至可以正确找到任务、生成修改方案、选好 Tool。
但系统最终应该做的事情仍然很简单:拒绝越权写入。
不是因为模型“不够可信”,也不是因为 AI 需要一套特殊的安全规则。
而是因为 Agent 本质上是在替当前用户操作产品。
如果一个人自己点按钮做不到的事,不能因为换成自然语言,再经过一次模型推理,就突然变成可以做。
这也是我认为 AI 进入业务系统以后最重要的一条权限原则:
Agent 的权限上限,应该是当前用户的权限,而不是系统能够做到什么。
Agent 首先继承的是身份,不是能力
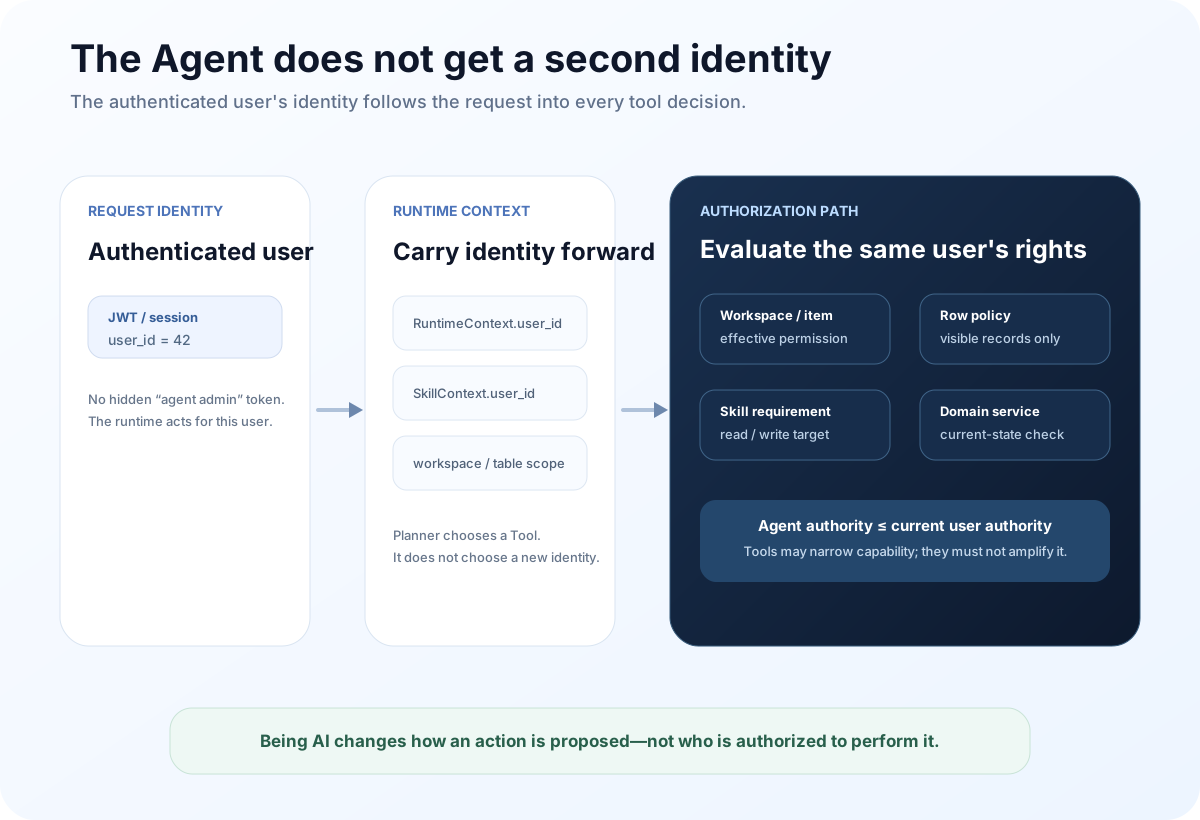
QTable 当前的认证入口会先从 Access Token 里解析 user_id,再加载真实 User。
AI 请求进入 Runtime 后,这个 user_id 会继续进入 RuntimeContext。
真正执行某一个 Skill 时,Runtime 又会把同一个用户 ID 写进 SkillExecutionContext。
这件事看起来很普通,但它其实决定了后面所有权限判断的出发点。
一个 Tool 不应该收到:
“这是 AI 请求,所以请用后台管理员身份执行。”
它应该收到:
“这是 user 42 发起的请求,现在 Agent 正在代表 user 42 调用这个 Skill。”
这两种模型的安全性质完全不同。
前一种设计里,AI Runtime 自己成了权限主体。只要模型能走到某个 Tool,Tool 就可能拥有比用户更大的能力。
后一种设计里,AI 只是新的交互和编排层。真正的 Authorization 仍然围绕现有 User、Workspace、Table、Record 发生。
这也是为什么我不太赞成给 Agent 单独造一个“万能 Service Account”,然后依靠 Prompt 约束它“只做用户有权限做的事”。
Prompt 不是权限系统。
模型也不应该负责判断最终 Authorization。
QTable 的权限不是一个 bool,而是一条逐层收窄的链
业务系统里的权限通常没有“有 / 没有”这么简单。
QTable 当前至少有几层会一起决定一个人最终可以做什么。
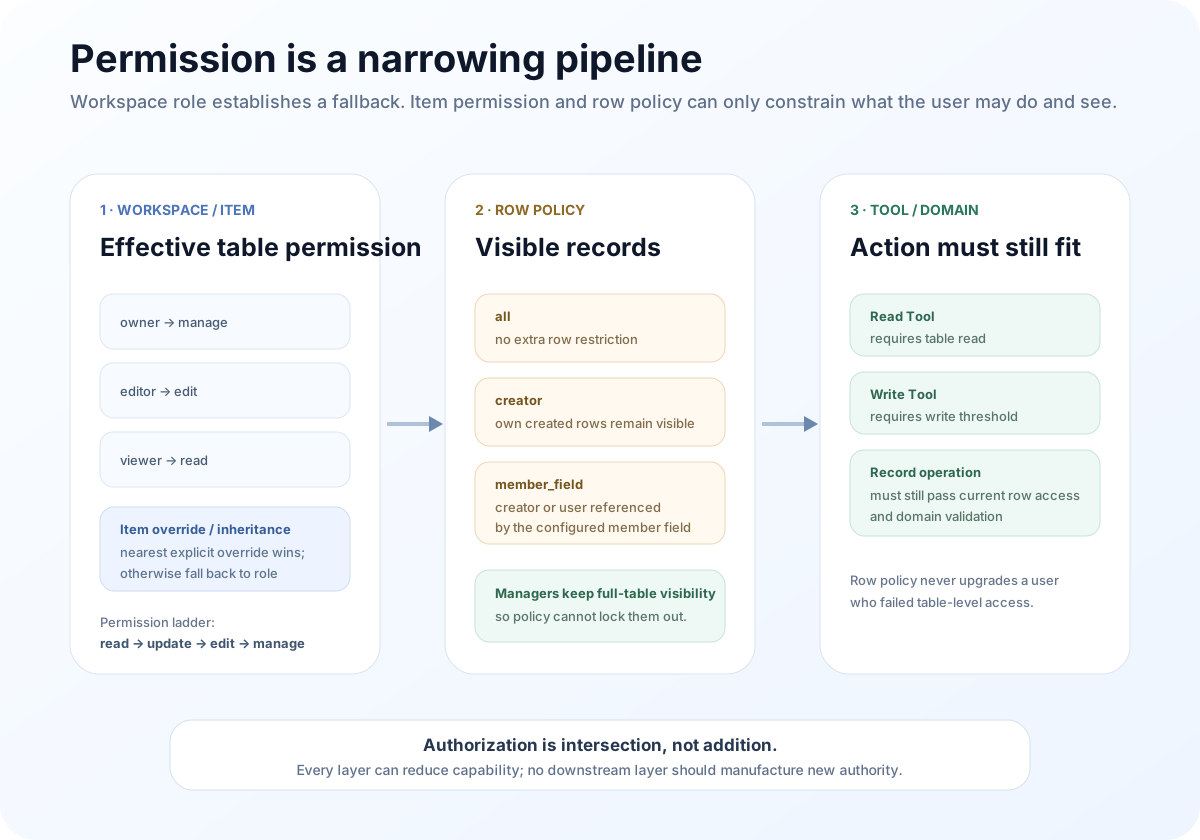
Workspace Member 先提供一个基础角色。
目前 Owner 对应 manage,Editor 对应 edit,Viewer 对应 read。
在具体 Workspace Item 上,还可以有单独的 Permission Override。如果当前 Item 没有显式配置,就沿 Parent 往上找;整条继承链都没有 Override 时,才回退到 Workspace Role。
最终得到一个 Effective Permission。
当前权限等级是:
read → update → edit → manage
它不是四个彼此独立的开关,而是一条有序能力梯度。
然后 Row Permission 再继续收窄“在这张表里具体能看哪些 Record”。
最后到了 Tool / Domain 层,还要检查这次动作本身需要的能力。
所以权限更像一个交集,而不是加法。
这个“只能收窄,不能放大”的原则,在 row_permissions.py 的文件注释里其实写得很直白:
Row-level Permission 只限制已经存在的 Table Permission,永远不会替一个原本没有访问权限的人授予访问。
我觉得这句比“支持 RBAC”更能说明设计意图。
Row Permission 解决的是“同一张表里,不同人看到不同事实范围”
QTable 当前的 Row Permission 有三种模式。
all 不增加额外限制。
creator 允许普通用户看到自己创建的 Record。
member_field 则使用某个 Member Field 作为可见性规则:创建者仍然可见,同时字段中包含当前用户的 Record 也可见。
如果当前用户拥有 manage 权限,则保留整表可见性,避免管理员被错误配置的 Row Rule 锁在表外。
这里还有两个小细节,我觉得比模式名字更重要。
第一,失效的 member_field 规则对非 Manager 会 fail closed。
如果 Rule 指向的 Member Field 已经不存在,系统不会说“那就先把所有行放出来”。
它会拒绝把这些 Record 当成可见。
第二,一个正在被 Row Permission 使用的 Member Field,不能直接被删除,也不能被改成非 Member 类型。
这避免了 Schema 变化悄悄破坏权限语义。
从 UI 上看,QTableUI 的 Row Permission 面板同样只有 canManage 时才能保存规则。Viewer 或普通 Editor 可以看到当前配置,但不能因为前端有一个 Modal 就改变权限。
不过前端的 disabled 状态始终只是体验层。
真正的权限边界必须在 Server。
任何人都可以绕过按钮直接发请求,所以“按钮灰了”从来不能算 Authorization。
只过滤主表还不够,Relation 也可能泄露数据
Row Permission 最容易遗漏的地方不是直接查询 Record,而是 Relation。
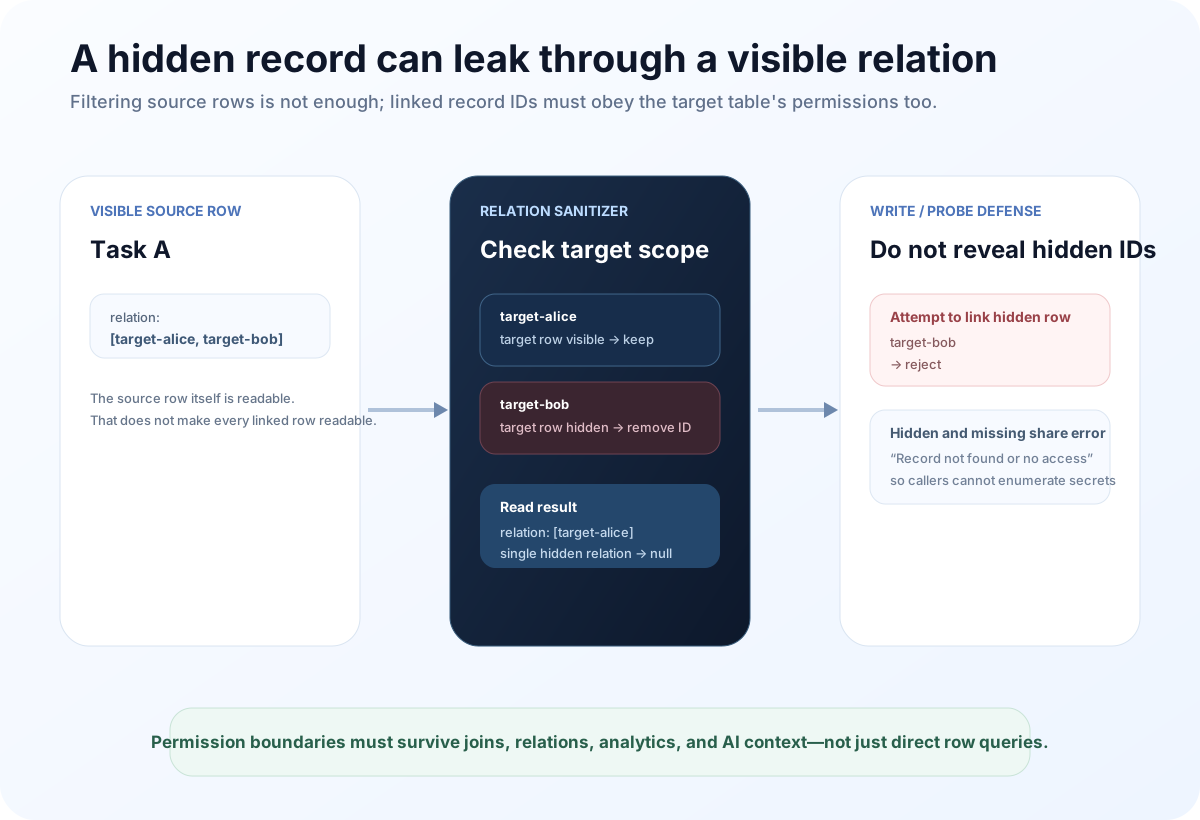
假设 Alice 能看到任务 A。
任务 A 里有一个关联字段,原始值是:
[target-alice, target-bob]
Alice 对 target-alice 有权限,但对 target-bob 没有。
如果系统只判断“任务 A 可见”,然后把整个 Relation Value 原样返回,那么即使没有返回 Bob 那条 Record 的标题、内容或字段,target-bob 这个 ID 本身也已经泄露了一个隐藏对象存在的事实。
这对 Agent 尤其危险。
普通页面也许只是不小心暴露一个 ID。
AI 很擅长把多个小线索组合起来。一个隐藏 Record ID、一个成员名字、一段历史对话,最后可能拼出不应该被当前用户知道的信息。
所以 QTable 当前的 Row Permission 层还有 sanitize_relation_values_for_user。
它会对 Relation Field 的目标 Table 再走一次权限检查。
目标 Record 不可见时,多选 Relation 里对应 ID 被删掉;单选 Relation 则变成 null。
写入时也一样。
如果当前用户尝试把 Relation 指向一个自己无权访问的目标 Record,QTable 会拒绝。
更重要的是,require_record_access 对“Record 不存在”和“Record 存在但你看不到”使用同一个错误:
Record not found or no access
这样调用方不能通过不停试 ID,判断某个隐藏对象是否存在。
这是一个很小的实现细节,但我认为它属于真正的权限工程,而不只是角色管理页面。
AI 在“思考之前”就应该只看到当前用户可见的数据
很多 AI 权限设计只关注最后一步:
模型要写数据时,再判断有没有权限。
这还不够。
如果一个用户没有权限看 Bob 的私有任务,但系统为了方便,把整张表都塞进 Prompt,最后只是禁止 Agent 修改 Bob 的任务,那么数据泄露其实已经发生了。
模型已经看到了。
甚至可能在回答中复述出来。
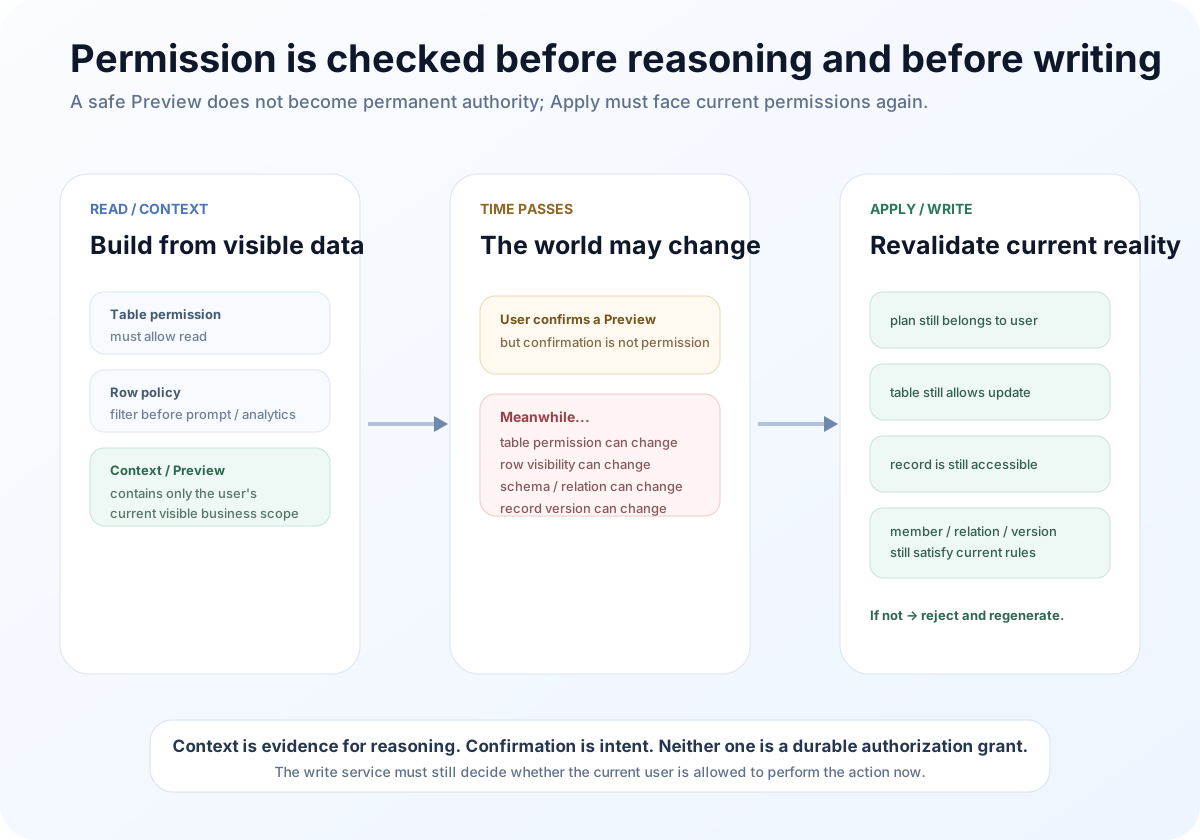
所以权限检查必须发生在 Context 进入模型之前。
QTable 当前 AI fallback 路径里的 _load_table_snapshot 会先取得当前用户对每张 Table 的 Effective Permission。
没有 Read,直接拒绝。
有 Read,再通过 filter_store_for_user 套用 Row Permission 和 Relation Sanitization。
最后才做 100 条 Record 的 Prompt Limit。
这个顺序很重要。
不是先从整表取 100 条,再把其中用户看不到的删掉。
而是先得到当前用户的可见集合,然后在这个集合里截取样本。
Context Engine 也是同样的方向。
前面第四篇写过 recordCount。这个数字在数据库后端下不是整表总数,而是 Row Permission 过滤之后的可见 Record 数量。
Task Split、Workload Estimate、Structured Output 等需要读取 Table Context 的 AI 功能,也都已经有对应测试,确认 Sample Rows 只来自当前用户可见范围。
Task Management 的延期任务、项目进度、成员工作量、阻塞任务、延期预测同样把认证用户的 user_id 一路传进数据库查询。
所以“Agent 不能看到更多”不是只靠一个最终 Response Filter。
它要从数据进入 AI Pipeline 的第一刻就成立。
Tool 本身也要声明“我需要什么权限”
第五篇里我写过,Tool 越多不代表 Agent 越强。
权限也是同一个问题。
如果 Runtime 只是维护一张“模型可以调用的函数列表”,那么“能调用”很容易被误解成“有权执行”。
QTable 的 Skill Metadata 里已经有 permissions。
例如读取 Table Schema 的 Skill 声明 Table Read Requirement。
创建 Record、批量创建任务 Record 这类写操作声明 Table Write Requirement。
Skill Runtime 每次真正 Invoke 之前,会先经过 SkillAuthorizer。
它检查:
当前 Execution Context 有没有 User。
目标 Table 是哪一个。
当前用户对这个 Table 的 Effective Permission 是多少。
这个 Permission 是否达到 Skill 需要的级别。
只有通过以后,才进行 Input Validation、Confirmation 判断和真正 Handler 调用。
这里我特别喜欢一个顺序:
Authorization 在 Confirmation 之前。
也就是说,一个没有权限的用户不会得到:
“你确认要执行这个高权限操作吗?”
而是直接 Forbidden。
因为“用户确认了”从来不是权限来源。
确认只表达意图,不能创造权限。
当前实现里,Skill Metadata 的 write Requirement 会被 Generic Authorizer 映射到 Table 的 edit 阈值。这个约定后续还可以继续细分,但至少执行层已经不是让 Planner 自己判断“这个用户应该可以写”。
Agent 创建的数据,也应该留下“是谁创建的”
权限继承还有一个经常被忽略的问题:
AI 创建出来的 Record,Creator 到底是谁?
如果统一写成 “AI”,那么 creator Row Permission 很快就会失去业务意义。
用户让 Agent 建了十条任务,之后自己却因为“创建者是 AI”看不到。
QTable 当前的 Create Record Skill 在数据库路径下会把:
created_by_user_id = current user_id
写到 Record。
也就是说:
Agent 是动作来源。
当前用户仍然是业务身份。
审计里可以记录 actor type 是 AI,但 Row Permission、Ownership、历史学习范围这些需要用户身份的地方,仍然应该知道这件事是谁授权发生的。
这两个概念不冲突。
“由 AI 执行”和“代表 Alice 执行”应该可以同时成立。
Confirmation 永远不能变成一张长期有效的权限票
这里需要把第二、三、四篇串起来。
Context Engine 会缓存。
Action Plan 会 Preview。
用户会 Confirm。
但这些东西都不能被当成长期有效的 Authorization Grant。
假设 10:00,Alice 对一张表有 Update 权限。
Agent 生成 Action Plan。
10:03,管理员把 Alice 降成 Read。
10:04,Alice 回到面板,点下刚才那份 Plan 的 Confirm。
如果 Apply 只看:
“这份 Plan 是三分钟前生成的,而且 Alice 确认过。”
那么系统就把过期权限固化成了执行票据。
QTable 当前 Action Plan Apply 没有这样做。
Apply 会先按 user_id + plan_id 重新读取属于当前用户的 Plan。
然后对受影响的每张 Table 重新计算 Effective Permission,要求当前仍然具备 Update。
对每一个要改的 Record 再执行 require_record_access。
Relation Target、Member Assignment、Field、Record Version 等后续条件也会重新验证。
这和第三篇写 Record Version 的逻辑是同一类问题。
数据会变。
权限也会变。
所以 Preview 阶段合法,不代表 Apply 阶段仍然合法。
“模型没看见”要靠测试证明,而不是靠相信
权限系统很容易有一种错觉:
页面上看起来正常,就代表 AI 也走了同样的权限边界。
实际上 AI 往往有很多旁路。
Fallback Analysis 可能直接读 Store。
Context Builder 可能自己查 Count。
Analytics Tool 可能走一套单独 Query。
Relation、Dashboard、History Cache 又可能有自己的读取逻辑。
所以我觉得权限相关测试应该尽量贴近“数据有没有真的越界”。
QTable 当前已经有几类值得保留的测试。
Alice 和 Bob 在同一张表里,Row Policy 使用 Creator 模式时:
AI fallback snapshot 里只能出现 Alice 的 Row。
Context Builder 的 record count 只能是 Alice 可见的数量。
Describe Table Skill 的 Sample Rows 只能出现 Alice 的 Row。
Task Split / Workload / Structured Output 的 Table Context 只能拿到 Alice 的 Row。
Task Management Analytics 不能把 Bob 的私有任务算进 Alice 的延期、进度、工作量和风险分析。
Relation Source Row 即使可见,也不能返回 Bob 的隐藏 Target ID。
AI 生成的历史结果和 Cache Key 也按 User Scope 隔离,Alice 不能读取 Bob 的 Task Split / Workload Result。
这些测试比一句“Agent respects permissions”有价值得多。
因为它们直接定义了:
哪些数据绝对不能进入另一个用户的 AI 上下文。
当前权限实现还有几处没有完全收敛
这一篇也不应该写成“权限模型已经彻底完成”。
还有几个边界我认为需要继续处理。
第一,Generic SkillAuthorizer 目前主要落实的是 Table Permission。
Skill Permission Contract 已经可以表达 table、workspace、skill、marketplace 等 Resource,但当前通用 Authorizer 对非 Table Requirement 还没有统一执行。
这意味着 Contract 已经比 Enforcement 更宽。
后续应该把 Workspace / Skill Scope 也收敛到同一个 Policy Enforcement 层,而不是依赖每个 Handler 自己补判断。
第二,Row Permission 当前是数据库后端能力。
AI Snapshot 和 Context Builder 在 DB Backend 下会认真走 Table ACL + Row Policy;Legacy File Backend 仍保留旧行为,而且代码明确没有假装 File Store 拥有数据库 ACL。
这个边界必须保持诚实。
真正面向多用户和 Agent 的生产部署,权限安全模型应该以数据库后端为基线。
第三,现在有多条路径在重复做类似的权限判断。
Context Builder 会检查。
AI fallback loader 会检查。
SkillAuthorizer 会检查。
Action Plan Service 又会检查。
这种重复有它的必要性,因为读时过滤和写时重校验本来就应该发生两次。
但其中“如何计算 Effective Permission、如何表达 Policy Decision、如何记录拒绝原因”仍然可以进一步统一。
我更希望未来看到一个稳定的 Authorization Contract 被这些层共同调用,而不是每增加一种 Agent Workflow,就重新手写一套相似判断。
第四,权限本身也应该进入 Observability。
现在已经有 Trace、Tool Event、ChangeSet。
下一步值得继续补的是:
某个 Step 为什么被 Forbidden。
当时计算出的 Table Permission 是什么。
是哪一层 Row Policy 把 Record 排除。
Apply 为什么因为权限变化而拒绝。
这些信息不能泄露给无权限用户,但对安全审计和管理员排障非常重要。
AI Native 不应该意味着“AI 特权”
很多产品做 AI 功能时,会自然形成一个危险的捷径。
普通用户操作走 REST / GraphQL 权限。
AI 为了“更聪明”,直接读数据库。
普通用户写入要校验 Row Policy。
Agent 为了“自动完成任务”,走一个内部 Service Account。
普通页面不能看到某些 Relation。
模型上下文为了“回答更完整”,先把全部数据读出来再说。
短期看,这些捷径会让 AI Demo 很顺。
长期看,它们会让产品出现两套事实:
一套是用户被允许看到的系统。
另一套是 AI 实际能看到和做到的系统。
这两套一旦不一致,用户就很难再相信 Agent。
所以我现在更愿意把 Agent Authority 写成一个非常简单的不等式:
Agent Authority ≤ Current User Authority
如果还要再严格一点,可以继续加上:
实际可执行能力 = 当前用户权限 ∩ 当前 Tool 权限 ∩ 当前 Row Scope ∩ 当前业务约束
Agent 可以少做。
例如某个 Workflow 只允许它读取,不允许它修改。
某个 Workspace 可以禁用某些 Skill。
某个危险操作必须额外 Confirm。
这些都会继续缩小能力。
但它不应该因为“这是 AI”,把能力往上抬。
真正的安全感来自“同一套规则”
如果一个用户在 Grid 里不能看某条 Record,那么 AI Context 里也不应该出现。
如果用户不能手动编辑某张表,Agent 也不能通过 Tool 修改。
如果一个 Relation Target 对用户隐藏,Agent 不能拿到它的 ID。
如果权限在 Preview 之后被收回,Confirm 不能把旧权限复活。
如果 AI 创建了一条 Record,系统仍然知道它代表的是哪个用户。
这几件事放在一起,我觉得才构成“Agent 权限不高于当前用户”的完整含义。
它不是一个单独的 if role == viewer。
它要求身份、Context、Tool、Relation、Analytics、写入和审计都共享同一条 Authorization Boundary。
这也是这一篇最想留下的结论:
Agent 不应该成为产品里的超级用户。它应该成为当前用户能力的一种新接口。
第七篇写的是“AI 被允许做什么”。
下一篇我会把视角移到开源工程本身:一个可以执行代码、调用 Tool、处理业务数据的 AI Native 系统,发布出来以后,别人凭什么相信这些二进制、镜像和依赖真的来自这份源码?
这会进入 CI、SBOM、Provenance 和供应链信任。
QTable 已经开源
如果你对本文讨论的数据模型、AI 工作流或开源工程实践感兴趣,可以直接阅读代码、提交 Issue 或参与贡献。