
Grid、Kanban、Gantt 不應該各存一份資料:QTable 的 View 為什麼只是同一事實的不同投影
同一條任務在 Grid 裡是一列,在 Kanban 裡是一張卡片,在 Gantt 裡是一段時間條。真正困難的不是把三個介面都畫出來,而是讓它們始終操作同一條 Record。本文結合 QTable 目前的 TableRecord、TableView、BoardCardOrder 與 QTableUI 多視圖實作,拆解業務狀態和視圖狀態該如何分開,以及目前仍需要繼續收斂的一致性邊界。
上一篇寫 Multi Tool Chain Runtime 時,我談的是一件偏「過程」的事:Agent 要怎麼把多個 Tool 組織成一條可以控制的執行鏈。
但一條工作鏈跑完以後,結果最後還是會回到產品裡。
有人會在 Grid 裡看它,專案經理會在 Kanban 裡拖它,另一個人可能在 Gantt 裡調整開始時間。Automation 會在背景更新狀態,Agent 也可能直接修改同一個業務物件。
這時有一個看起來很普通、其實很決定產品上限的問題:
Grid、Kanban、Gantt 到底是不是三套資料?
如果答案是「是」,系統很快就會進入同步地獄。
Grid 裡的狀態改成 Done,Kanban 卡片還停在 In Progress;Gantt 把截止時間改到下週,表格裡仍然是昨天;Agent 查到的是 Record,使用者看到的卻是某個 View 自己保存出來的另一份任務。
三個介面都可能看起來能用,但系統已經沒有一個清楚的「事實」可以相信。
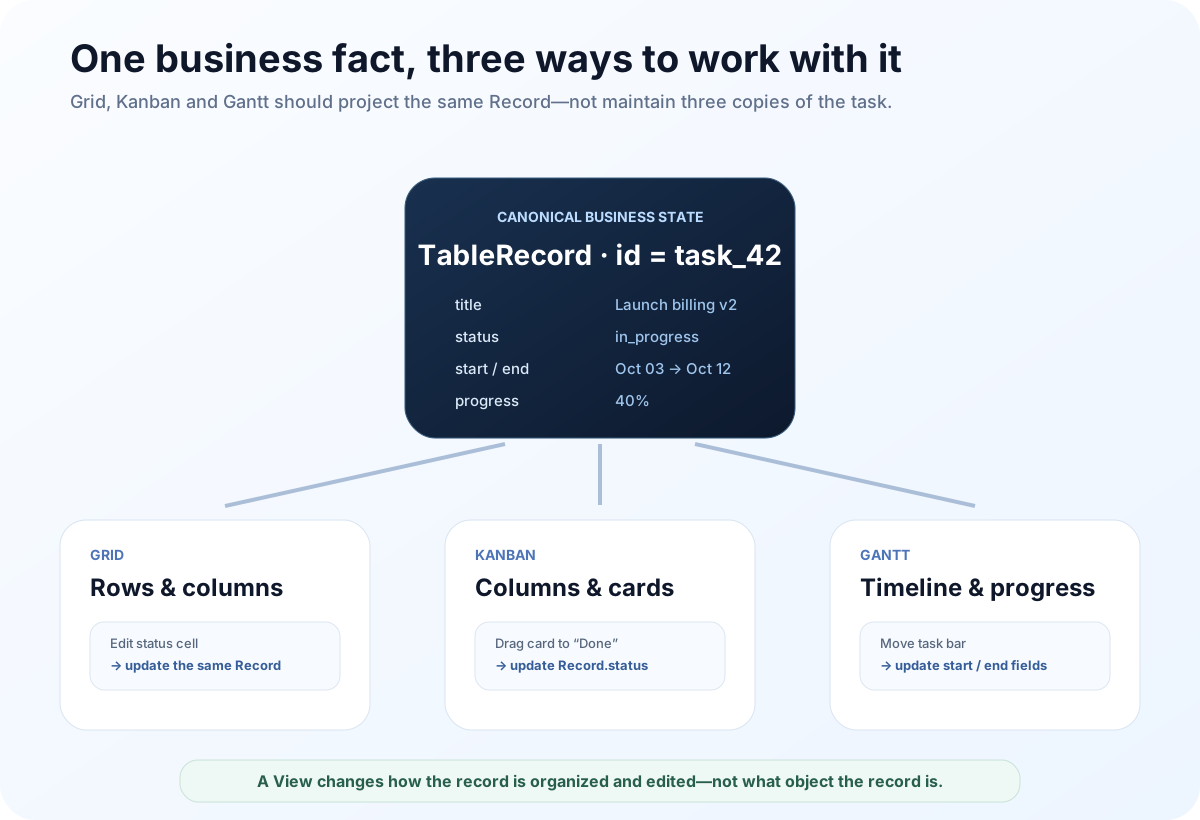
所以 QTable 這一層的目標,不是做三個各自擁有資料的功能,而是:
讓不同 View 共享同一套業務事實,只保存真正屬於各自視圖的狀態。
同一個任務,應該只有一個身分
QTable 後端目前的核心模型很直接。
TableRecord 有穩定的 id、所屬 table_id、一份 JSON data,以及用於樂觀併發控制的 version。
任務標題、狀態、負責人、開始時間、結束時間、進度,本質上都應該存在這條 Record 的欄位值裡。
而 TableView 保存的是另一類資訊:id、name、type 和 config。
這兩個物件本身不複雜,真正重要的是它們之間的邊界。
TableRecord 回答的是:
「這個業務物件現在是什麼狀態?」
TableView 回答的是:
「我想用什麼方式看這批業務物件?」
如果把這兩個問題混在一起,多視圖產品遲早會出現第二份事實。
例如為了 Kanban 單獨做 KanbanTask,為了 Gantt 再做 GanttTask,然後靠同步程序在不同模型之間複製 Status、Owner 和 Date。
剛開始開發時,這種做法很方便。
每一個介面都可以按照自己的資料結構自由演進。
但只要產品開始出現 Automation、Agent、API、即時協作和 Audit,每一次 Write 都必須再回答:
「這次到底要改哪一份?」
QTable 希望維持的答案更簡單:
先修改業務物件本身。View 只決定這次互動是透過什麼方式發生。
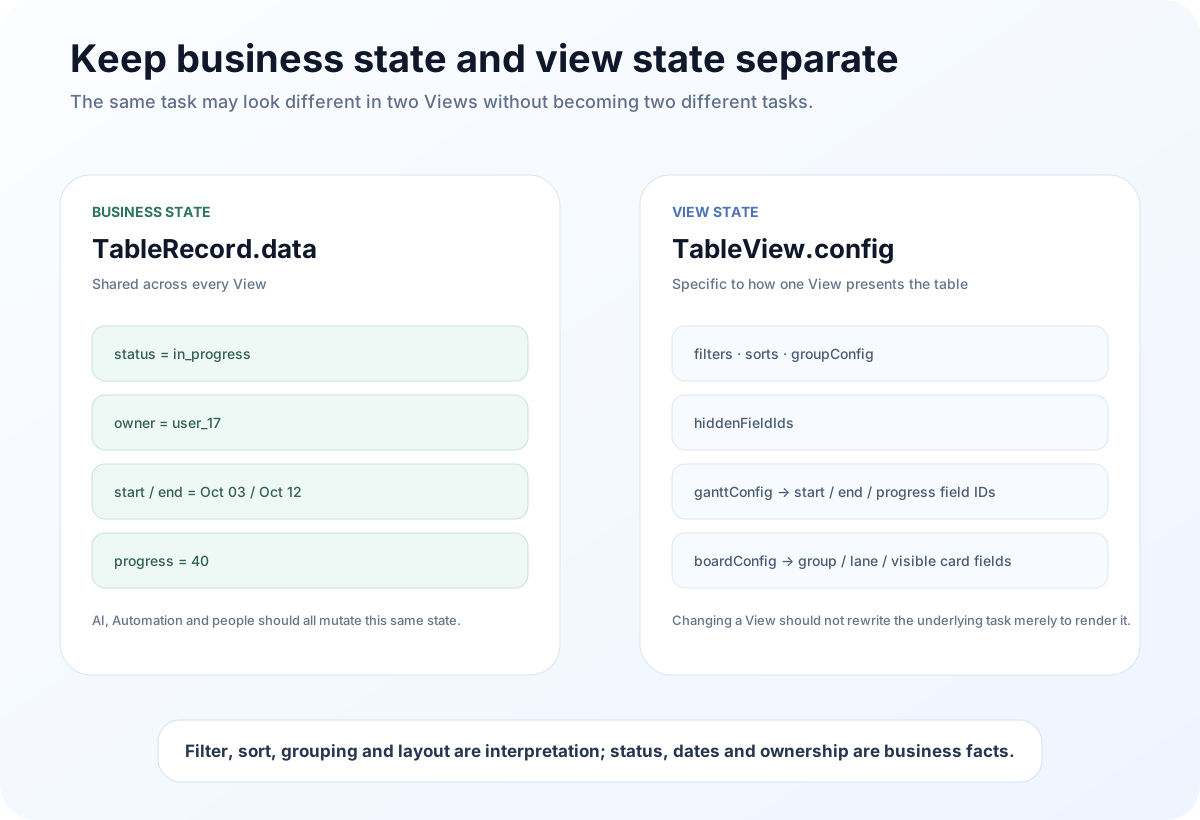
View 應該保存「怎麼看」,不是「事實是什麼」
QTableUI 目前的 ViewConfig 已經把不少視圖狀態放在對應的 View 裡。
例如 filters、sorts、groupConfig、hiddenFieldIds;Gantt 使用哪些欄位作為 start / end / progress;Calendar 使用哪些日期欄位;Gallery 的封面、標題和卡片尺寸。
Kanban 也有自己的 boardConfig,保存 Group Field、Lane Field、Card Fields、折疊欄等資訊。
這些狀態適合屬於 View。
因為它們改變的是呈現方式,不應該改變業務物件本身的內容。
同一張任務表完全可以有兩個 View:
「我的待辦」只篩選目前負責人。
「本週高優先級」只顯示特定狀態和優先級。
兩邊看到的 Record 集合可以不同,但不需要因此複製兩份任務。
目前實作裡還看得到一段歷史包袱。
後端仍然保留 TableFilter、TableSort、TableGroup 這些 Table-level Model,full store 也會讀取它們。
同時,QTableUI 現在主要把 filters / sorts / groupConfig 寫進各自的 TableView.config。
所以這一層其實還在相容與收斂過程中。
我不會說「QTable 已經完全沒有 Table-level View Config」。
比較準確的說法是:
目前產品路徑已經明顯往 per-view config 走,但舊的 table-level contract 還沒有完全消失。
這一塊後續仍然值得繼續清理。否則同一個 Filter 到底屬於 Table 還是某個 View,模型語義還是可能重新變得模糊。
Grid 是最直接的一層投影
Grid 最容易理解。
GridView.tsx 直接從 useSmartTableStore 讀取 fields、records、filters、sorts、groupConfig,再透過 useTableRecords(…) 做 Filter、Sort、Group,最後交給表格元件顯示。
關鍵在編輯。
使用者在 Grid 裡改一個 Cell 時,並沒有在「修改 Grid Data」。
change_cell_value 最後呼叫的是 Store 裡的 updateRecord(recordId, fieldId, value)。
寫入的仍然是同一條 Record。
所以 Grid 可以看成最接近 Record 原始形態的一種 View。它可以隱藏欄位、排序、分組,但不需要改變 Record 的身分。
真正更容易出問題的是 Kanban 和 Gantt,因為它們的互動方式很容易讓 View 自己長出第二份業務模型。
Kanban 最容易不小心變成第二個任務資料庫
Kanban 有一個很自然的誘惑:
「卡片有欄、有泳道、有順序,那就單獨保存卡片狀態吧。」
QTable 現在的 Board Backend 刻意沒有這麼做。
BoardCard 裡真正的業務物件仍然是 TableRecord。
Kanban 的 Column 來自一個實際 Field,例如 Status;Swimlane 也來自實際 Field,例如 Owner。
後端根據目前 View 的 boardConfig 去解釋 Record:哪一個 Field 決定 Column、哪一個 Field 決定 Lane、哪些 Field 要顯示在 Card 上。
因此「這張卡片現在在 Done 欄」不是另一個 Kanban 專屬狀態。
它代表:
這條 Record 的 Status Field 現在就是 Done。
這也是為什麼拖動卡片不能只改前端位置。
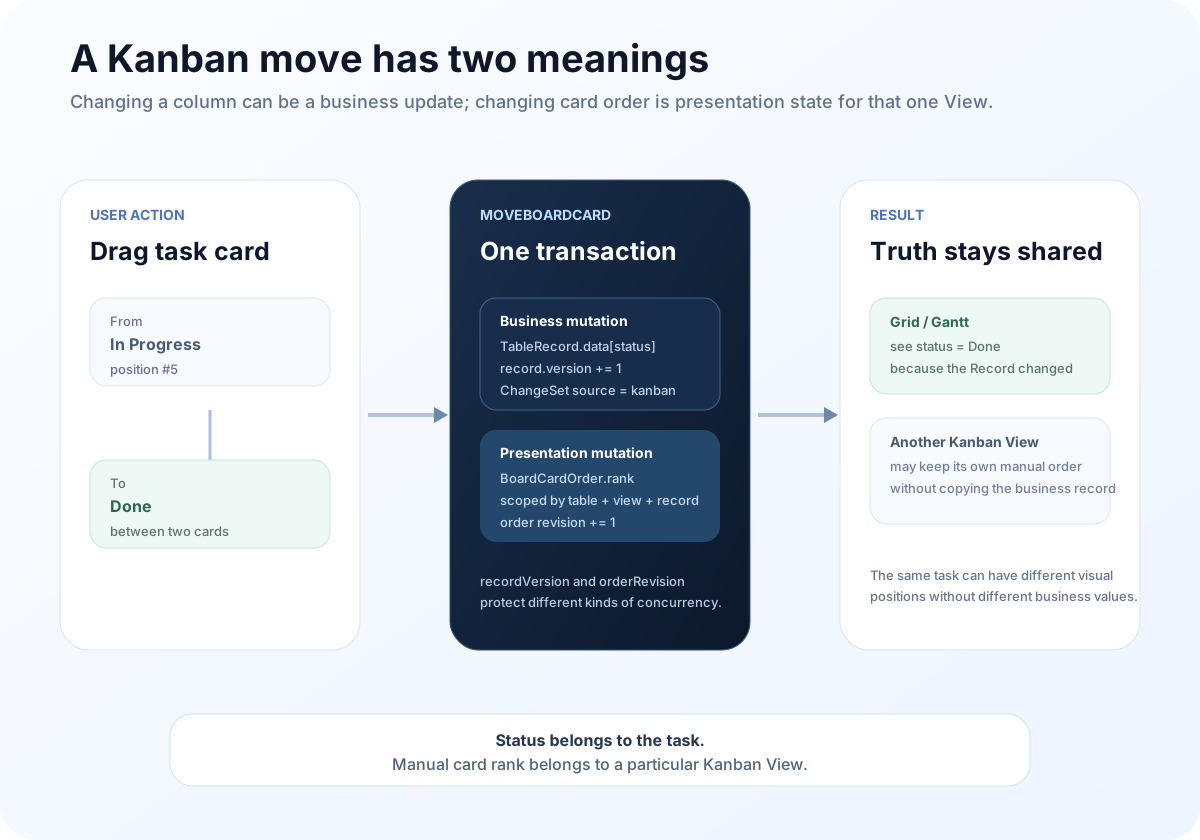
目前的 move_board_card 會在 Database Transaction 裡鎖住 Record,檢查 expectedRecordVersion,把 Target Column 和 Lane 解析回真正的欄位值,再寫入 TableRecord.data。
如果業務欄位有變化,Record 的 version 會增加,並且正常寫入 ChangeSet,source 會記錄成 kanban。
這個 Transaction 完成後,Grid 下一次看到同一條 Record 時自然會得到新的 Status。
如果 Gantt 顯示 Status,它也會讀到同一個值。
系統不需要一個額外的「同步 Kanban 狀態到 Grid」工作。
因為根本沒有第二份 Status。
但卡片順序確實可以屬於 View
現在換一個問題。
兩張卡片都在 Done 欄時,A 在 B 前面,還是 B 在 A 前面?
這通常不是核心業務事實。
同一個團隊可能有兩個 Kanban View。
產品 View 希望按照使用者價值手動排序。
工程 View 希望按照實際執行順序手動排序。
兩個 View 同時成立沒有矛盾。
所以 QTable 沒有把這種 Manual Rank 放進 TableRecord.data。
後端有獨立的 BoardCardOrder,以 (table_id, view_id, record_id) 為範圍保存高精度 rank 和 revision。
Model 裡的註解也直接寫明了設計目的:業務狀態留在 TableRecord.data,這張表只保存 Presentation Order,避免 Kanban 變成第二個 Task Database。
這個拆分也讓 Concurrency 的語義比較乾淨。
Kanban Move 現在同時可以帶 expectedRecordVersion 與 expectedOrderRevision。
前者保護的是業務 Record 有沒有被別人改過。
後者保護的是目前這個 View 的 Card Order 有沒有被別人改過。
兩個 Revision 不應該合併,因為它們保護的是不同層次的狀態。
目前也有專門的 View Isolation Test:同樣兩條 Record,在 Board A 裡可以是 A → B,在 Board B 裡可以是 B → A。
兩個 View 仍然引用相同的 Record Version,而 Order Revision 則各自獨立。
這就是「共享事實」應該允許的差異:
同一個任務在兩個 View 裡可以位置不同,但不能因此擁有兩個不同的 Status。
Kanban 已經是一個 Server-side Projection
Grid 和 Gantt 目前主要消費 SmartTable Store 裡的 Record 集合。
Kanban 已經往 Server-side Projection 再走了一步。
Board Query 可以獨立分頁某個 Column / Lane Cell,Count、Filter、Sort 和 Row Permission 都在 Server 處理。
QTableUI 的 useServerBoard 使用 network-only 查詢 Board,按 Cell Lazy Load 卡片,也會訂閱 boardUpdates。
這不代表 Kanban 擁有另一份事實。
反而是因為大表情境下,如果把所有 Record 都拉到 Browser,再由前端分欄,View 會變成一個過大的本地副本。
Board Backend 仍然從 TableRecord 查詢,只是把「如何高效投影成 Kanban」移到 Server。
它是一個 Projection Service,不是新的 Business Database。
目前這條 Server-side Kanban Paging 也有一個現實限制:GraphQL Contract 要求 DB Backend。
File Backend 現在還沒有同等級的 Kanban Paging。
這應該被當成當前 Implementation Boundary,而不是被抽象層藏起來。
Gantt 更像欄位映射器
Gantt 的形態又不同。
它需要知道哪個 Field 是開始日期、哪個是結束日期、哪個是 Progress。
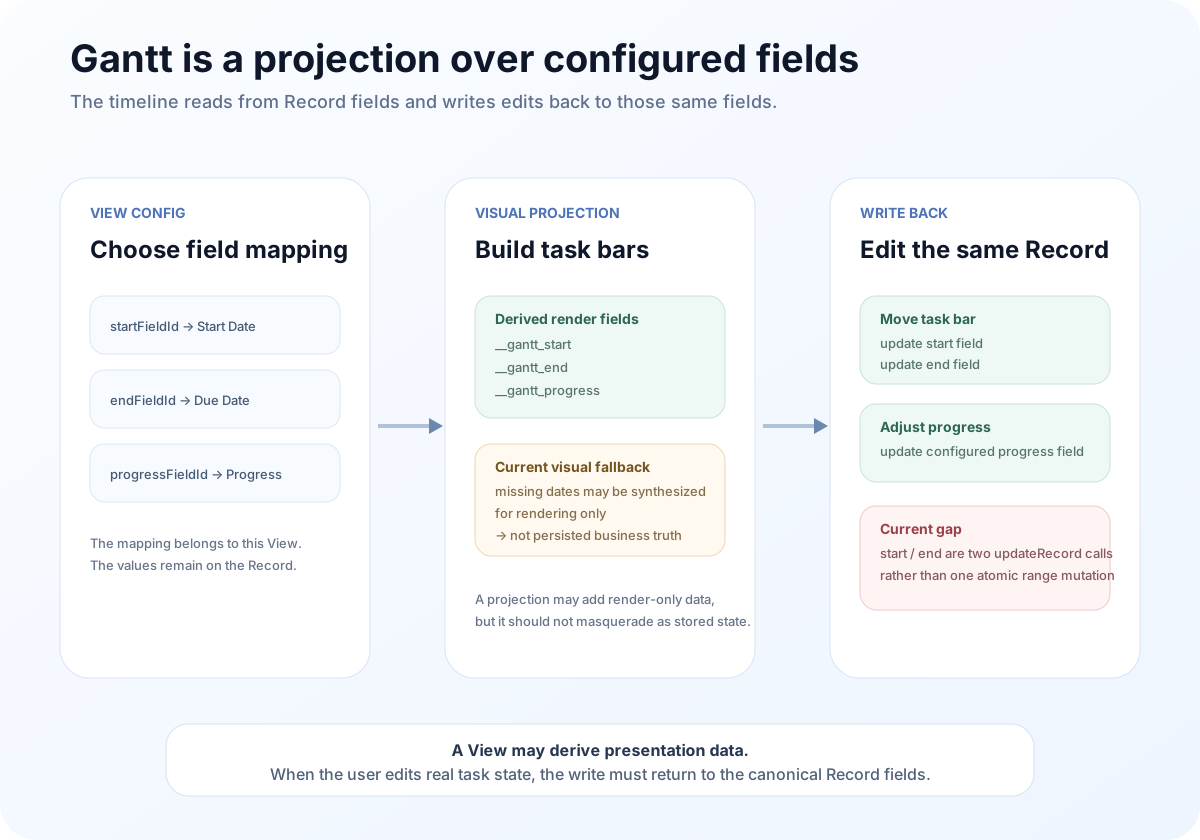
QTableUI 現在把這三個 Mapping 放在目前 View 的 ganttConfig。
也就是說,業務日期仍然存在 Record 上。
View 只保存:
「這個 Gantt 要把哪些 Field 解釋成 start / end / progress。」
渲染時,GanttView.tsx 會把 Record 轉成一些暫時的 Render Field,例如 __gantt_start、__gantt_end、__gantt_progress。
它們只是給 Visualization Library 使用的 Adapter Data,不是新的業務欄位。
所以這裡還有一條重要原則:
Projection 可以建立暫時的 Render Data,但不能讓這些資料默默變成另一個 Truth Source。
目前 Gantt 還有一個值得特別說明的細節。
如果 Record 缺少 Start 或 End,為了讓 Task Bar 能夠顯示,Gantt 會暫時推導一個日期。
如果兩個都缺少,還會依照現在日期和 Row Position 生成一段預設範圍。
這些值目前只存在 Projection 裡,沒有自動寫回 Record。
我認為這個邊界是合理的。
「UI 為了畫得出來需要一個值」和「業務確定任務從這一天開始」是兩件不同的事。
如果未來要把這種 Fallback 變成真正日期,也應該透過明確的使用者操作或業務 Rule,而不是 Render Side Effect。
Gantt 的 Write-back 已經回到同一條 Record,但 Range 還不是 Atomic
目前 Gantt 對真實修改的方向是正確的。
左側 Task List 編輯 Field 會呼叫同一個 updateRecord。
拖動 Task Bar 會把新的 Start / End 寫回設定對應的兩個 Date Field。
Progress Update 也會寫回真正的 Progress Field。
所以 Gantt 沒有另外維護一份 Task Store。
但這裡還有一個需要繼續補的工程邊界。
目前 change_date_range 針對 Start 和 End 是連續呼叫兩次 updateRecord。
對使用者來說,拖動一個時間條是一個操作。
在 Data Layer,它現在卻是兩次獨立 Write。
如果第一個成功、第二個失敗,就可能暫時留下半更新的 Range。
QTableUI 其實已經有 updateCalendarRange 這條路徑,Calendar 可以透過一個 Range Mutation 同時處理兩個日期 Field。
未來讓 Gantt 也收斂到類似的 Atomic Range Update,會比長期保留兩個獨立 Mutation 更合理。
「多個 View 共享一份事實」解決的是資料複製問題。
但共享之後,一次 UI Interaction 應該對應幾個 Atomic Business Change,仍然是另一層一致性問題。
即時協作最後還是要回到 Server 上的同一份事實
多 View 還有一個常見陷阱:
每個 View 自己維護 Cache,再用 WebSocket 彼此同步。
最後很容易變成 Grid Cache、Kanban Cache、Gantt Cache,等於換一個地方重新做三份資料。
QTableUI 目前一般 Table Path 更接近一個共享的 useSmartTableStore,Grid 和 Gantt 都直接讀目前的 Records。
本地 Record Patch 可以透過 Yjs 做協作傳播。
但目前程式碼還有一條很重要的保護:不會拿 Yjs Merge 後的整份 Snapshot 直接覆蓋 Store。
因為 CRDT Merge 不會自動理解產品裡的 Delete Semantic,舊 Snapshot 有可能把已刪除的 Record 又合回來。
所以最終還是透過 tableUpdates 做 Lightweight Invalidation,再從 Server Refresh 目前已經載入的 Record Window。
這條原則很重要:
Realtime Transport 可以傳遞 Notification 和 Patch,但 Server 上的業務資料仍然是權威來源。
Kanban 的 Board Path 也是相同方向。
它有更細的 boardUpdates,收到變更後會 Refresh Metadata 和已載入 Cell;Board Mutation 同時也會發布相容的 tableUpdates。
這樣其它 View 不需要理解「Kanban 卡片被拖動」這個 UI Event。
它們只需要知道:
Table 的 Business Data 已經改變。
未來 Agent 和 Automation 也應該遵循這個模式。
如果 Agent 改了 Status,Grid、Kanban、Gantt 應該圍繞 Record Change 收斂,而不是要求 Agent 分別發出三個 View-specific Event。
共享一份事實,不代表所有狀態都只能有一份
Single Source of Truth 很容易被理解得太絕對。
不是所有狀態都應該放在 Record。
有些東西本來就是 View-specific:
某個 View 的 Filter;
隱藏哪些 Field;
Kanban 哪些 Column 收起來;
Kanban 的 Manual Order;
Gantt 使用哪一組 Date Field;
Gallery 用哪個 Attachment 當 Cover。
如果全部塞進 Record,反而會污染 Business State。
所以我更喜歡這句話:
業務事實共享,視圖解釋隔離。
一條 Record 應該只有一個 Status。
但不同 View 可以用完全不同的方式組織和顯示這個 Status。
同一條 Record 可以在 Kanban A 排第 1,在 Kanban B 排第 7,因為 Rank 是 Presentation State,不是 Task Identity。
這比「所有 View 共用一個 JSON」更精確。
目前這一層還沒有完全收斂
只看現在的 Code,我認為接下來還有幾件事值得優先處理。
第一,繼續清理 legacy table-level filter / sort / group contract。 如果產品已經往 per-view config 走,就不應該長期讓同一類 Configuration 有兩個可能的歸屬位置。
第二,讓 Gantt Range Update Atomic 化。 Start / End 是同一個使用者操作,不應該長期依賴兩次獨立 updateRecord。
第三,讓更多 View 逐步擁有 Server-side Projection 能力。 Kanban 已經有 Permission-aware Paging;大表場景下 Grid / Gantt 也需要更明確區分 Server Query 與 Browser Projection。
第四,建立更統一的 View Projection Contract。 Filter、Sort、Group、Field Mapping、Pagination、Permission 最好不要每個 View 都各自做一套近似實作。
所以這篇說「同一份事實」,不代表這一層已經完成。
更準確地說,QTable 已經把最重要的邊界放在對的位置:Record 是業務物件,View 是 Projection;Query、Realtime、Atomic Update 和 Compatibility 還需要繼續圍繞這條邊界收斂。
對 Agent 來說,這條邊界更重要
人看到 Kanban Card,通常知道它其實還是 Grid 裡那一條任務。
Agent 只知道系統提供給它的 Model。
如果 API 暴露 GridRow、KanbanCard、GanttTask 三個彼此獨立的 Business Resource,模型很容易把它們當成三個物件。
那「把這個任務改成 Done」就可能變成:
改 GridRow.status;
再改 KanbanCard.column;
再改 GanttTask.status。
這是一個很差的 Tool Contract。
比較合理的做法是:
Agent 永遠操作 TableRecord。
View 只作為 Context 告訴 Agent:使用者現在看的是哪個 Projection、目前 Filter 是什麼、Kanban 哪個 Field 決定 Column、Gantt 哪些 Field 對應 Date。
這樣使用者從 Grid 切到 Kanban,不會讓業務物件突然換一個 Type。
People、API、Automation、Agent 最後才能共享同一套 Execution Semantic。
View 不應該變成第二個 Truth Source
多視圖產品最容易讓人注意的是介面的表現力。
Grid 適合高密度編輯。
Kanban 適合看流程。
Gantt 適合看時間和排程。
但真正困難的是:
介面越豐富,底層資料語義反而要越克制。
如果每個 View 都開始保存自己的 Business State,產品表面上會更靈活,底層卻會越來越脆弱。
所以我現在對 QTable View Layer 最核心的理解是:
View 不應該擁有第二份業務事實;它應該擁有觀察、組織和操作同一份事實的方法。
Grid、Kanban、Gantt 的價值,不是把同一個 Task 複製三次。
而是讓不同角色在同一份事實之上,用最適合自己的方式工作。
第六篇談的是「同一個業務物件怎麼被不同 View 看見」。
下一篇我會再往底層走一層:為什麼 Agent 的權限不能高於目前使用者。
當同一條 Record 可以被 Grid、Kanban、Gantt、Automation 與 Agent 同時操作時,View 的變化不應該改變 Authorization Boundary,而 Agent 也不能因為「它是 AI」就看到或修改目前使用者沒有權限接觸的資料。
QTable 已經開源
如果你對本文討論的資料模型、AI 工作流程或開源工程實踐有興趣,可以直接閱讀程式碼、提交 Issue 或參與貢獻。