
Grid、Kanban、Gantt 不应该各存一份数据:QTable 的 View 为什么只是同一事实的不同投影
同一条任务在 Grid 里是一行,在 Kanban 里是一张卡片,在 Gantt 里是一段时间条。真正难的不是把三个界面都画出来,而是让它们始终操作同一条 Record。本文结合 QTable 当前 TableRecord、TableView、BoardCardOrder 与 QTableUI 的多视图实现,拆解业务状态和视图状态该如何分开,以及当前还需要继续收敛的一致性边界。
上一篇写 Multi Tool Chain Runtime 时,我讨论的是一件偏“过程”的事:Agent 怎么把多个 Tool 组织成一条可执行的工作链。
但一条工作链执行完以后,结果最终还是会回到产品里。
用户可能在 Grid 里看它,项目经理可能在 Kanban 里拖它,另一个人可能在 Gantt 里调整开始时间。Automation 会在后台更新状态,Agent 也可能直接修改同一条业务记录。
这时候有一个看起来很普通、其实非常决定产品上限的问题:
Grid、Kanban、Gantt 到底是不是三套数据?
如果答案是“是”,系统很快就会陷入同步地狱。
Grid 里的状态改成 Done,Kanban 卡片还停在 In Progress;Gantt 把结束日期改到下周,表格里仍然是昨天;Agent 查询到的是 Record,用户看到的却是某个 View 自己缓存出来的另一份任务。
界面看起来都能用,但系统已经没有一个明确的“事实”了。
所以 QTable 这一层的设计目标不是做三个独立组件,而是:
让不同 View 共享同一套业务事实,只保存各自真正属于“视图”的状态。
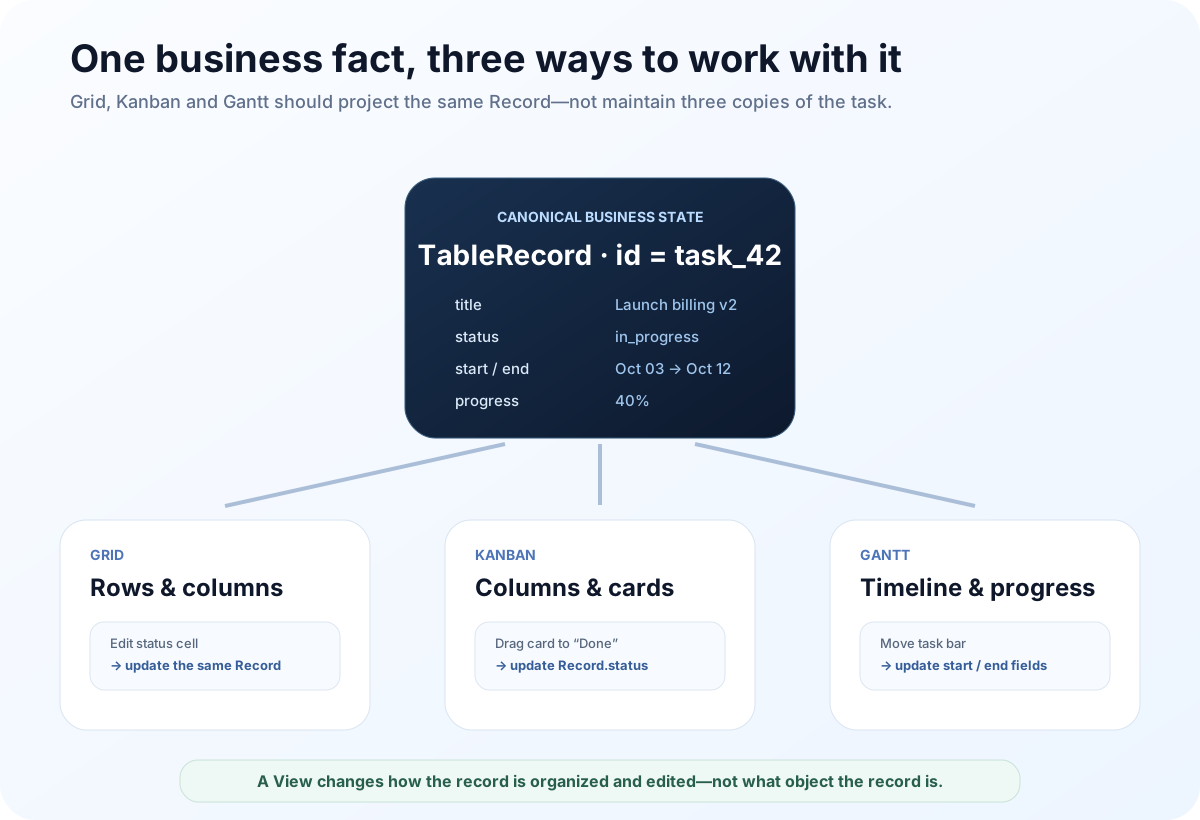
同一个任务,应该只有一个身份
QTable 后端当前的核心模型很直接。
TableRecord 有稳定的 id、所属 table_id、一份 JSON data,以及用于乐观并发控制的 version。
任务标题、状态、负责人、开始时间、结束时间、进度,本质上都应该落在这条 Record 的字段值里。
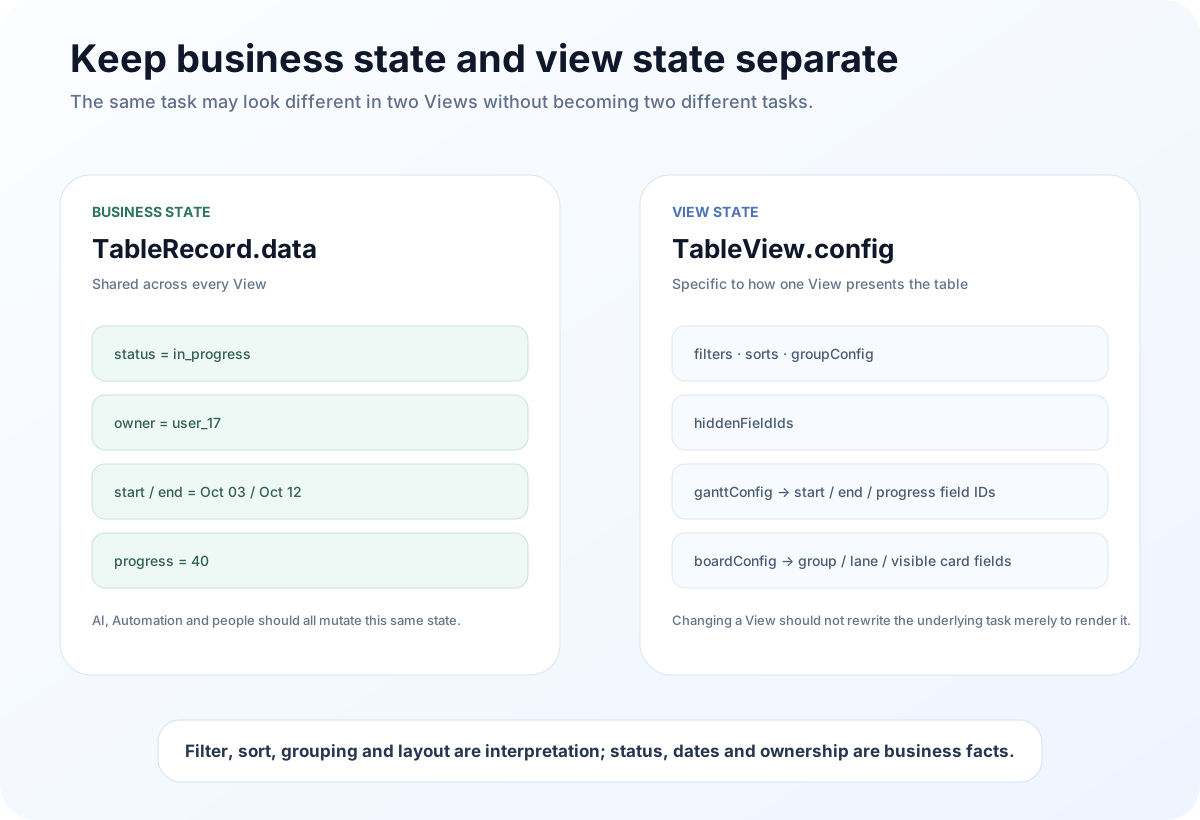
而 TableView 保存的是另一类东西:id、name、type 和 config。
这两个对象看起来很简单,但边界非常重要。
TableRecord 回答的是:“这个业务对象现在是什么状态?”
TableView 回答的是:“我想用什么方式看这批业务对象?”
如果把这两个问题混在一起,多视图产品迟早会出现第二份事实。
比如为了做 Kanban,单独维护一张 KanbanTask 表;为了做 Gantt,再维护一份 GanttTask;然后靠同步任务在三份对象之间复制字段。
这种设计在最初很容易做,每个界面都可以按自己的数据结构自由开发。但产品一旦开始有 Automation、Agent、API、实时协作和审计,它会变得越来越难维护。
因为每一次写入都要先回答:
“这次应该改哪一份?”
而我希望 QTable 的答案始终是:
先改业务对象本身。View 只决定这次修改通过什么交互发生。
View 应该保存“怎么看”,而不是“事实是什么”
QTableUI 当前的 ViewConfig 已经把不少视图状态放到了具体 View 里。
例如 filters、sorts、groupConfig、hiddenFieldIds;Gantt 使用哪几个字段作为 start / end / progress;Calendar 使用哪些日期字段;Gallery 的封面、标题和卡片尺寸。
Kanban 还有自己的 boardConfig,包含 Group Field、Lane Field、Card Fields、折叠列等配置。
这些信息都很适合属于 View。
因为它们改变的是呈现方式,不应该改变业务对象的真实内容。
同一张任务表完全可以有两个 View:
“我的待办”只过滤当前负责人;“本周高优先级”只展示特定状态和优先级。
两者看到的 Record 集合不同,但不应该因此复制两份任务。
这里还有一个当前实现需要说明的历史包袱。
后端现在仍然保留 TableFilter、TableSort、TableGroup 这些表级模型,full store 也会把它们读出来。
与此同时,QTableUI 当前主要把 filters / sorts / groupConfig 写进各自的 TableView.config。
也就是说,这一层还处在兼容和收敛过程中。
我不会说“QTable 已经完全没有表级视图配置”。
更准确的说法是:
当前产品路径已经明显走向 per-view config,但旧的 table-level contract 还没有完全消失。
这也是后续应该继续清理的一块。否则同一个 Filter 到底属于 Table 还是某个 View,会重新变成语义上的模糊地带。
Grid 是最直接的一层投影
Grid 最容易理解。
GridView.tsx 直接从 useSmartTableStore 读取 fields、records、filters、sorts、groupConfig,再通过 useTableRecords(…) 做过滤、排序和分组,把处理后的结果交给表格组件渲染。
关键在编辑。
用户在 Grid 里修改一个单元格时,并没有“修改 Grid 数据”。
change_cell_value 最终调用的是 store 里的 updateRecord(recordId, fieldId, value)。
这条写入回到的仍然是同一条 Record。
所以 Grid 只是最接近 Record 原始形态的一个 View。它当然可以隐藏字段、排序、分组,但这些操作不需要改变 Record 的身份。
这看起来理所当然。
真正有意思的是 Kanban 和 Gantt,因为它们的交互方式更容易让 View 偷偷长出自己的业务模型。
Kanban 最容易不小心变成第二个任务数据库
Kanban 有一个天然诱惑:
“卡片既然有列、有泳道、有顺序,那就单独存卡片状态好了。”
QTable 现在的 Board Backend 刻意没有这么做。
BoardCard 里真正的业务内容仍然是 TableRecord。
看板列来自一个实际 Field,例如 Status;泳道也来自一个实际 Field,例如 Owner。查询 Board 时,后端根据当前 View 的 boardConfig 去解释 Record:哪一个字段决定列,哪一个字段决定泳道,哪些字段展示在卡片上。
所以“这张卡片在 Done 列”,本质上不是一个独立的 Kanban 状态。
它意味着:
这条 Record 的状态字段值现在是 Done。
这也是为什么拖动卡片不能只改前端坐标。
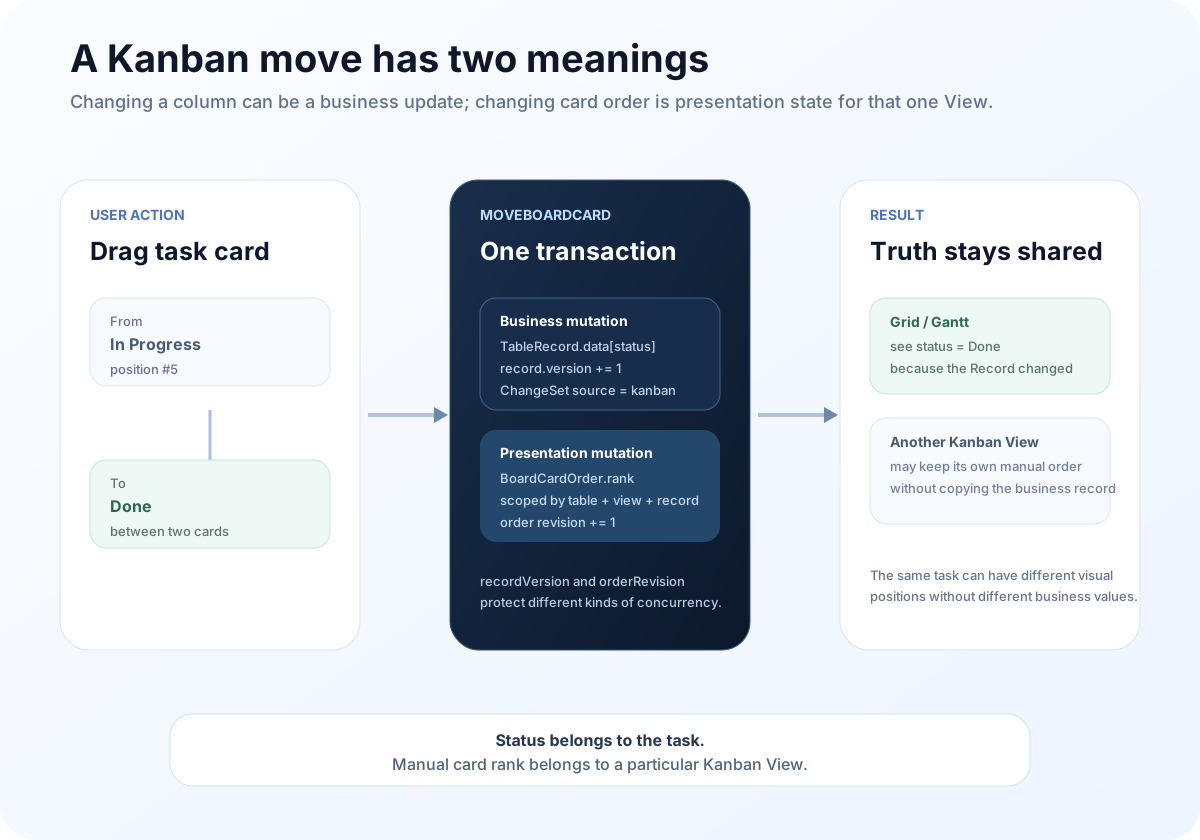
当前 move_board_card 会在数据库事务里锁定 Record,校验 expectedRecordVersion,然后把目标列和目标泳道解析回真实字段值,写进 TableRecord.data。
如果业务字段发生变化,Record 的 version 会递增,还会写入正常的 ChangeSet,来源标记为 kanban。
这一步之后,Grid 再看到这条 Record,状态自然已经变了。Gantt 如果展示 Status 字段,也会看到同一个值。
没有一条额外的“同步 Kanban 状态到 Grid”的任务。
因为根本没有第二份状态。
但卡片顺序确实可以是 View 自己的状态
这里要区分另一个问题。
假设两张卡片都在 Done 列:A 在 B 前面,还是 B 在 A 前面?
这个顺序是不是业务事实?
很多时候不是。
一个团队可能有两个 Kanban View。“产品视角”希望按用户价值手工排序,“工程视角”希望按处理顺序手工排序。两边完全可以同时成立。
所以 QTable 没有把手工卡片顺序塞进 TableRecord.data。
后端专门有一个 BoardCardOrder,按 (table_id, view_id, record_id) 保存高精度 rank 和 revision。
源码里的注释其实把意图写得很明确:业务状态继续留在 TableRecord.data,这里只保存 presentation order,避免 Kanban 变成第二个任务数据库。
这个区分还带来了一个很好的并发模型。
Kanban Move 现在同时接受 expectedRecordVersion 和 expectedOrderRevision。
前者保护的是业务对象有没有被别人改过;后者保护的是这个 View 里的卡片顺序有没有被别人改过。
这两个 Revision 不应该合并成一个数字,因为它们保护的是不同层次的状态。
当前测试里也专门覆盖了 View Isolation:同样两条 Record,在 Board A 里可以是 A → B,在 Board B 里可以是 B → A。
两边的 recordVersion 仍然指向同一条业务记录的真实版本,而 orderRevision 则各自独立。
这就是“共享事实”真正应该允许的差异:
同一条任务可以在两个 View 中位置不同,但不能在两个 View 中拥有两个不同的 Status。
Kanban 现在还有一层比普通前端 View 更重
Grid 和 Gantt 当前主要消费 SmartTable Store 中的 Record 集合。
Kanban 已经走得更远一些。
Board Query 是服务端分页的,可以按 Column / Lane 单独请求一个 Cell,还会在服务端做权限过滤、计数和排序。
前端的 useServerBoard 用 network-only 查询真实 Board 数据,按 Cell 懒加载卡片,并订阅 boardUpdates。
这不是因为 Kanban 要拥有另一份事实。
恰恰相反,是因为大表下如果把所有 Record 都拉到浏览器,再让前端分列,View 会变成一个不可靠的大型本地副本。
服务端 Board 仍然从 TableRecord 读数据,只是把“如何高效投影成 Kanban”这件事搬到了后端。
这是一种 Projection Service,而不是新的业务数据库。
当前这一套服务端 Kanban Paging 还有一个现实限制:GraphQL Contract 明确要求数据库后端。
也就是说,File Backend 目前还没有同等级别的 Kanban Paging 能力。
这同样应该被当成实现边界,而不是藏起来。
Gantt 更像一个字段投影器
Gantt 的模型又不一样。
它需要知道哪个字段是开始时间、哪个字段是结束时间、哪个字段是进度。
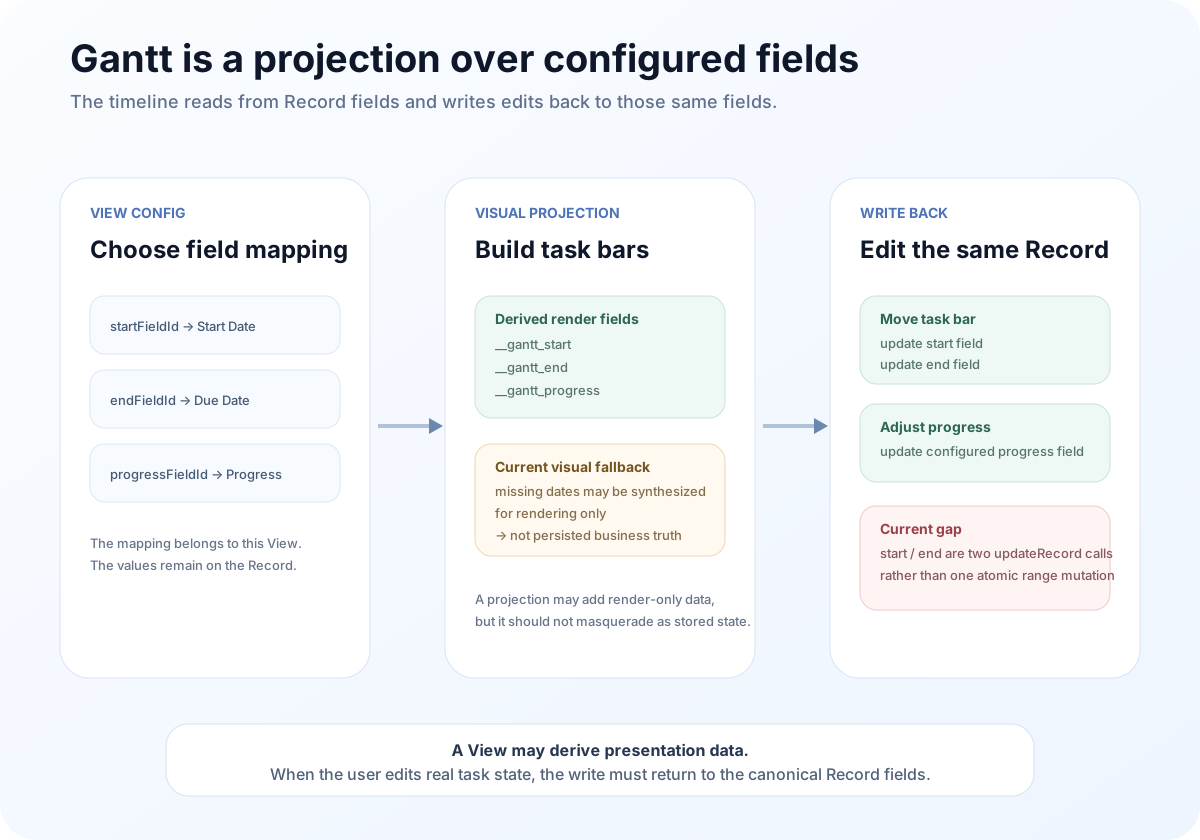
QTableUI 当前把这三个映射放在 View 的 ganttConfig 里。
同一张表甚至可以创建两个 Gantt View,选择不同的 Date Field 作为时间轴来源。
业务日期仍然存在 Record 上。
View 只保存:
“这次我想把哪些字段解释成 Gantt 的 start / end / progress。”
渲染时,GanttView.tsx 会把 Record 转成一组临时展示字段:__gantt_start、__gantt_end、__gantt_progress。
这些字段只是渲染层适配,不是新的业务字段。
这也是一个很重要的边界:
Projection 可以生成临时数据,但不能让临时数据悄悄变成新的事实来源。
这里还有一个很容易误会的细节。
如果 Record 缺少 Start 或 End,当前 Gantt 为了让时间条能显示,会推导一个临时日期。
如果两者都没有,还会基于当前日期和行号生成一段默认时间。
这些值现在只存在于 Gantt Projection 里,没有自动写回 Record。
我认为这是对的。
“为了 UI 能画出来而补一个默认值”和“系统认定任务真的从这一天开始”不是同一件事。
如果未来要把这种默认值转成业务日期,也应该变成一次明确的用户操作或规则,而不是 Render Side Effect。
Gantt 的写回已经统一,但日期区间还不是原子的
当前 Gantt 对真实编辑的方向是正确的。
在左侧 Task List 修改字段,会调用同一个 updateRecord;拖动 Gantt 时间条,会把新的 Start / End 写回配置所指向的两个 Date Field;调整进度,也会写回真正的 Progress Field。
所以从业务模型看,Gantt 不是独立的 Task Store。
但这里还有一个需要继续补的工程边界。
目前 change_date_range 对 Start 和 End 是连续调用两次 updateRecord。
这意味着“移动一整段时间条”在 UI 上是一件事,在数据层却是两次独立写入。
如果第一笔成功、第二笔失败,短时间内可能留下半更新状态。
QTableUI 里其实已经有一个 updateCalendarRange 路径,用一个 Range Mutation 同时处理两个日期字段。
我更倾向于未来让 Gantt 也收敛到类似的原子区间更新,而不是长期保留两个独立 Mutation。
“多个 View 共享一套事实”解决了数据复制问题。
但共享以后,一次交互到底对应几次原子业务变更,仍然是另一层一致性问题。
实时协作最终也应该收敛到同一份服务器事实
多 View 还有一个常见坑:每个 View 都维护一套本地缓存,然后用 WebSocket 互相同步。
这样做很容易越来越像 Grid Cache、Kanban Cache、Gantt Cache,然后又回到“三份数据”的问题。
QTableUI 当前的普通 Table 路径更接近:一个共享的 useSmartTableStore 保存当前 Records,Grid 和 Gantt 都从这里读。
本地 Record Patch 可以通过 Yjs 做协作传播。
但当前代码有一条很关键的保护:它不会使用 Yjs 合并后的整份 Snapshot 直接覆盖 Store。原因是 CRDT Merge 并不天然理解业务上的删除语义,旧快照可能把已经删除的 Record“合回来”。
所以最终仍然依赖 tableUpdates 做轻量 invalidation,再从服务器刷新当前已经加载的 Record Window。
这条原则是对的:
实时协议可以负责通知和局部 Patch,但服务器业务数据仍然是权威来源。
Kanban 的服务端 Board 也类似。
它有更细的 boardUpdates,收到变化后会刷新 Metadata 和已经加载的 Cells;同时 Board Mutation 还会发布兼容的 tableUpdates。
这样其它 View 不需要理解“Kanban 卡片移动”这个 UI 事件。
它们只需要知道:
Table 的业务数据变了。
这对未来 Agent 和 Automation 很重要。
如果一个 Agent 更新了 Status,Grid、Kanban、Gantt 应该围绕 Record 变化收敛,而不是要求 Agent 再分别发三个 View Event。
共享一套事实,不等于所有 View 都必须完全一样
“Single Source of Truth”很容易被理解成:所有东西都只能存一份。
这也不对。
有些状态天然就是 View-specific 的。
例如某个 View 的 Filter、隐藏字段、Kanban 折叠了哪些列、Kanban 手工卡片顺序、Gantt 把哪几个日期字段映射到时间轴、Gallery 选择哪个 Attachment 当封面。
这些信息如果全部塞进 Record,反而会污染业务数据。
所以我更愿意把 QTable 的边界写成:
业务事实共享,视图解释隔离。
一条 Record 可以只有一个 Status,但两个 View 可以用完全不同的方式组织和呈现这个 Status。
一条 Record 可以只有一组 Start / End,但不同 Gantt View 可以选择不同字段对作为时间轴,前提是每个 View 清楚地声明自己的映射。
一条 Record 可以在 Kanban A 排第 1,在 Kanban B 排第 7,因为 Rank 是呈现状态,不是任务本身的身份。
这比“所有 View 共用同一个 JSON”更准确。
当前这层架构还没有完全收敛
如果只看现在的代码,我认为这一层还有几件事需要继续做。
第一,继续清理 legacy table-level filter / sort / group contract。 既然产品正在走 per-view config,就应该尽量避免同一种配置同时存在于 Table 和 View 两个位置。
第二,让 Gantt Range Update 原子化。 Start / End 是一组业务变更,不应该长期依赖两个独立 updateRecord。
第三,让更多 View 逐步具备服务端 Projection 能力。 Kanban 已经有独立分页和权限感知。大表下,Grid / Gantt 也需要越来越清楚地区分“服务器 Query”与“浏览器全量投影”。
第四,把 View Projection 变成更明确的共享 Contract。 Filter、Sort、Group、Field Mapping、Pagination、Permission,最好不是每个 View 各自实现一套近似逻辑。
否则数据虽然只有一份,不同 View 对同一份数据的“解释规则”仍然可能漂移。
所以这一篇说“同一套事实”,并不代表这个问题已经结束。
更准确地说:QTable 现在已经把最重要的边界放对了——Record 是业务对象,View 是投影;但围绕这个边界的 Query、Realtime、Atomic Update 和 Compatibility 还需要继续收敛。
对 Agent 来说,这个边界甚至比对人更重要
人看到 Kanban 卡片,通常能理解:“这是一条任务,只是换了个样子。”
Agent 不一定。
如果系统向 Agent 暴露 GridRow、KanbanCard、GanttTask 三个彼此独立的对象,模型很容易认为它们就是三个不同资源。
然后“把这个任务改成 Done”可能会变成:
改 GridRow.status;再改 KanbanCard.column;再改 GanttTask.status。
这是非常糟糕的 Tool Contract。
更合理的做法是:
Agent 永远操作 TableRecord。
View 只作为 Context 告诉 Agent:用户当前看的是哪个投影、当前 View 的 Filter 是什么、Kanban 的 Group Field 是哪个、Gantt 的 Date Mapping 是什么。
这样 Agent 的动作目标不会因为 UI 变化而变化。
用户从 Grid 切到 Kanban,并不意味着业务对象换了一个类型。
这也让 Automation、API 和 Agent 能共享同一套执行语义。
View 不应该成为第二个事实来源
多视图产品最容易让人着迷的,是不同界面的表现力。
表格可以高密度编辑,Kanban 适合看流程,Gantt 适合看时间和依赖。
但真正难的是:这些界面越丰富,底层的数据语义反而要越克制。
如果每个 View 都开始保存属于自己的业务状态,产品表面上更灵活,底层却越来越脆弱。
所以我现在对 QTable View Layer 的核心判断是:
View 不应该拥有第二份业务事实;它应该拥有观察、组织和操作同一份事实的方法。
Grid、Kanban、Gantt 的价值,不是把同一个任务复制三遍,而是让不同角色在同一份事实之上,用适合自己的方式工作。
第六篇讨论的是“同一个业务对象如何被不同 View 看见”。
下一篇我会继续往更底层的一条边界写:为什么 Agent 的权限不能高于当前用户。
当同一条 Record 可以被 Grid、Kanban、Gantt、Automation 和 Agent 同时操作时,View 的变化不应该改变权限边界,Agent 也不能因为“是 AI”就获得比当前用户更多的数据或写入能力。
QTable 已经开源
如果你对本文讨论的数据模型、AI 工作流或开源工程实践感兴趣,可以直接阅读代码、提交 Issue 或参与贡献。