
為什麼多維表格適合作為 AI Agent 的業務資料底座
當 Agent 真正進入業務系統,關鍵不再是會不會寫,而是能否理解物件、關係、權限與狀態,並把自然語言落到可驗證的操作上。本文結合 QTable 目前的資料模型,說明多維表格為什麼是一個很合適的中間層。
如果 AI 只負責摘要文件、回答問題、改寫一段文字,底層資料長什麼樣,其實沒有那麼重要。PDF、網頁、聊天紀錄,甚至一堆沒有嚴格結構的筆記,都可以透過檢索和上下文拼接交給模型。
但只要把問題換成一句更接近真實工作的請求,情況馬上就變了:
「把本週已經延期、優先級高、還沒有人負責的任務找出來,重新安排到下週一之前,並給出負責人建議。」
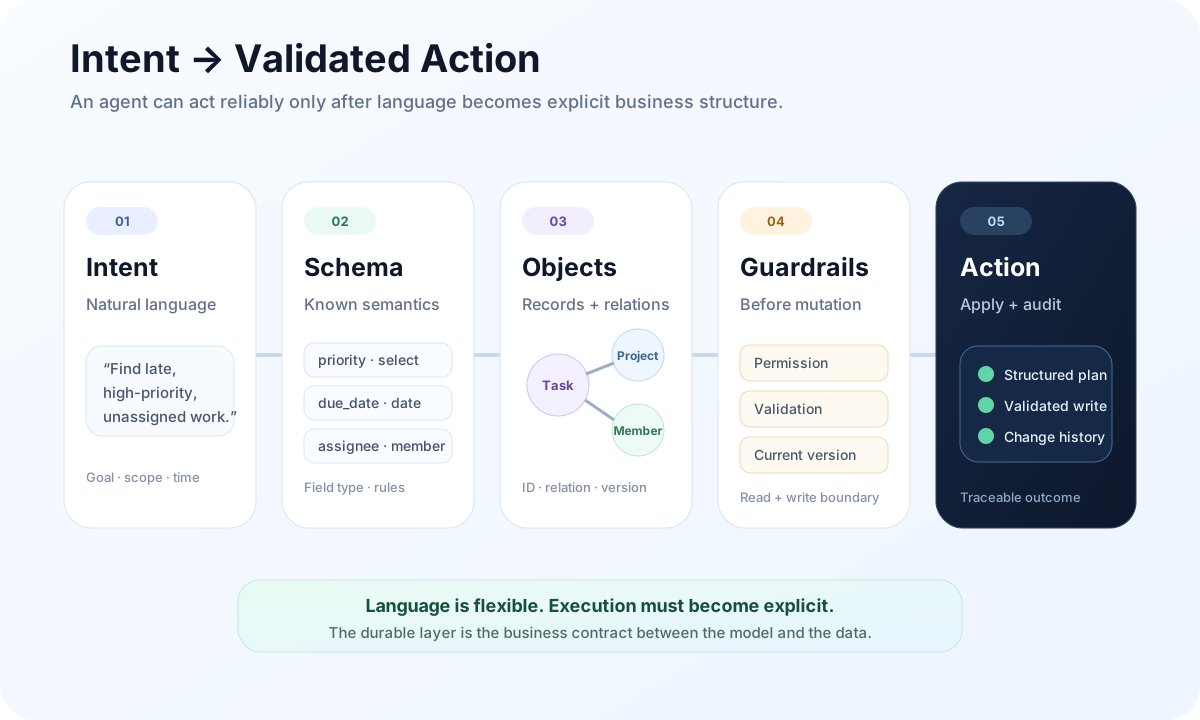
這時,模型會不會寫已經不是主要問題。系統必須先回答一連串非常具體的問題:什麼叫「任務」?優先級存在哪個欄位?「延期」如何判斷?負責人是文字還是成員關係?目前使用者能看到哪些紀錄?哪些任務允許被修改?從產生建議到真正寫回資料之間,業務狀態有沒有改變?
這也是我做 QTable 時越來越確定的一點:Agent 真正缺的往往不是更多自然語言,而是一套可以查詢、約束和執行的業務世界模型。
多維表格的價值,恰好不只是「比 Excel 多幾個視圖」。它位在自由文字和傳統資料庫之間,既保留了普通人可以直接操作的產品介面,又提供了 Agent 所需要的結構。
Agent 需要的不是「更多上下文」,而是能落地的世界模型
大型語言模型很擅長從文字裡推斷含義,但業務系統不能把每一次操作都建立在「這次模型大概理解對了」之上。
一個可以執行工作的 Agent,至少需要知道五件事:
- 物件是什麼:Project、Task、Member、Customer 不是一句話裡的名詞,而是有穩定身份的物件;
- 屬性是什麼:狀態、優先級、日期、負責人、金額都有明確型別和語義;
- 物件怎麼關聯:任務屬於哪個專案、客戶對應哪些合約、成員負責哪些工作;
- 誰能看到和修改什麼:權限必須進入查詢和寫入鏈路,而不是只存在於 UI;
- 一次修改改變了什麼:變更前後狀態要能驗證、追蹤,必要時拒絕過期寫入。
如果這些資訊只藏在自然語言裡,Agent 每次都要重新猜。如果這些資訊只存在於一個面向工程師的關聯式資料庫裡,普通使用者又很難直接理解和調整模型。
多維表格有意思的地方,就在這個中間位置。
| 資料形態 | 對人 | 對 Agent | 主要問題 |
|---|---|---|---|
| 文件 / 聊天 | 非常自然 | 語義豐富但邊界模糊 | 物件、關係、約束經常需要重新推斷 |
| 多維表格 | 可直接編輯和配置 | 結構明確、仍保留業務語義 | 需要認真設計 Schema、權限和寫入規則 |
| 原始資料庫 | 精確、強約束 | 非常適合程式查詢 | 普通使用者難以直接建模和維護 |
所以我並不認為「所有業務都應該變成表格」。更準確的說法是:當 Agent 需要參與協調、規劃、分派、追蹤和變更業務物件時,多維表格是一種很實用的工作模型。
一列紀錄真正有價值的,是它背後的 Schema
從介面上看,多維表格仍然是一列一列的資料。但對 Agent 來說,真正重要的不是「第 17 列」,而是這一列為什麼可以被理解。
以 QTable 目前的服務端模型為例,app/models/smart_table.py 把核心物件拆成了 TableField、TableRecord、TableView、TableFilter、TableSort、TableGroup 等結構。
TableRecord 的業務資料可以保存在 JSON 中,但欄位定義並不是隱含的。TableField 會明確欄位名稱、欄位型別,以及選項和屬性配置。紀錄本身還有穩定的 id,並帶有用於樂觀併發控制的 version。
這幾個看起來很普通的設計,對 Agent 很重要。
假設使用者說「把高優先級任務往前排」。如果系統只有一段任務描述,模型需要先猜什麼叫優先級、日期在哪裡、哪一段文字代表狀態。進入結構化模型之後,系統面對的已經不是模糊文字,而是一組明確的業務物件和欄位語義:
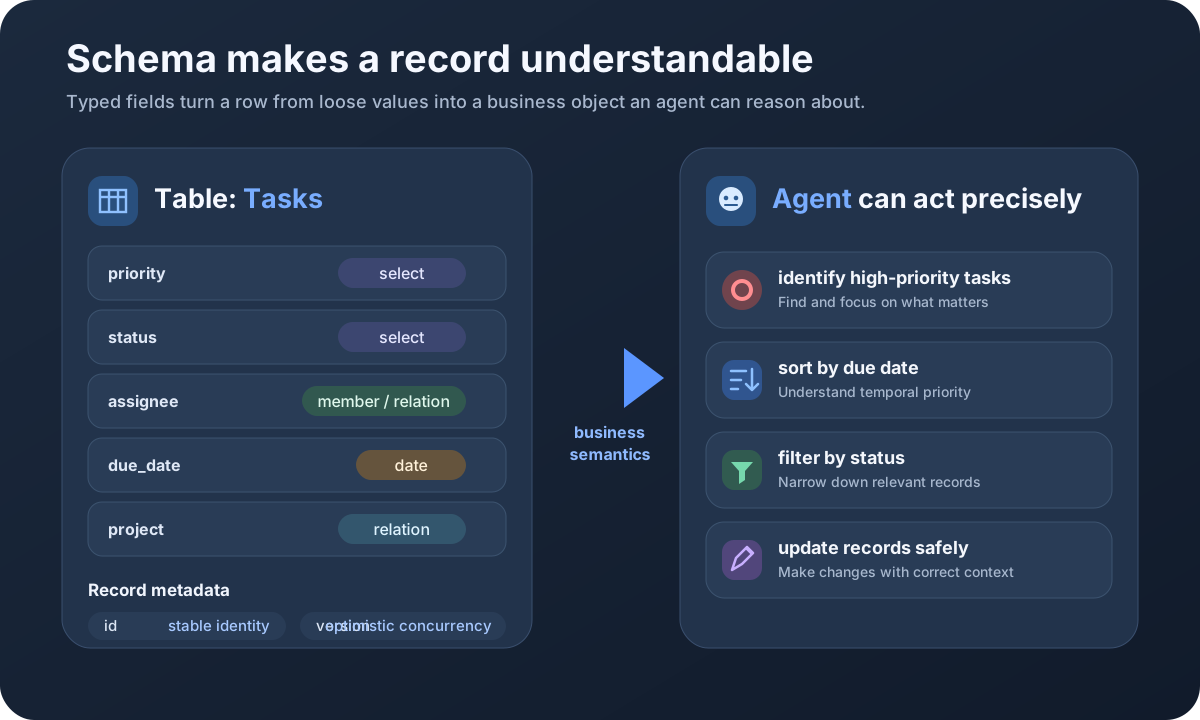
這時,AI 的職責從「猜這段文字是什麼意思」,變成「在已經定義的業務語義裡做判斷」。兩者的可靠性不是一個量級。
Relation 和 Formula,讓「清單」變成業務模型
只有欄位還不夠。真實工作裡,很少有一張表能獨立存在。
任務屬於專案,專案屬於 Workspace;任務可能依賴其他任務;負責人是團隊成員;訂單關聯客戶;客戶又關聯合約和回款。只要 Agent 想回答「為什麼延期」「誰最適合接這個任務」「這個風險會影響哪些專案」,它就需要沿著關係繼續走。
QTable 目前後端已經把這類能力拆成獨立的領域服務,例如 relation_engine.py 和 formula_engine.py。這並不意味著目前的關係與公式系統已經是最終形態,但它說明一個重要的架構方向:關係和計算應該屬於業務資料模型,而不是只屬於某個頁面。
一旦關係是顯式的,Agent 才能穩定地從 Task 找到 Project,從 Project 找到成員和排期,再把結果帶回原本的工作物件。
這和把幾十條紀錄拼成一段 Prompt 再讓模型「自己理解」是完全不同的路線。
View 最好只是投影,而不是第二份事實
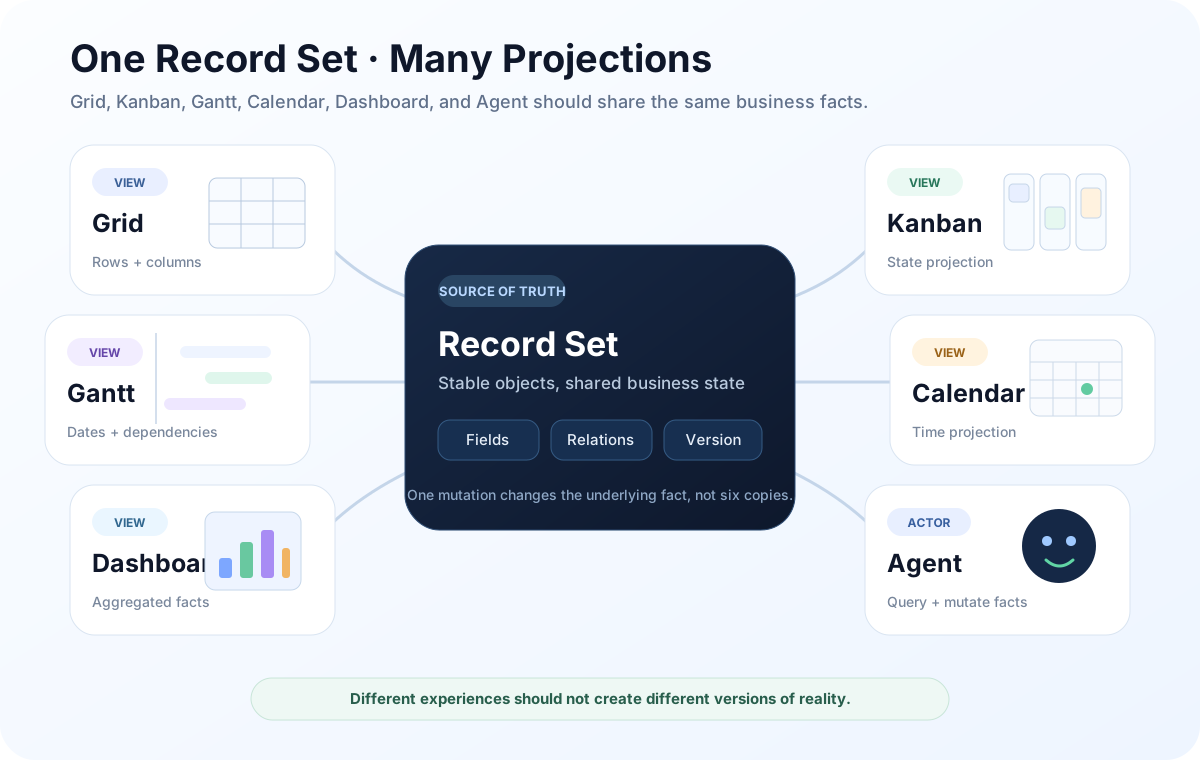
多維表格另一個很適合 Agent 的地方,是「同一份事實可以有很多種工作視圖」。
Grid、Kanban、Gantt、Calendar、Gallery 看起來完全不同,但它們應該操作同一組 Record。QTable 目前的 TableView 保存視圖型別和配置,過濾、排序和分組也作為獨立結構存在,而不是為每個視圖複製一套業務紀錄。
這條原則在 AI 進入系統之後會變得更重要。
人在 Kanban 裡把一張卡從「進行中」拖到「已完成」,本質上應該是修改 Record 的狀態欄位;在 Gantt 裡拖動時間條,本質上應該是修改日期欄位。Agent 更新同一條任務時,也應該走相同的業務物件,而不是維護一份「AI 自己的專案狀態」。
這樣一來,Web、API、自動化、Dashboard 和 AI 討論的才是同一個世界。
結構化還不夠,權限必須和資料模型長在一起
「AI 能理解資料」只是第一步。真正進入業務系統之後,更難的問題是:它能理解多少,又能動多少?
如果一張表有 10,000 條紀錄,但目前使用者只能看到其中 600 條,那麼 Agent 的上下文也應該只有這 600 條。不能先把完整資料交給模型,再期待模型在回答階段「記得不要洩漏」。
QTable 目前模型裡已經有 TableRowPermissionPolicy 和 WorkspaceItemPermission;服務層也有獨立的 row_permissions.py。入口網站文件同樣把服務端定義為權限與寫入規則的最終可信邊界。
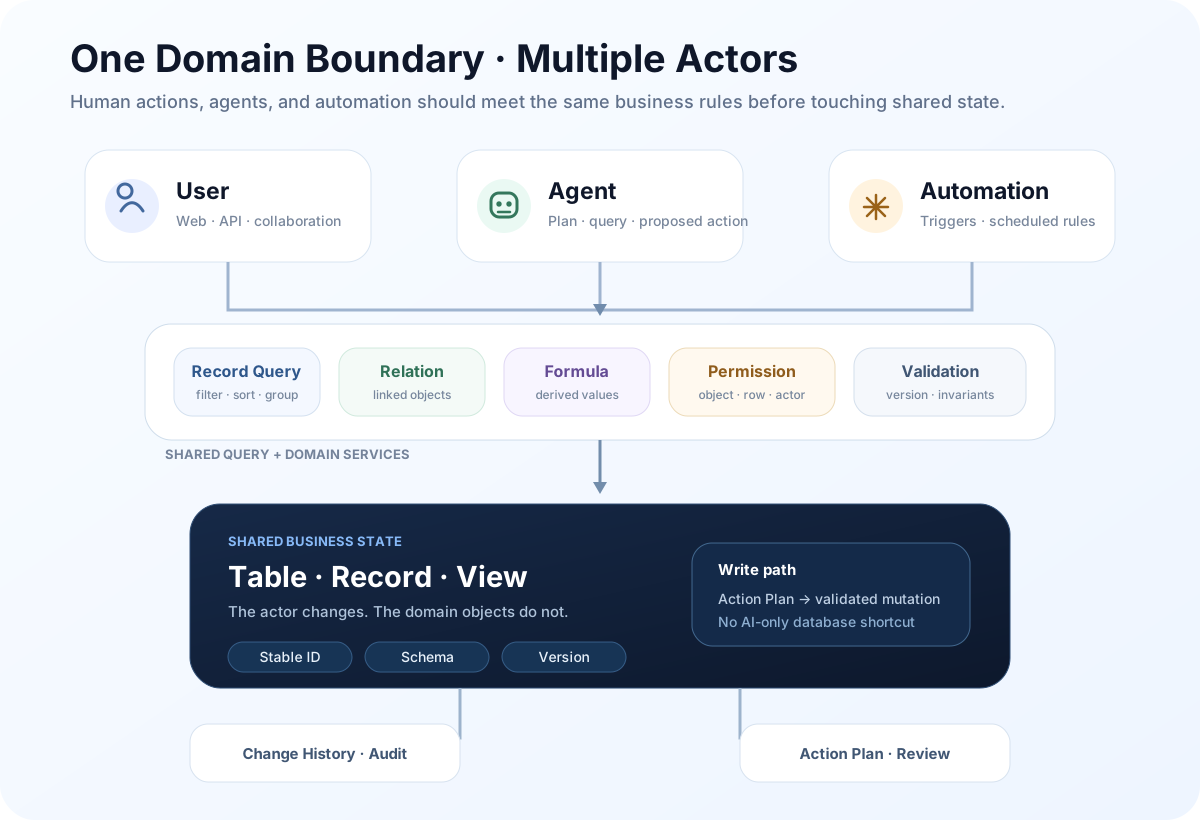
這也是為什麼我更願意把多維表格稱為「業務資料底座」,而不只是「結構化資料來源」。一個真正能承載 Agent 的底座,必須把 Schema、Relation、Permission、Validation、Version 和 Audit 放到同一個執行邊界裡。
看一個具體請求,Agent 實際需要走多遠
還是回到開頭那句話:
「把本週已經延期、優先級高、還沒有人負責的任務找出來,重新安排到下週一之前,並給出負責人建議。」
如果這件事真的要執行,而不是只產生一段建議,系統至少會經歷這樣的鏈路:
- 確認目前 Workspace、Table、View 和目前使用者;
- 讀取任務表的欄位定義,找到狀態、優先級、負責人、截止日期等語義;
- 在目前使用者權限範圍內查詢符合條件的 Record;
- 沿 Relation 取得專案、成員或依賴資訊;
- 根據業務規則和目前負載產生候選調整;
- 把修改表達成結構化 Action Plan;
- 在真正寫入之前,再檢查權限、紀錄版本和目前狀態。
前五步已經說明為什麼資料模型很關鍵;最後兩步則進入下一篇文章要討論的問題:AI 寫入操作到底怎樣才能安全落地。
QTable 目前已經有 record_query.py 這樣的查詢層,也有 ai_action_plan.py 負責 AI Action Plan。它們的意義不在於檔名本身,而在於查詢、領域規則和 AI 執行沒有被設計成三套互不相干的系統。
多維表格不是萬能資料庫,也不應該成為萬能資料庫
這裡很容易走到另一個極端:既然結構化對 Agent 有幫助,是不是應該把所有東西都塞進 Table?
我認為不是。
長文件、原始碼、圖片和影片、大規模事件流、高頻時序資料、複雜圖結構,都有更合適的儲存和檢索系統。強行把它們拆成一堆儲存格,只會讓模型和人都更難使用。
多維表格更適合承擔的是業務協調層:哪些物件正在被處理,它們是什麼狀態,彼此有什麼關係,誰負責,什麼時候到期,哪些規則允許它們發生變化。
原始內容可以繼續待在文件系統、物件儲存、程式碼倉庫或專業資料庫裡;Table 保存對工作有意義的結構、引用和狀態。Agent 需要詳細內容時再按權限取回,而不是把所有原始資訊複製進一張巨大的表。
這個邊界很重要。因為 QTable 想做的是工作系統,不是重新發明所有類型的資料基礎設施。
我現在判斷一個系統是否「Agent Friendly」的幾個問題
比起問「有沒有 AI Chat」,我現在更關心下面這些問題:
- 業務物件有沒有穩定 ID,而不是只能靠名稱比對?
- Schema 是否顯式,欄位型別和語義是否能被程式讀取?
- Relation 是否可以可靠遍歷,而不是藏在文字裡?
- View 是否只是投影,還是悄悄製造了第二份業務狀態?
- Permission 是否進入查詢和寫入,還是只在前端隱藏按鈕?
- 寫入時是否有版本、驗證、變更紀錄和可稽核邊界?
如果這些答案大多是否定的,再聰明的 Agent 也只能在系統外面「給建議」。
如果這些基礎條件成立,模型能力反而可以被替換、升級,甚至同時使用不同 Provider,因為真正穩定的是下面那層業務契約。
多維表格真正提供的是「自然語言和業務執行之間的中間層」
所以,為什麼我認為多維表格很適合作為 AI Agent 的業務資料底座?
不是因為表格天然適合 AI,也不是因為列和欄有什麼魔法,而是因為它同時滿足了幾件很難兼得的事情:人能直接理解和修改,機器能穩定查詢和驗證,業務物件之間可以建立關係,視圖可以自由變化,同時又能夠把權限和寫入規則放進統一邊界。
對 QTable 來說,這一層的意義是把自然語言逐步收斂成可執行物件:
Intent → Schema → Record / Relation → Permission → Validated Action
Agent 真正開始「工作」,就是從這裡開始的。
下一篇我會繼續往寫入鏈路裡走,具體拆解 QTable 為什麼採用 Preview → Confirm → Apply,以及 Preview 為什麼不是一個 UI 效果,而應該成為 AI 修改業務資料時的系統邊界。
QTable 已經開源
如果你對本文討論的資料模型、AI 工作流程或開源工程實踐有興趣,可以直接閱讀程式碼、提交 Issue 或參與貢獻。