
为什么多维表格适合作为 AI Agent 的业务数据底座
当 Agent 真正进入业务系统,关键不再是会不会写,而是能否理解对象、关系、权限与状态,并把自然语言落到可验证的操作上。本文结合 QTable 当前数据模型解释多维表格为什么是一个很合适的中间层。
如果 AI 只负责总结文档、回答问题、改写一段文字,底层数据长什么样,其实没有那么重要。PDF、网页、聊天记录,甚至一堆没有严格结构的笔记,都可以通过检索和上下文拼接交给模型。
但只要把问题换成一句更接近真实工作的请求,情况马上就变了:
“把本周已经延期、优先级高、还没人负责的任务找出来,重新安排到下周一之前,并给出负责人建议。”
这时,模型会不会写已经不是主要问题。系统必须先回答一连串非常具体的问题:什么叫“任务”?优先级存在哪个字段?“延期”如何判断?负责人是文本还是成员关系?当前用户能看到哪些记录?哪些任务允许被修改?从生成建议到真正写回数据之间,业务状态有没有变化?
这也是我做 QTable 时越来越确定的一点:Agent 真正缺的往往不是更多自然语言,而是一套可以查询、约束和执行的业务世界模型。
多维表格的价值,恰好不只是“比 Excel 多几个视图”。它位于自由文本和传统数据库之间,既保留了普通人可以直接操作的产品界面,又提供了 Agent 所需要的结构。
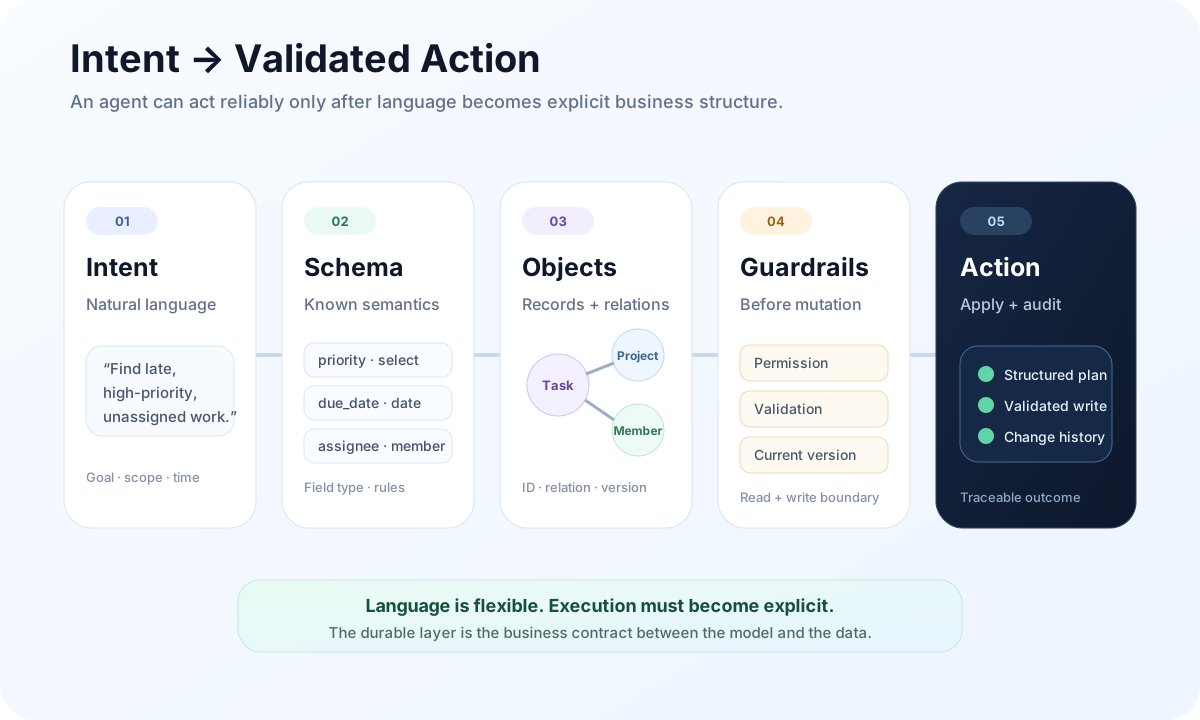
Agent 需要的不是“更多上下文”,而是能落地的世界模型
大模型很擅长从文本里推断含义,但业务系统不能把每一次操作都建立在“这次模型大概理解对了”之上。
一个可以执行工作的 Agent,至少需要知道五件事:
- 对象是什么:Project、Task、Member、Customer 不是一句话里的名词,而是有稳定身份的对象;
- 属性是什么:状态、优先级、日期、负责人、金额都有明确类型和语义;
- 对象怎么关联:任务属于哪个项目、客户对应哪些合同、成员负责哪些工作;
- 谁能看到和修改什么:权限必须进入查询和写入链路,而不是只存在于 UI;
- 一次修改改变了什么:变更前后状态要能校验、追踪,必要时拒绝过期写入。
如果这些信息只藏在自然语言里,Agent 每次都要重新猜。如果这些信息只存在于一个面向工程师的关系数据库里,普通用户又很难直接理解和调整模型。
多维表格有意思的地方,就在这个中间位置。
| 数据形态 | 对人 | 对 Agent | 主要问题 |
|---|---|---|---|
| 文档 / 聊天 | 非常自然 | 语义丰富但边界模糊 | 对象、关系、约束经常需要重新推断 |
| 多维表格 | 可直接编辑和配置 | 结构明确、仍保留业务语义 | 需要认真设计 Schema、权限和写入规则 |
| 原始数据库 | 精确、强约束 | 非常适合程序查询 | 普通用户难以直接建模和维护 |
所以我并不认为“所有业务都应该变成表格”。更准确的说法是:当 Agent 需要参与协调、计划、分派、追踪和变更业务对象时,多维表格是一种很实用的工作模型。
一行记录真正有价值的,是它背后的 Schema
从界面上看,多维表格仍然是一行一行的数据。但对 Agent 来说,真正重要的不是“第 17 行”,而是这一行为什么可以被理解。
以 QTable 当前的服务端模型为例,app/models/smart_table.py 把核心对象拆成了 TableField、TableRecord、TableView、TableFilter、TableSort、TableGroup 等结构。
TableRecord 的业务数据可以保存在 JSON 中,但字段定义并不是隐含的。TableField 会明确字段名、字段类型以及选项和属性配置。记录本身还有稳定的 id,并带有用于乐观并发控制的 version。
这几个看起来很普通的设计,对 Agent 很重要。
假设用户说“把高优先级任务往前排”。如果系统只有一段任务描述,模型需要先猜什么叫优先级、日期在哪里、哪一段文字代表状态。进入结构化模型之后,系统面对的已经不是模糊文本,而是一组明确的业务对象和字段语义:
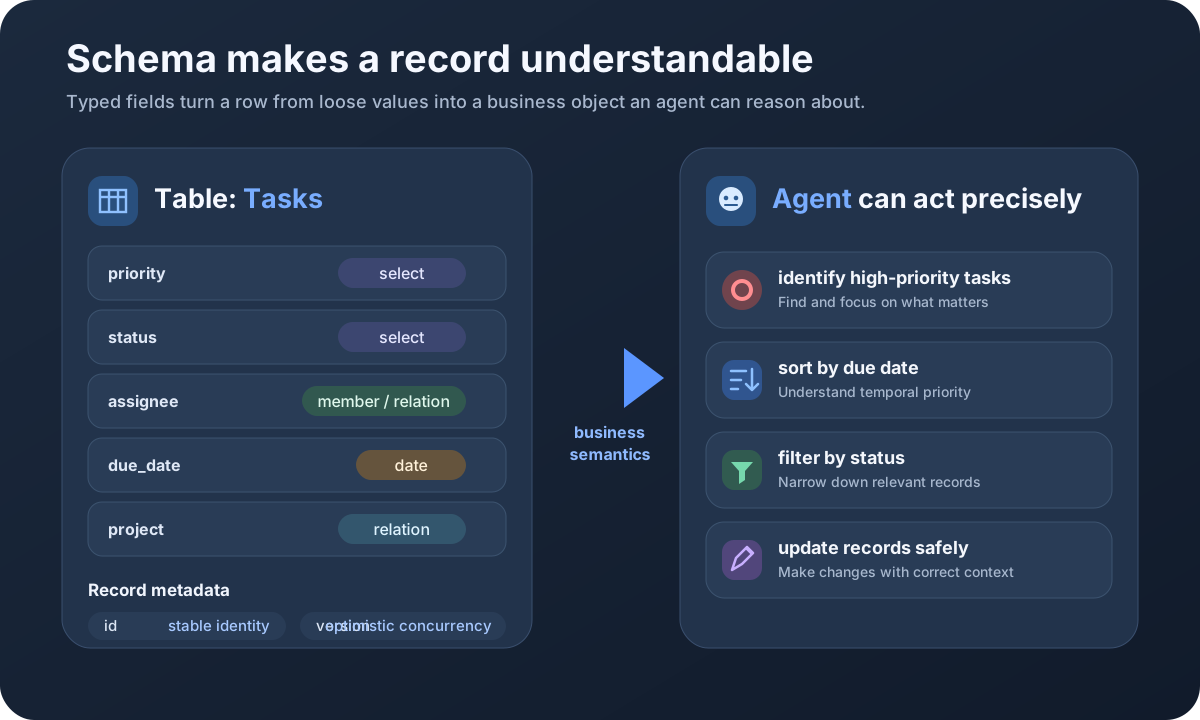
这时,AI 的职责从“猜这段文字是什么意思”,变成“在已经定义的业务语义里做判断”。两者的可靠性不是一个量级。
Relation 和 Formula,让“列表”变成业务模型
只有字段还不够。真实工作里,很少有一张表能独立存在。
任务属于项目,项目属于 Workspace;任务可能依赖其他任务;负责人是团队成员;订单关联客户;客户又关联合同和回款。只要 Agent 想回答“为什么延期”“谁最适合接这个任务”“这个风险会影响哪些项目”,它就需要沿着关系继续走。
QTable 当前后端已经把这类能力拆成独立的领域服务,例如 relation_engine.py 和 formula_engine.py。这并不意味着现在的关系与公式系统已经是最终形态,但它说明一个重要的架构方向:关系和计算应该属于业务数据模型,而不是只属于某个页面。
一旦关系是显式的,Agent 才能稳定地从 Task 找到 Project,从 Project 找到成员和排期,再把结果带回原来的工作对象。
这和把几十条记录拼成一段 Prompt 再让模型“自己理解”是完全不同的路线。
View 最好只是投影,而不是第二份事实
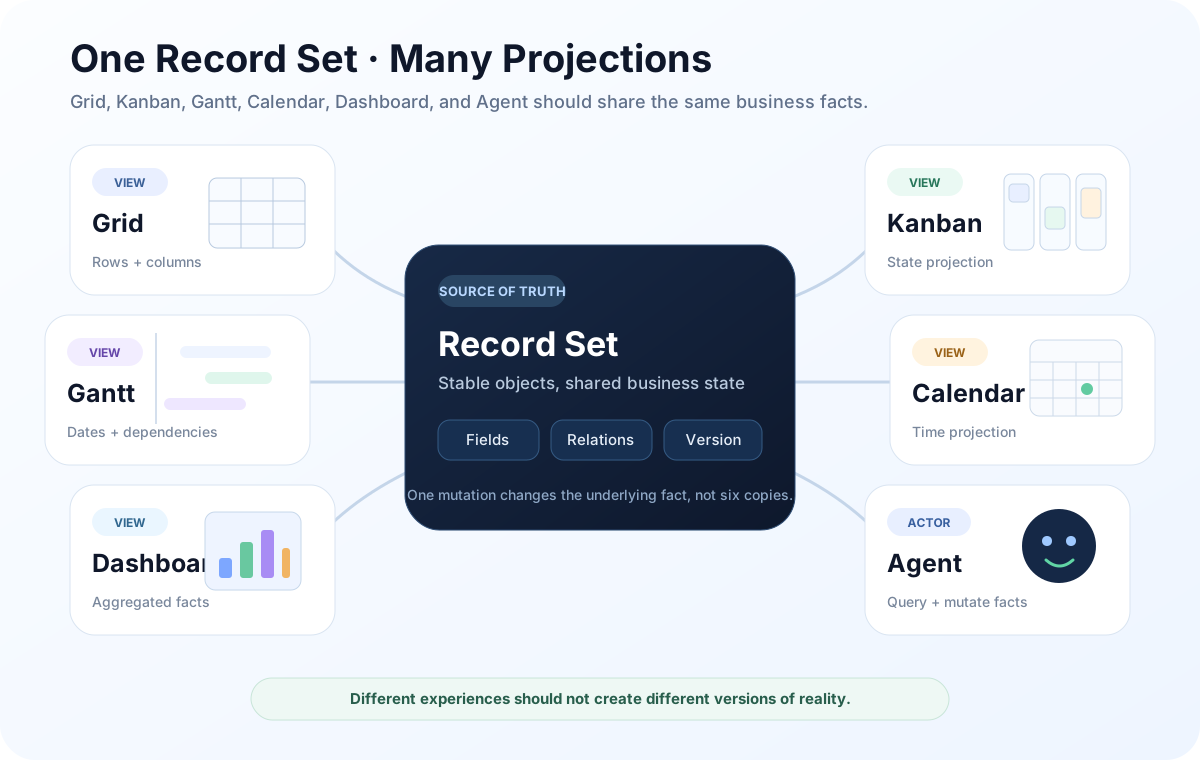
多维表格另一个很适合 Agent 的地方,是“同一份事实可以有很多种工作视图”。
Grid、Kanban、Gantt、Calendar、Gallery 看起来完全不同,但它们应该操作同一组 Record。QTable 当前的 TableView 保存视图类型和配置,过滤、排序和分组也作为独立结构存在,而不是为每个视图复制一套业务记录。
这条原则在 AI 进入系统之后会变得更重要。
人在 Kanban 里把一张卡从“进行中”拖到“已完成”,本质上应该是修改 Record 的状态字段;在 Gantt 里拖动时间条,本质上应该是修改日期字段。Agent 更新同一条任务时,也应该走相同的业务对象,而不是维护一份“AI 自己的项目状态”。
这样一来,Web、API、自动化、Dashboard 和 AI 讨论的才是同一个世界。
结构化还不够,权限必须和数据模型长在一起
“AI 能理解数据”只是第一步。真正进入业务系统之后,更难的问题是:它能理解多少,又能动多少?
如果一张表有 10,000 条记录,但当前用户只能看到其中 600 条,那么 Agent 的上下文也应该只有这 600 条。不能先把完整数据交给模型,再期待模型在回答阶段“记得不要泄露”。
QTable 当前模型里已经有 TableRowPermissionPolicy 和 WorkspaceItemPermission;服务层也有独立的 row_permissions.py。门户文档同样把服务端定义为权限与写入规则的最终可信边界。
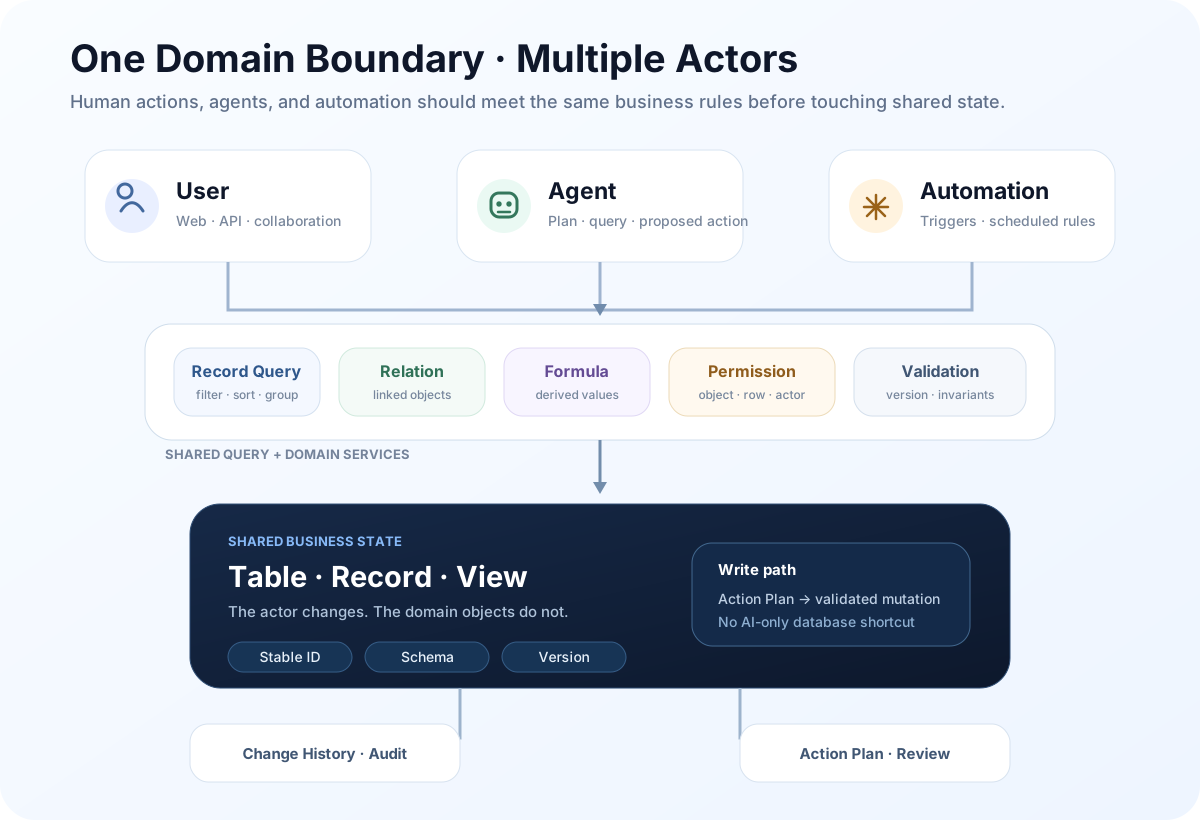
这也是为什么我更愿意把多维表格称为“业务数据底座”,而不只是“结构化数据源”。一个真正能承载 Agent 的底座,必须把 Schema、Relation、Permission、Validation、Version 和 Audit 放到同一个执行边界里。
看一个具体请求,Agent 实际需要走多远
还是回到开头那句话:
“把本周已经延期、优先级高、还没人负责的任务找出来,重新安排到下周一之前,并给出负责人建议。”
如果这件事真的要执行,而不是只生成一段建议,系统至少会经历这样的链路:
- 确认当前 Workspace、Table、View 和当前用户;
- 读取任务表的字段定义,找到状态、优先级、负责人、截止日期等语义;
- 在当前用户权限范围内查询满足条件的 Record;
- 沿 Relation 获取项目、成员或依赖信息;
- 根据业务规则和当前负载生成候选调整;
- 把修改表达成结构化 Action Plan;
- 在真正写入之前,再检查权限、记录版本和当前状态。
前五步已经说明为什么数据模型很关键;最后两步则进入下一篇文章要讨论的问题:AI 写操作到底怎样才能安全落地。
QTable 当前已经有 record_query.py 这样的查询层,也有 ai_action_plan.py 负责 AI Action Plan。它们的意义不在于文件名本身,而在于查询、领域规则和 AI 执行没有被设计成三套互不相干的系统。
多维表格不是万能数据库,也不应该成为万能数据库
这里很容易走到另一个极端:既然结构化对 Agent 有帮助,是不是应该把所有东西都塞进 Table?
我认为不是。
长文档、源代码、图片和视频、大规模事件流、高频时序数据、复杂图结构,都有更合适的存储和检索系统。强行把它们拆成一堆单元格,只会让模型和人都更难使用。
多维表格更适合承担的是业务协调层:哪些对象正在被处理,它们是什么状态,彼此有什么关系,谁负责,什么时候到期,哪些规则允许它们发生变化。
原始内容可以继续待在文档系统、对象存储、代码仓库或专业数据库里;Table 保存对工作有意义的结构、引用和状态。Agent 需要详细内容时再按权限取回,而不是把所有原始信息复制进一张巨大的表。
这个边界很重要。因为 QTable 想做的是工作系统,不是重新发明所有类型的数据基础设施。
我现在判断一个系统是否“Agent Friendly”的几个问题
比起问“有没有 AI Chat”,我现在更关心下面这些问题:
- 业务对象有没有稳定 ID,而不是只能靠名称匹配?
- Schema 是否显式,字段类型和语义是否能被程序读取?
- Relation 是否可以可靠遍历,而不是藏在文本里?
- View 是否只是投影,还是悄悄制造了第二份业务状态?
- Permission 是否进入查询和写入,还是只在前端隐藏按钮?
- 写入时是否有版本、校验、变更记录和可审计边界?
如果这些答案大多是否定的,再聪明的 Agent 也只能在系统外面“给建议”。
如果这些基础条件成立,模型能力反而可以被替换、升级甚至同时使用不同 Provider,因为真正稳定的是下面那层业务契约。
多维表格真正提供的是“自然语言和业务执行之间的中间层”
所以,为什么我认为多维表格很适合作为 AI Agent 的业务数据底座?
不是因为表格天然适合 AI,也不是因为行和列有什么魔法,而是因为它同时满足了几件很难兼得的事情:人能直接理解和修改,机器能稳定查询和验证,业务对象之间可以建立关系,视图可以自由变化,同时又能够把权限和写入规则放进统一边界。
对 QTable 来说,这一层的意义是把自然语言逐步收敛成可执行对象:
Intent → Schema → Record / Relation → Permission → Validated Action
Agent 真正开始“工作”,就是从这里开始的。
下一篇我会继续往写入链路里走,具体拆解 QTable 为什么采用 Preview → Confirm → Apply,以及 Preview 为什么不是一个 UI 效果,而应该成为 AI 修改业务数据时的系统边界。
QTable 已经开源
如果你对本文讨论的数据模型、AI 工作流或开源工程实践感兴趣,可以直接阅读代码、提交 Issue 或参与贡献。