
Agent 不是一串函式呼叫:QTable 的 Multi Tool Chain Runtime 如何把工具執行變成工作流
真正有用的 Agent 很少只呼叫一次 Tool。拆任務、估工期、讀取 Schema、產生 Gantt、寫入 Record,往往形成有依賴、有失敗邊界的執行鏈。本文結合 QTable 目前的 Multi Tool Chain Runtime,拆解 ToolChainPlan、上下文傳遞、重試、確認、回滾、可觀測性,以及目前 DAG 並行調度還沒有完全補齊的部分。
上一篇談 Context Engine 時,我最後說:
有了業務座標,下一步才輪到 Runtime 真正執行工作。
「執行工作」聽起來很簡單。
模型決定呼叫一個 Tool,後端執行,再把結果傳回來。
但只要請求稍微接近真實工作,很快就不是一次 Function Call 能解決的事。
例如使用者說:
「幫我規劃一個審批系統,估一下工作量,排出時間線,然後把任務寫進目前這張表。」
這句話至少隱含了幾件不同的事情:
先拆任務。
再估算工作量。
再產生 Gantt。
真正寫入前,還要先讀取目標 Table 的 Schema。
最後才建立 Record。
而且它們不是單純的 1 → 2 → 3 → 4。
工作量估算和 Gantt 都可以依賴 Task Split;Schema Describe 不一定要等 Estimate 完成;最終寫入則需要等任務結構、時間線和 Schema 都準備好。
這已經是一張執行圖。
如果 Agent Runtime 還只是:
「模型想呼叫什麼,就立刻呼叫什麼。」
那 Dependency、Retry、Confirm、Timeout、Rollback、Progress 和 Audit 最後都會散落到 Prompt 或一大串 if / else 裡。
QTable 的 Multi Tool Chain Runtime 想建立的是更清楚的一層:先把複雜請求變成明確的執行契約,再由 Runtime 負責執行語義。
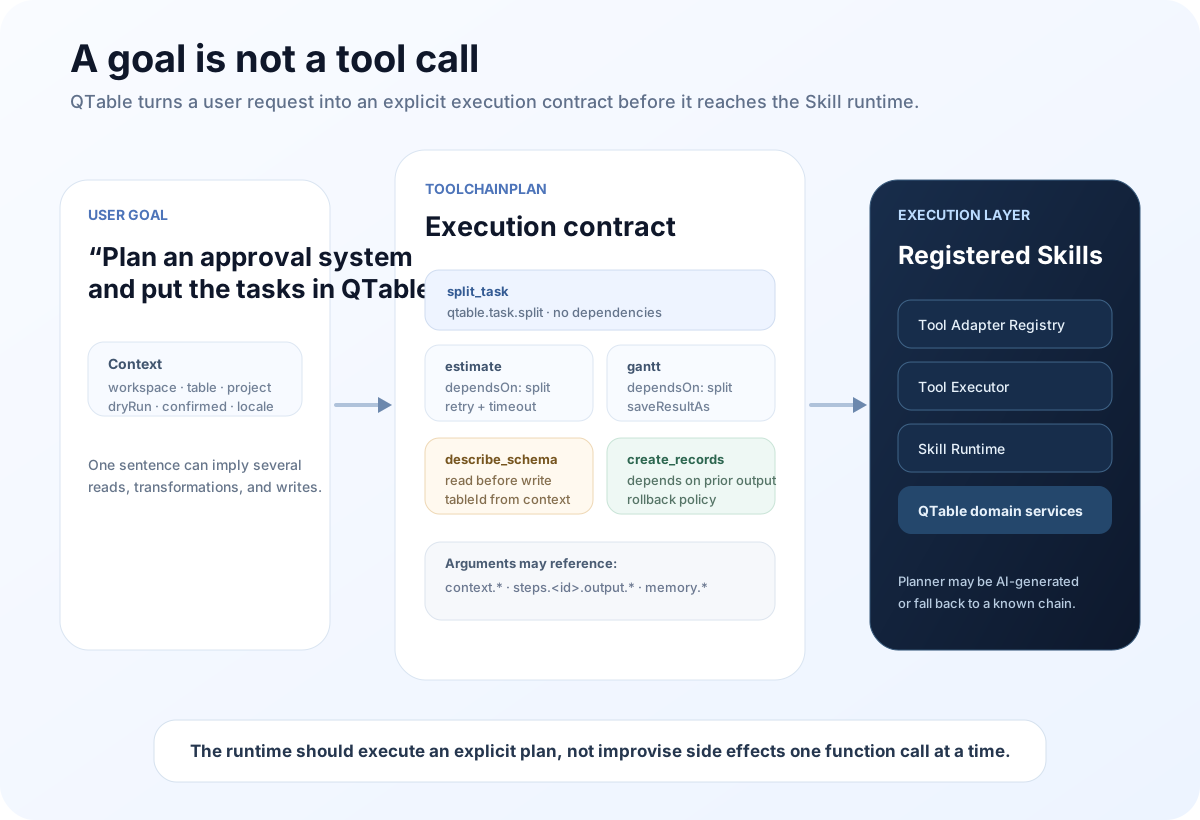
ToolChainPlan 的價值,是把「下一步做什麼」變成顯式資料
QTable 目前這層契約定義在 app/schemas/tool_chain.py。
核心物件是 ToolChainPlan 和 ToolChainStepDefinition。
一條 Step 目前可以明確宣告:
stepId;- 要呼叫的
skillName; dependsOn;- arguments;
saveResultAs;- 每一步自己的 retry policy;
- rollback strategy;
- timeout。
這些欄位重要的地方,在於它們把很多原本容易藏在 Prompt 裡的執行規則,拉回 Runtime 可以理解的結構。
例如「建立任務以前必須先讀 Schema」,不應該只是一句 Planner Prompt 裡的提醒。
它最後應該變成:
建立 Record 的 Step 明確依賴 Schema Describe Step。
「這一步最多重試兩次」,也不應該靠模型自己記住。
它應該進入 Retry Policy。
「這一步寫入後,如果後面失敗,要刪掉剛建立的 Record」,應該是 Rollback Contract,而不是自然語言備註。
這也是我認為 Agent Runtime 和普通 Tool Calling 最大的差別之一。
Tool Calling 關心單次呼叫。Runtime 關心呼叫之間的關係。
Planner 可以由模型產生,但執行規則不能由模型臨場發揮
目前的 app/services/tool_chain.py 支援兩種 Plan 來源。
如果請求直接帶了 Plan,Runtime 就使用呼叫方提供的 Plan。
如果沒有,而且 autoPlan=true,系統會讀取目前 Workspace 可用的 Skill Manifest,再讓模型產生結構化 ToolChainPlan。
如果模型不可用或規劃失敗,還有 fallback path。現在的 fallback 會優先組出類似下面的鏈路:
任務拆解;
工作量估算;
Gantt;
目標表 Schema Describe;
建立任務 Record。
我覺得這個設計裡最重要的不是「模型會規劃」。
而是:
Planner 可以不穩定,但 Execution Contract 必須是顯式而穩定的。
模型可以參與決定「需要哪些 Step」。
真正執行時,Runtime 仍然只接受已註冊的 Skill、結構化 Arguments、明確的 Dependency、Retry、Timeout 和 Rollback 設定。
LLM 是 Planner 的一種實作。
它不是 Runtime 本身。
這條邊界很重要。
未來換 Model、限制 Workspace Skill,或改成固定 Workflow,都不應該要求重寫執行層。
上一步的結果,應該透過 Runtime State 傳遞,而不是再讓模型轉述一次
Multi Tool Chain 很快會遇到第二個問題:
Tool B 要怎麼取得 Tool A 的結果?
QTable 目前的 Argument Resolver 可以從三類位置取值:
- Context;
- 前面 Step 的 Output;
- Chain Memory。
一個 Step 完成後,Runtime 會把結果放進 steps_output 和 memory。
如果 Step 設定了 saveResultAs,同一份 Output 還可以用更穩定的業務名稱保存。
所以後面的 Step 可以直接取得:
Task Split 的結果;
Context 裡的目標 Table;
前面保存下來的 Gantt Data。
Runtime 直接解析這些值。
它不需要把前一步結果重新丟給模型,再請模型組一次下一個 Tool 的 Arguments。
這看起來只是工程細節,但對穩定性影響很大。
模型重新描述資料,本身就是新的不確定轉換。
結構化 Data Passing 只是取值。
在 Agent 系統裡,可以不用模型完成的確定性工作,最好不要再讓模型做一次。
dependsOn 已經能表達 DAG,但「能表達」和「已經正確調度」不是同一件事
這是第五篇最需要說清楚的地方。
QTable 的 Tool Chain Schema 已經有 dependsOn。
Planner 也會依照 Dependency 產生 langGraphSpec,裡面有 Nodes 和 Edges。
從資料模型來看,我們已經能表達這樣的圖:
Task Split 完成後,Estimate、Gantt 和 Schema Describe 分成不同支路;需要的上游全部完成後,再進入 Create Records。
這是一張 DAG。
但我不會因此寫「QTable 現在已經完成 DAG 並行調度」。
因為程式碼目前還沒有完全到這一步。
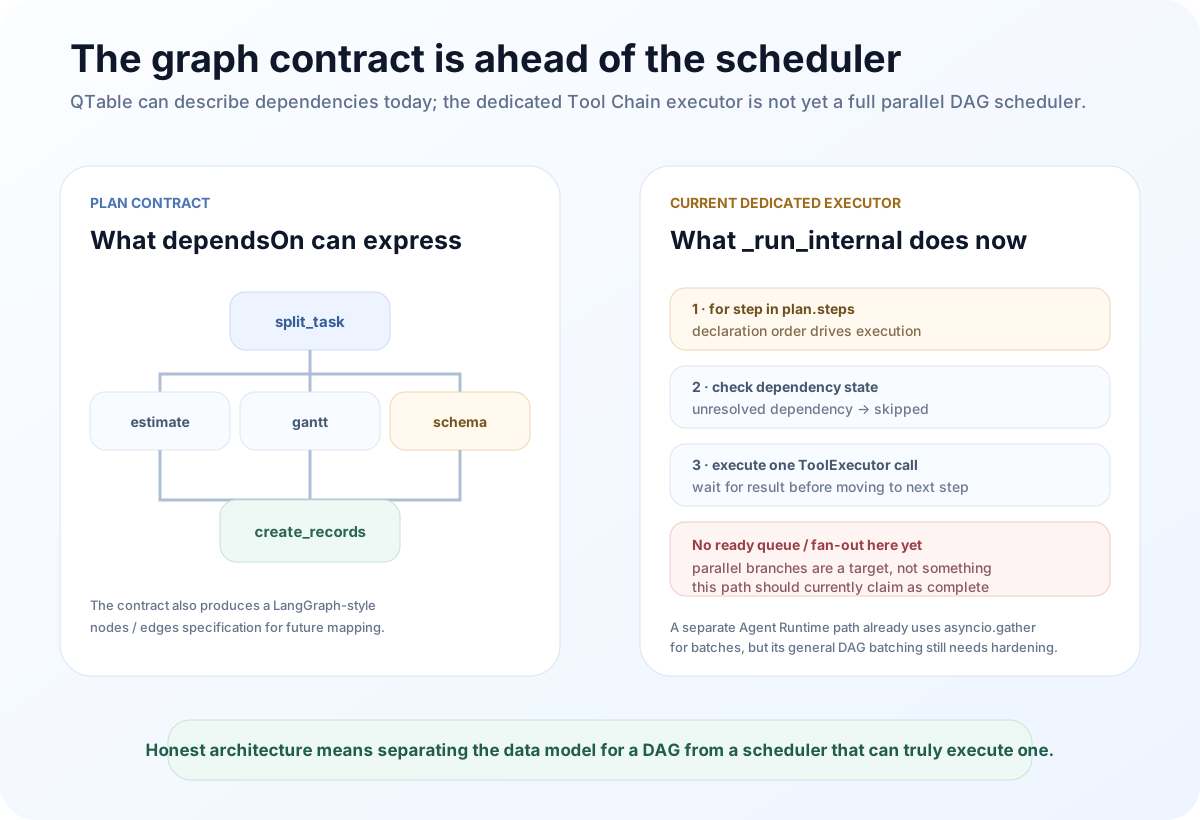
目前專用的 ToolChainRuntimeService._run_internal 是照 plan.steps 的宣告順序走。
每一個 Step 開始前,它會檢查 dependsOn 指向的 Step 是否已經進入 completed / rolled_back。
如果依賴還沒準備好,這一個 Step 會被標記 skipped。
然後 Runtime 執行目前這個 Tool,等結果回來,再進下一個 Step。
換句話說,現在的 Plan 最好本身就是 Topologically Ordered。
架構文件 docs/multi-tool-chain-runtime-architecture.md 描述的是更完整的方向:Ready Queue、拓撲釋放 Successor,以及互不依賴 Step 的並行執行。
這是目標架構,不是目前這條專用 Runtime 已經完全兌現的能力。
QTable 還有另一條 app/agent_runtime/executor.py 路徑,已經會對 Batch 使用 asyncio.gather。
但目前的 ToolPlanEngine.get_execution_order 在預先計算 Batch 時,仍然會依賴 Step 的 Runtime Completion State;而那個上游 Step 其實還沒有先執行。
所以它已經有並行執行骨架,但我同樣不會把它描述成成熟的通用 DAG Scheduler。
真正還需要補的是一個清楚的 Scheduling Core:
先驗證 Graph;
拒絕 Unknown Dependency;
做 Cycle Detection;
計算 Indegree;
建立 Ready Queue;
在 Concurrency Limit 下執行真正互不依賴的 Step;
完成後再釋放 Successor;
失敗時明確決定哪些 Branch Skip、哪些可以繼續。
這一點很值得寫清楚。
因為「有 DAG Schema」和「有 DAG Runtime」不是同一件事。
並行不是「多開幾個 asyncio task」那麼簡單
假設 Estimate 和 Gantt 都只依賴 split_task。
理論上它們可以平行。
但如果兩條支路都會修改同一張 Table 呢?
如果兩個 Step 共用同一個外部 Provider Rate Limit 呢?
如果一個在讀資料,另一個正在改掉前者要描述的那份資料呢?
真正的 Scheduler 至少還要考慮幾層約束。
Dependency 是最基本的一層。
Side Effect 是第二層。兩個沒有 Graph Edge 的 Write,不代表一定適合同時執行。
Resource / Rate Limit 是第三層。業務上可以並行,不代表 Provider 或外部 API 扛得住無限制併發。
Context Consistency 是第四層。兩個 Branch 可能從同一份 Snapshot 出發,但合併時現實世界已經改變。
所以 Multi Tool Runtime 不應該被簡化成 asyncio.gather。
Concurrency 是 Scheduling Rules 的結果。
它不是 Scheduling Policy 本身。
Retry 最重要的不是「重幾次」,而是「這件事能不能安全重做」
QTable 的 Step 有自己的 Retry Policy。
目前預設最多兩次嘗試,加固定 Backoff。
真正做 Retry 的是 app/tool_adapter/executor.py。
它不會任何失敗都自動再跑一次。
目前只有像 INVALID_INPUT 和 EXECUTION_FAILED 這類 Error 會進 Retry 判斷,並且仍受 Attempt Budget 限制。
還有一個更重要的煞車:
如果 Tool 已經 Confirmed,而且有 Side Effect,但 Skill 沒有宣告 Idempotent,Executor 會禁止自動重試。
這個細節很重要。
讀 Schema 失敗,通常可以安全再試一次。
但「建立 100 條任務」可能其實已經在 Server 成功,只是 Response 在回程丟失。如果 Runtime 不分青紅皂白再執行一次,就可能變成 200 條任務。
所以 Retry 真正的問題不是:
「失敗了要不要再跑。」
而是:
「這個操作如果再做一次,是否仍然安全?」
這也是 Agent Runtime 從 Demo 走進真實系統之後很關鍵的一條邊界。
Confirmation 是暫停點,不應該只是一個 Dialog
當底層 Skill 回傳 requires_confirmation,Tool Chain Runtime 會把目前 Step 變成 waiting_confirmation。
同時保存:
- stepId;
- skillName;
- 已解析的 arguments;
- preview metadata;
- 目前 Memory 和 Context。
這已經有了真正 Suspend 的雛形。
但目前專用 Tool Chain API 只有:
POST /api/tool-chains/run;
POST /api/tool-chains/stream;
GET /api/tool-chains/runs/{run_id}。
在 app/api/tool_chain.py 裡,現在還沒有針對同一個 Run 的 confirm / resume endpoint。
所以今天這條路徑已經能:
辨識確認邊界;
持久化 Pending State;
停在 waiting_confirmation。
但還沒有完整做到:
使用者幾分鐘後批准,Runtime 從同一個 Checkpoint 接著執行。
這應該是接下來要補的一件重要事情。
對 Long-running Runtime 來說,Confirmation 不是 UI Event。
它應該是一種可持久化的 Suspend / Resume 語義。
否則一旦跨過單一 Request Lifecycle,很容易退化成「重新跑一遍,再假裝是 Resume」。
Rollback 不是魔法 Transaction,而是 Compensation
Multi Tool Chain 另一個很容易被講大的詞是 Rollback。
如果一條 Chain 同時動到 PostgreSQL、External API 和第三方 SaaS,就沒有一個天然的 ACID Transaction 可以包住所有東西。
所以 QTable 目前這層 Rollback,更接近 Saga 裡的 Compensation。
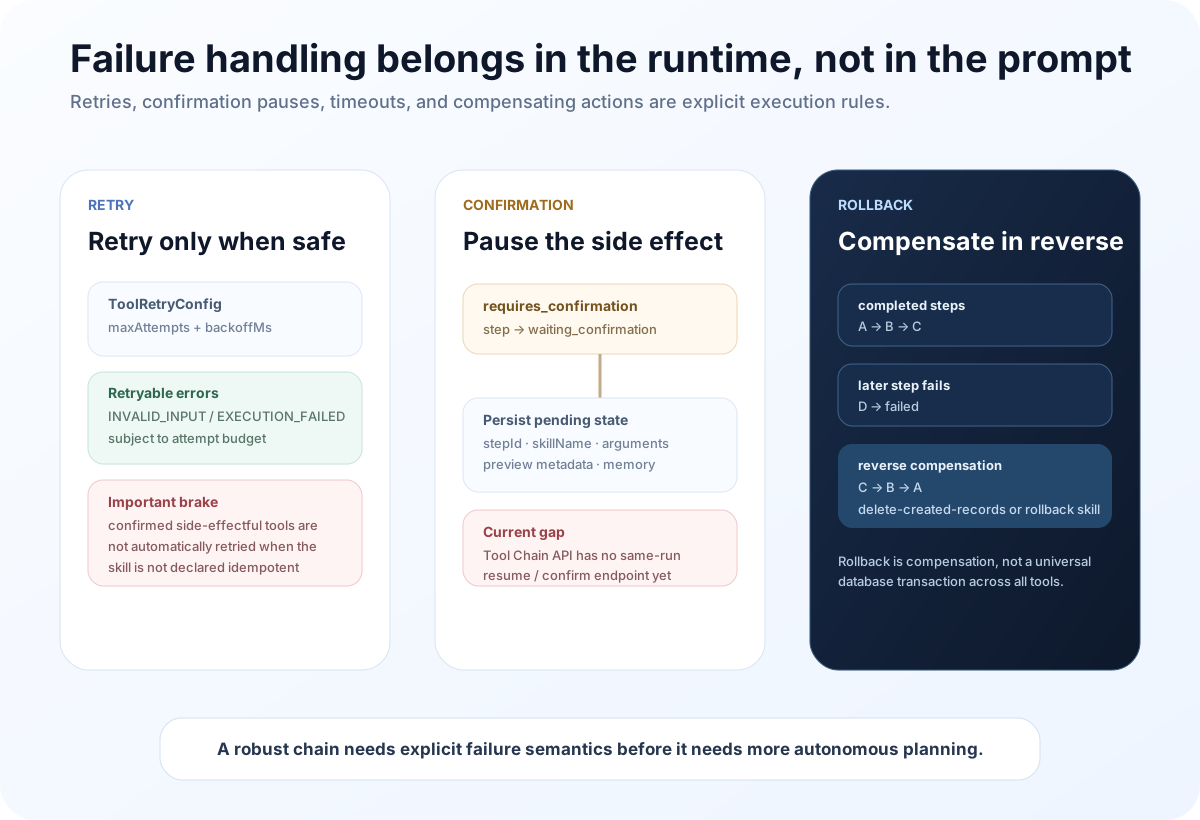
目前 Step Rollback 支援三種宣告:
none;
delete_created_records;
呼叫另一個 rollback Skill。
對 qtable.task.records.create 來說,即使 Step 沒有明確設定 Rollback,現在的 Runtime 也會嘗試用 delete_created_records 補償。
如果後面某一個 Step 失敗,已完成的 Step 會按照完成順序反向執行 Compensation。
這是一個合理的基礎。
但它不是「保證整個世界恢復成這條 Chain 從沒跑過」。
刪掉剛建立的 Record,可以補償資料庫狀態。
但如果某一個 Tool 已經送出通知、觸發 Webhook,或在第三方系統造成不可逆 Side Effect,那個 Skill 必須自己提供有意義的 Compensation。
Schema 裡目前也有 best_effort / strict Rollback Mode。
不過現有 Service 還沒有真的依照這兩個 Mode 分叉成兩套完整的 Runtime 行為;目前的做法是倒序嘗試所有 Completed Step 的補償,再依照 Compensation 是否失敗決定最終狀態。
所以這兩個 Mode 現在比較像已經留好的 Contract,而不是已經完全兌現的 Execution Semantics。
這種差異應該被寫清楚,而不是用一句「支援 Strict Rollback」帶過。
一條 Chain 如果看不見,就很難被長期維護
Multi Tool Runtime 還有一個很現實的問題:
它可能會跑很久。
一次執行可能跨越多個 Skill、幾次 Retry、一次 Confirmation Pause,最後甚至 Rollback。
如果最後只回:
「執行失敗。」
幾乎沒有任何 Debug 價值。
QTable 目前會把 Run、Step、Event 分開持久化。
tool_chain_runs 保存整個 Run 的 Plan、Context、Memory、Result、Status、trace id 和 Pending Confirmation。
tool_chain_step_runs 保存每一步的 Dependency、Input、Output、Attempt Count、Error、Rollback 資訊與 Context Snapshot。
tool_chain_event_logs 保存 Lifecycle Event。
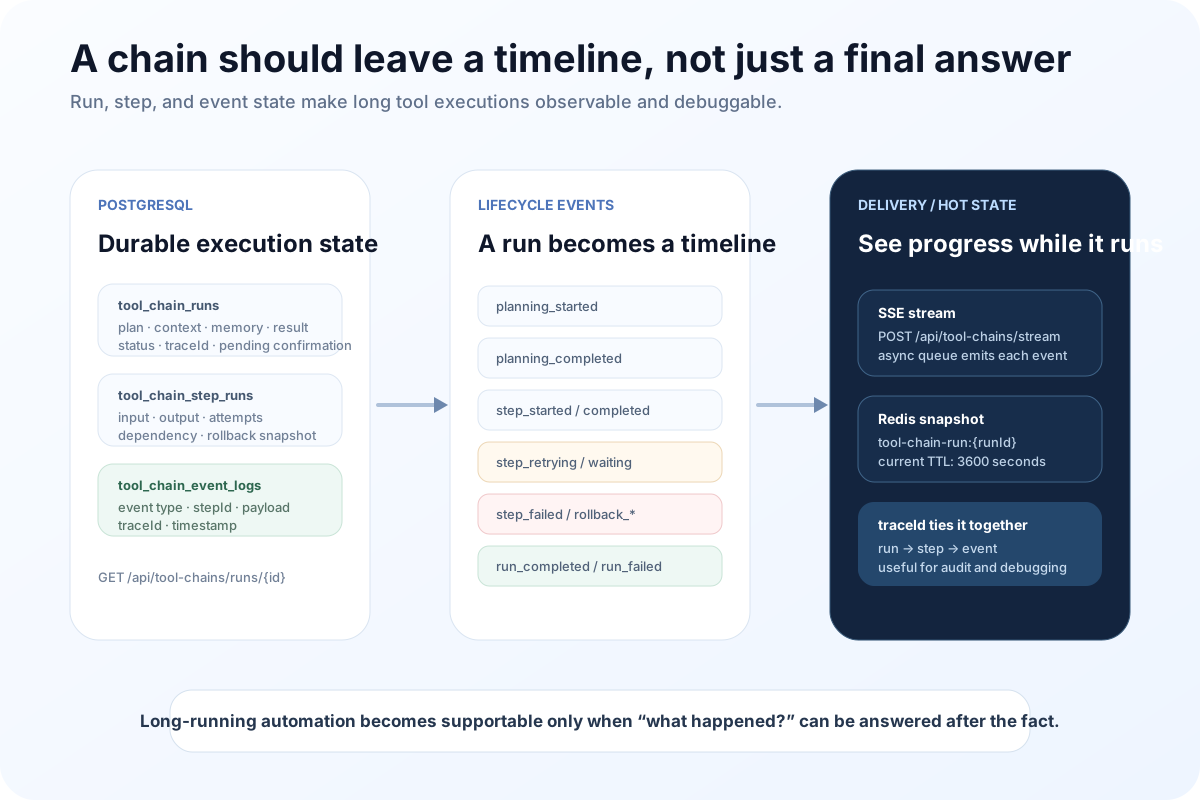
目前 Event 包含:
planning started / completed;
step started / completed;
step retrying;
step waiting confirmation;
step failed;
rollback started / completed;
run completed / failed。
/stream 會透過 SSE 把它們逐條送給前端。
每次 Event 更新後,現在的 Run Response 也會 Cache 到 Redis,TTL 是 3600 秒。
我真正重視的不是「前端可以顯示 Progress Bar」。
而是:
如果使用者問「剛才為什麼停了」,後端有資料可以回答。
如果某個 Skill 總是在 Step 2 Retry,系統看得到。
如果 Rollback 只補償了一半,也留下 Step State 和 Event。
Observability 不是 Runtime 外面的附屬功能。
它是 Multi-step Execution 能進 Production 的基本條件。
QTable 現在其實有三層很容易混在一起的 Runtime
看 QTable 目前程式碼時,還有一個地方很容易混淆。
現在並不是只有一個叫 Runtime 的東西。
至少有三條相關路徑。
Multi Tool Chain Runtime
重點是 ToolChainPlan、Step Dependency、Memory、Retry、Rollback、SSE 與 Run Persistence。
Agent Runtime
重點是 Intent → Plan → Preview / Confirm → Tool Execution → Observation 的通用 Agent State Machine,而且已經開始以 Batch 執行 Tool。
Agent Workflow / LangGraph
已經有真正的 StateGraph,把 Planner、Tool Executor、Observer、Retry、Human Approval、Finalize 做成 Node,並往 Checkpoint / Resume 方向發展。
這些概念有不少重疊,但今天還不是完全統一的一套 Execution Kernel。
這應該是接下來很值得收斂的架構工作。
我不希望未來變成:
Tool Chain 有一套 Retry。
Agent Runtime 又有一套 Retry。
LangGraph Workflow 再有第三套 Retry。
真正穩定之後,它們應該共享:
同一個 Tool Contract;
同一個 Context Model;
同一種 Confirmation;
同一套 Step State;
同一條 Observability;
相同的 Permission / Side Effect Rule。
至於上層是 Dynamic Agent Request、固定 Workflow,還是 AI Planner 產生的 Tool Chain,只應該是 Orchestration Surface 不同。
執行語義不應該變成三套。
我會怎麼繼續補這一層 Runtime
如果沿著目前程式碼往下做,我會優先補四件事。
第一,真正的 DAG Scheduler。
不是依賴 Plan 宣告順序,而是 Graph Validation、Cycle Detection、Indegree、Ready Queue、Concurrency Limit 和 Successor Release。
第二,Checkpoint / Resume。
特別是 Confirmation 和 Long Task,必須從持久化 Step State 繼續,而不是重新開一個 Run。
第三,把 Retry、Rollback、Confirmation 收斂到同一個 Execution Layer。
不要讓 Tool Chain、Agent Runtime、LangGraph Workflow 各自再做一次近似的邏輯。
第四,讓 Side Effect Constraint 變成 Tool Metadata。
例如是否 Idempotent、是否 Parallel-safe、是否支援 Compensation、是否需要 Serial Key,都應該成為 Runtime 能讀的 Contract,而不是 Planner 的猜測。
等這幾件事補完之後,Multi Tool Chain 才會真正從一份很好的 Plan Contract,變成一個能長期承擔複雜業務工作的 Runtime。
Agent 真正需要的不是更多 Tool,而是更清楚的 Execution Semantics
Tool 很容易越來越多。
讀表。
搜尋。
產生 Gantt。
送通知。
建立任務。
改負責人。
呼叫第三方服務。
但 Tool 越多,不會自然得到更強的 Agent。
如果沒有 Execution Semantics,Tool 越多,只會有更多 Failure Mode。
所以我現在更在意這些問題:
誰依賴誰?
哪些真的可以平行?
哪一步失敗可以 Retry?
哪些操作不能自動重做?
哪裡必須 Pause 等使用者確認?
失敗後能 Compensation 什麼?
Run 要怎麼 Resume?
最後留下了什麼 Evidence?
這些不是 Model Parameter 能解決的問題。
它們屬於 Runtime。
這也是我對 Multi Tool Chain Runtime 最核心的判斷:
Agent 的能力不只取決於它會呼叫多少 Tool,而在於系統能不能把多個 Tool 組織成一條可解釋、可暫停、可重試、可恢復、可審計的執行鏈。
第五篇談的是「怎麼執行」。
下一篇我會回到 QTable 本身一個很容易被低估的問題:Grid、Kanban、Gantt 為什麼不應該是三套資料。
同一條 Record 在不同 View 裡應該維持同一份事實;View 應該只投影、排列和組織資料,而不應該偷偷製造第二份業務狀態。這件事會直接決定人工操作、AI 和 Automation 最後能不能真的圍繞同一套產品模型協作。
QTable 已經開源
如果你對本文討論的資料模型、AI 工作流程或開源工程實踐有興趣,可以直接閱讀程式碼、提交 Issue 或參與貢獻。