
Agent 不是一串函数调用:QTable 的 Multi Tool Chain Runtime 如何把工具执行变成工作流
一个真正有用的 Agent 很少只调用一次 Tool。拆任务、估工期、读取 Schema、生成 Gantt、写入 Record,往往形成有依赖、有失败边界的执行链。本文结合 QTable 当前 Multi Tool Chain Runtime,拆解 ToolChainPlan、上下文传递、重试、确认、回滚、可观测性,以及当前 DAG 并行调度还没有完全补齐的部分。
上一篇写 Context Engine 时,我最后说:
有了业务坐标,下一步才轮到 Runtime 真正执行工作。
“执行工作”听起来像一件很简单的事。
模型决定调用一个 Tool,后端执行,返回结果。
但只要请求稍微接近真实工作,事情很快就不是一次函数调用了。
比如用户说:
“帮我规划一个审批系统,估一下工作量,排出时间线,然后把任务写进当前表。”
这里至少隐含了几件不同的事:
先拆任务。
再做工作量估算。
再生成 Gantt。
在真正写入前,还要先读取目标 Table 的 Schema。
最后才是创建 Record。
而且它们不是简单的 1 → 2 → 3 → 4。
工作量估算和 Gantt 都可以依赖任务拆解;读取 Schema 并不一定需要等估算完成;最终写入则需要等任务结构、时间线和 Schema 都准备好。
这已经是一张执行图了。
如果 Agent Runtime 仍然只是:
“模型想调用什么,就马上调用什么。”
那么依赖关系、重试、确认、超时、回滚、进度和审计最后都会散落到 Prompt 或某个巨大 if/else 里。
QTable 的 Multi Tool Chain Runtime 想解决的是另一件事:先把一次复杂请求变成明确的执行契约,再由 Runtime 负责执行语义。
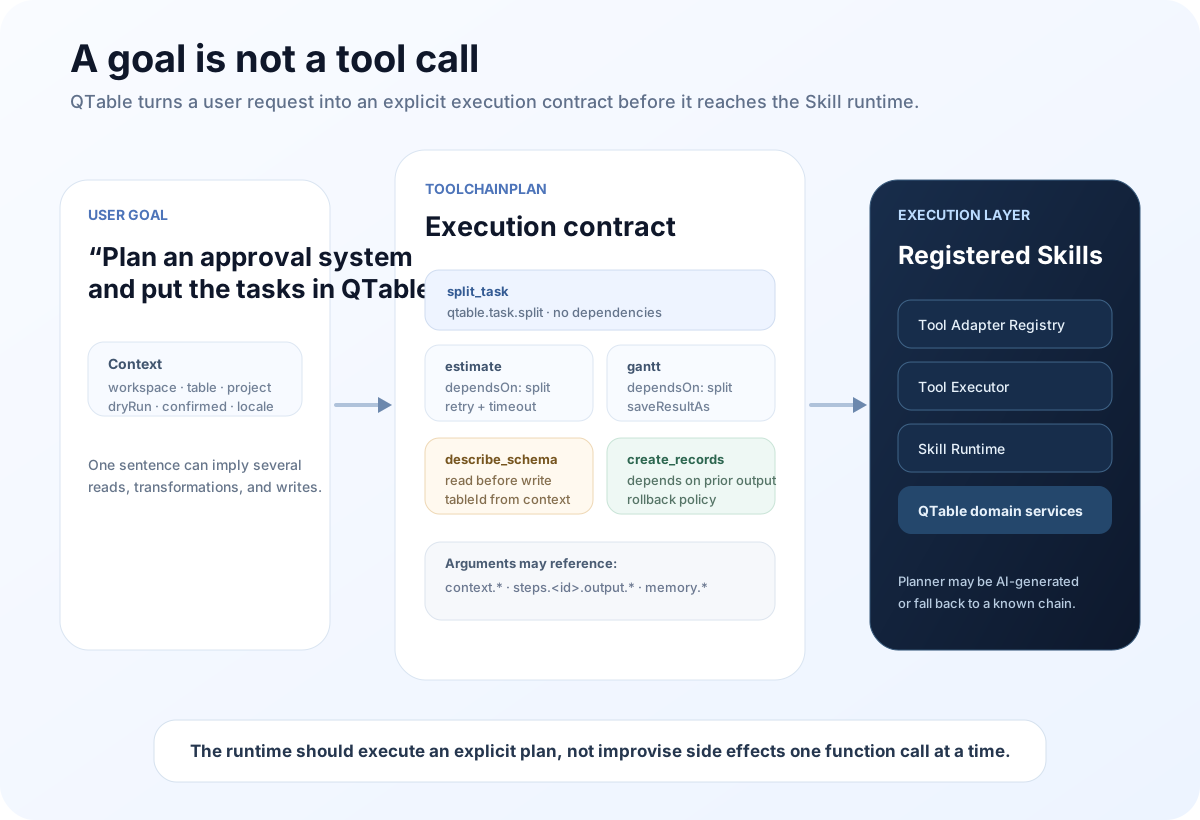
ToolChainPlan 的价值,是把“下一步做什么”变成显式数据
QTable 当前这层契约定义在 app/schemas/tool_chain.py。
核心对象是 ToolChainPlan 和 ToolChainStepDefinition。
一条 Step 目前可以明确声明:
stepId;- 要调用的
skillName; dependsOn;- arguments;
saveResultAs;- 独立 retry policy;
- rollback strategy;
- timeout。
这几个字段很重要,因为它们把很多本来容易藏在 Prompt 里的东西,拉回到了 Runtime 能理解的结构中。
例如“创建任务之前必须先读 Schema”,不应该只是 Planner Prompt 里的一句建议。
它应该最终落成:
创建 Record 的 Step 明确依赖 Schema Describe Step。
“某一步最多重试两次”,也不应该靠模型自己记住。
它应该进入 retry policy。
“这一步写入后,如果后续失败,需要删除刚创建的 Record”,应该是 rollback contract,而不是一句自然语言备注。
这也是我认为 Agent Runtime 和普通 Tool Calling 最大的差别之一。
Tool Calling 关心单次调用。Runtime 关心调用之间的关系。
Planner 可以由模型生成,但执行规则不能由模型临场发挥
当前 app/services/tool_chain.py 支持两种 Plan 来源。
如果请求直接带了 Plan,Runtime 使用调用方提供的 Plan。
如果没有,并且 autoPlan=true,系统会读取当前 Workspace 可用的 Skill Manifest,再让模型输出结构化 ToolChainPlan。
如果模型不可用或规划失败,还有一条 fallback path。当前 fallback 会优先拼出类似这样的链路:
任务拆解;
工作量估算;
Gantt;
目标表 Schema Describe;
创建任务记录。
我喜欢这个设计里的一点是:Planner 可以不可靠,但执行契约必须可靠。
模型可以参与决定“应该有哪些步骤”。
但真正执行时,Runtime 只接受注册过的 Skill、结构化 Arguments、明确的 Dependency、Retry、Timeout 和 Rollback 配置。
换句话说,LLM 是 Planner 的一种实现,不是 Runtime 本身。
这个边界很重要。
如果哪天换掉模型,或者某个 Workspace 禁止部分 Skill,执行层不应该跟着重写。
上一步的输出,应该通过 Context 传递,而不是重新让模型复述
多 Tool Chain 很快会遇到第二个问题:
第二个 Tool 怎么拿到第一个 Tool 的结果?
QTable 当前的参数解析允许 Step Arguments 从三类位置取值:
- 当前 Context;
- 前面 Step 的 Output;
- Chain Memory。
Runtime 在每一步完成后,会把结果放进 steps_output 和 memory。如果 Step 配置了 saveResultAs,同一个结果还会以更稳定的业务名称保存。
于是后面的 Step 可以说:
我要前面任务拆解的结果。
我要 Context 里的目标 Table。
我要之前保存的 Gantt Data。
而不是把整段结果重新交给模型,请它再生成一遍参数。
这是一个看起来很小的区别,但对稳定性非常重要。
模型复述数据会引入新的不确定性。
结构化数据传递则只是 Runtime 在取值。
在 Agent 系统里,能不用模型完成的确定性工作,最好不要再让模型做一次。
dependsOn 已经能表达 DAG,但“能表达”和“已经正确调度”是两回事
这是这一篇最需要说清楚的地方。
QTable 的 Tool Chain Schema 已经有 dependsOn。
Planner 也会根据这些依赖生成一个 langGraphSpec,里面包含 nodes 和 edges。
从数据模型看,我们已经可以表达这样一张图:
任务拆解完成以后,工作量估算、Gantt 和 Schema Describe 分成几条支路;等需要的上游都结束以后,再进入创建 Record。
这是一张 DAG。
但我不会因此写“QTable 当前已经完成了 DAG 并行调度”。
因为代码还没有到这一步。
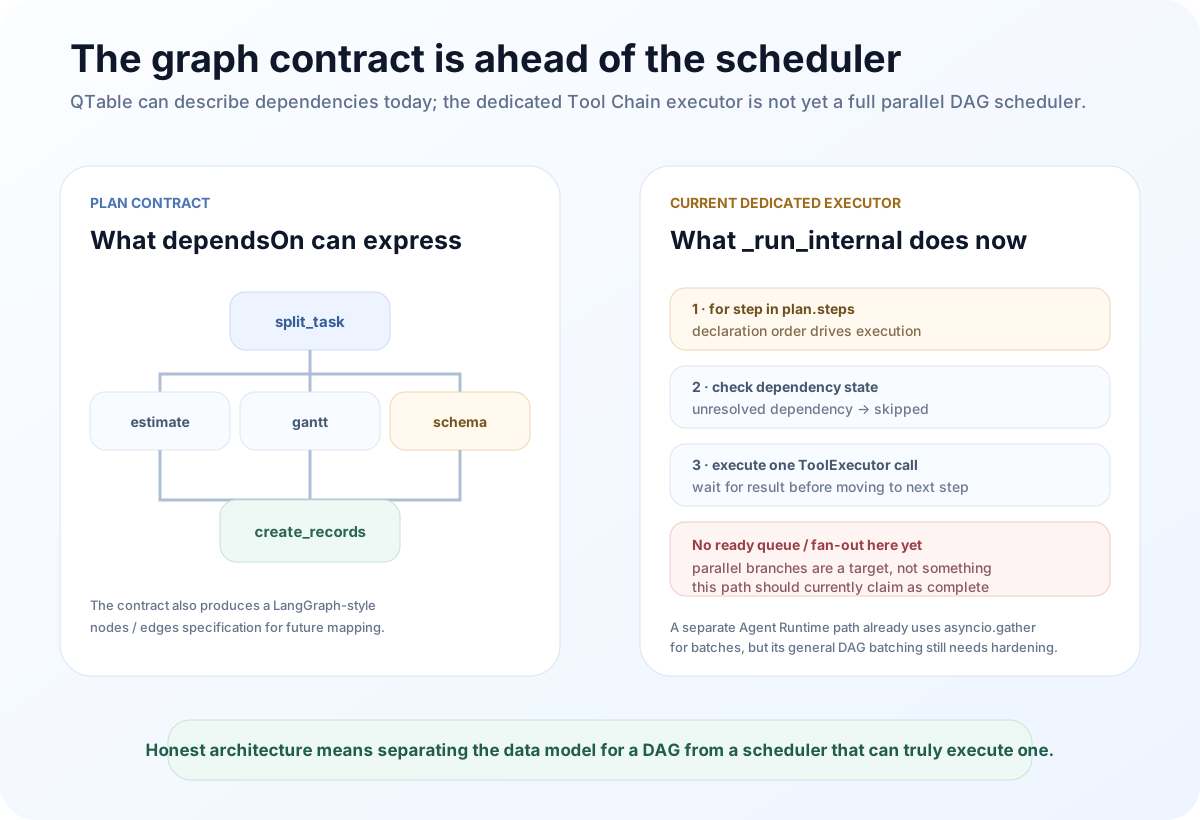
当前专用 ToolChainRuntimeService._run_internal 实际上是按 plan.steps 顺序遍历。
每一步开始前,它会检查 dependsOn 指向的 Step 是否已经进入 completed / rolled_back。
如果依赖还没有准备好,这一步会被标记 skipped。
然后 Runtime 执行当前 Tool,等它结束,再继续下一步。
也就是说,现在 Plan 最好本身就是拓扑有序的。
架构文档 docs/multi-tool-chain-runtime-architecture.md 里描述的“ready queue + 同批并行 + 拓扑调度”,目前更接近目标架构,而不是这条专用 Runtime 已经完全实现的事实。
QTable 还有另一条 app/agent_runtime/executor.py 路径,它已经会对 batch 使用 asyncio.gather。
但它当前的 ToolPlanEngine.get_execution_order 在预计算 batch 时,仍然依赖 Step 的运行时 completed 状态。也就是说,它已经有并行执行的骨架,但我同样不会把它描述成成熟的通用 DAG Scheduler。
这里真正还缺的,是一个更清晰的调度内核:
先验证图是否合法;
检测未知依赖和 Cycle;
基于 indegree 建 ready queue;
同时调度真正互不依赖的 Step;
一个 Step 完成后再释放后继;
失败时按策略决定哪些分支跳过、哪些继续。
这部分是第五篇里最重要的“未完成项”。
不是因为 Schema 不够,而是因为执行图最终要靠 Scheduler 兑现。
并行不是“多开几个 asyncio task”这么简单
假设 estimate 和 gantt 都只依赖 split_task。
理论上它们可以并行。
但如果两条支路都要修改同一张表呢?
如果两个 Step 都使用同一个外部系统限流配额呢?
如果一个 Step 是读,另一个是写,而且写会改变读结果呢?
所以真正的并行调度至少还要考虑几类约束:
Dependency 是最基本的一层。
Side Effect 是第二层。两个无依赖的写操作不代表一定适合并发。
Resource / Rate Limit 是第三层。即使业务上可以并行,也可能因为 Provider 或外部 API 限流,需要控制并发数。
Context Consistency 是第四层。两个分支都基于同一个 Snapshot 运行,后续合并时要知道哪些事实可能已经变化。
这也是为什么我不想把 Multi Tool Runtime 简化成 asyncio.gather。
并发只是调度结果,不是调度规则。
Retry 最重要的问题不是“重几次”,而是“能不能安全重”
QTable 的 Step 有独立 Retry Policy。
默认值目前是最多两次尝试,加固定 Backoff。
真正执行重试的是 app/tool_adapter/executor.py。
它不会对任何失败都机械重试。
当前只有 INVALID_INPUT 和 EXECUTION_FAILED 这类错误进入自动重试判断。
更重要的是:如果一个 Tool 已经 confirmed,并且它有 Side Effect,而 Skill 没有声明 idempotent,Executor 会阻止自动重试。
这个细节非常重要。
比如“读取 Schema”失败,通常可以放心再试一次。
但“创建 100 条任务”在服务端已经成功、客户端却因为网络问题没收到响应,这时候再自动执行一次,可能就是 200 条任务。
所以真正的 Retry 不是“失败以后再跑一遍”。
它是:
先回答这次操作是否可以重复,再决定要不要重试。
这也是 Agent Runtime 进入真实业务系统之后,和 Demo 最大的区别之一。
Confirmation 是暂停点,不应该只是一个弹窗
当底层 Skill 返回 requires_confirmation 时,Tool Chain Runtime 会把当前 Step 改成 waiting_confirmation。
它还会保存:
- stepId;
- skillName;
- 已解析的 arguments;
- preview metadata;
- 当前 Memory 和 Context。
这已经有了“暂停执行”的基本形态。
但当前专用 Tool Chain API 只有三个入口:
POST /api/tool-chains/run;
POST /api/tool-chains/stream;
GET /api/tool-chains/runs/{run_id}。
还没有一个针对同一 Run 的 confirm / resume endpoint。
这意味着“检测到确认边界并持久化状态”已经存在,但“用户确认后从同一个 checkpoint 接着跑”还没有在这条 API 上闭环。
这也是接下来应该补的地方。
一个真正的 Long-running Runtime,确认不是 UI Event。
它应该是可持久化的 Suspend / Resume 语义。
否则任务一旦跨过请求生命周期,系统很容易退化成“重新跑一遍,再假装是继续执行”。
Rollback 不是魔法事务,而是补偿动作
多 Tool Chain 另一个很容易被说大的词是 Rollback。
如果三个 Tool 分别调用了数据库、外部 API 和一个第三方 SaaS,就不存在一个天然覆盖所有系统的 ACID Transaction。
所以 QTable 当前这层 Rollback 更接近 Saga 里的 Compensation。
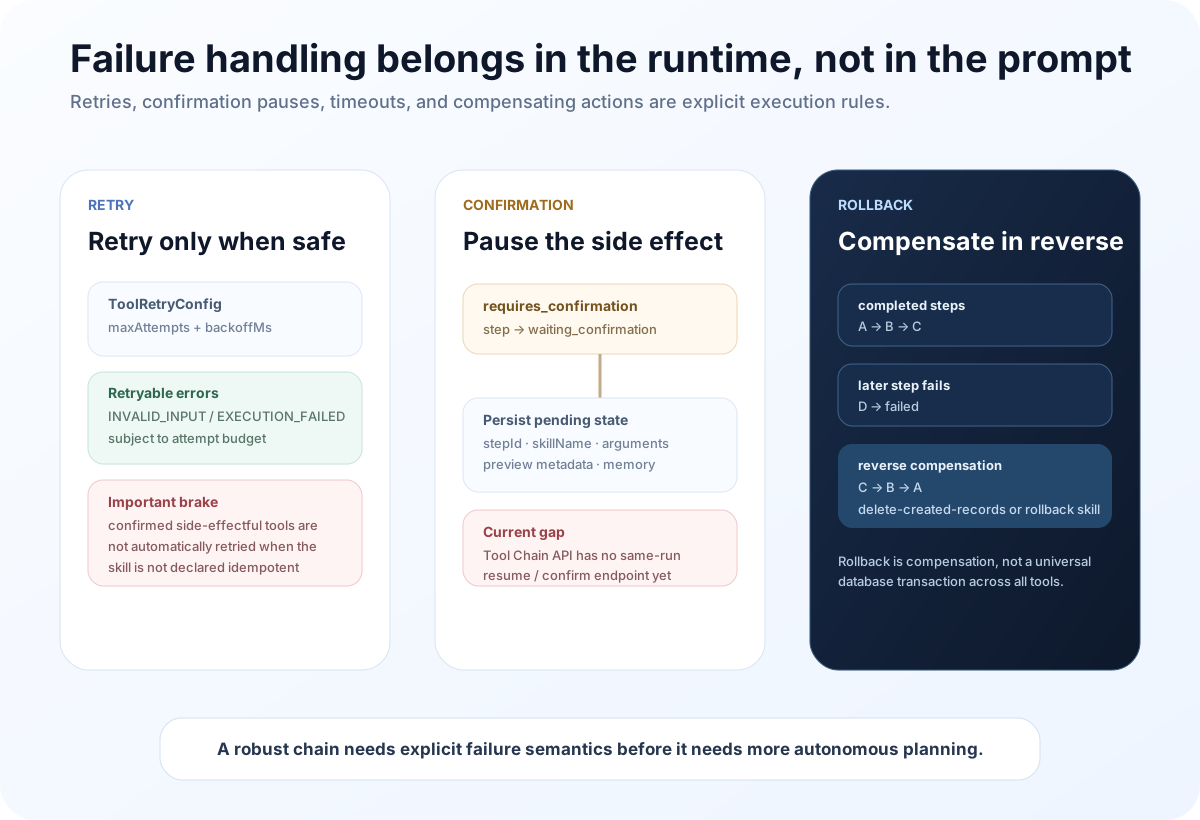
当前 Step Rollback 支持三种声明:
none;
delete_created_records;
调用另一个 rollback Skill。
对于 qtable.task.records.create,即使 Step 没有显式声明 Rollback,当前 Runtime 也会尝试把它视为 delete_created_records。
如果后面的 Step 失败,已经完成的 Step 会按完成顺序倒序进行补偿。
这是一条很合理的基础路径。
但它不是“保证所有东西恢复到从未执行过的状态”。
删除刚创建的 Record 可以补偿数据库状态。
但如果中间某个 Tool 已经发了通知、调用了外部 webhook、生成了不可撤销的第三方副作用,Rollback 的语义就必须由那个具体 Skill 自己定义。
当前 Schema 里还有 best_effort / strict 的 Rollback Mode。
不过服务实现目前并没有真正根据这两个 Mode 分叉出两套行为;现有路径会倒序尝试所有已完成 Step 的补偿,并根据补偿是否失败确定最终状态。
所以这两个 Mode 现在更像已经留好的契约,而不是完全兑现的运行时语义。
这类差异应该写出来,而不是用“支持 strict rollback”一句话带过。
一条 Chain 如果看不见,就很难被长期维护
Multi Tool Runtime 的复杂度还有一个很现实的来源:
它会跑很久。
一次执行可能跨越多个 Skill、几次重试、一个确认暂停,甚至一次回滚。
这时候只在请求最后返回一句:
“执行失败。”
几乎没有调试价值。
QTable 当前会把 Run、Step 和 Event 分开持久化:
tool_chain_runs 保存整个 Run 的 Plan、Context、Memory、Result、状态和 trace id。
tool_chain_step_runs 保存每一步的 Dependency、Input、Output、Attempt Count、Error、Rollback 信息和 Context Snapshot。
tool_chain_event_logs 保存生命周期事件。
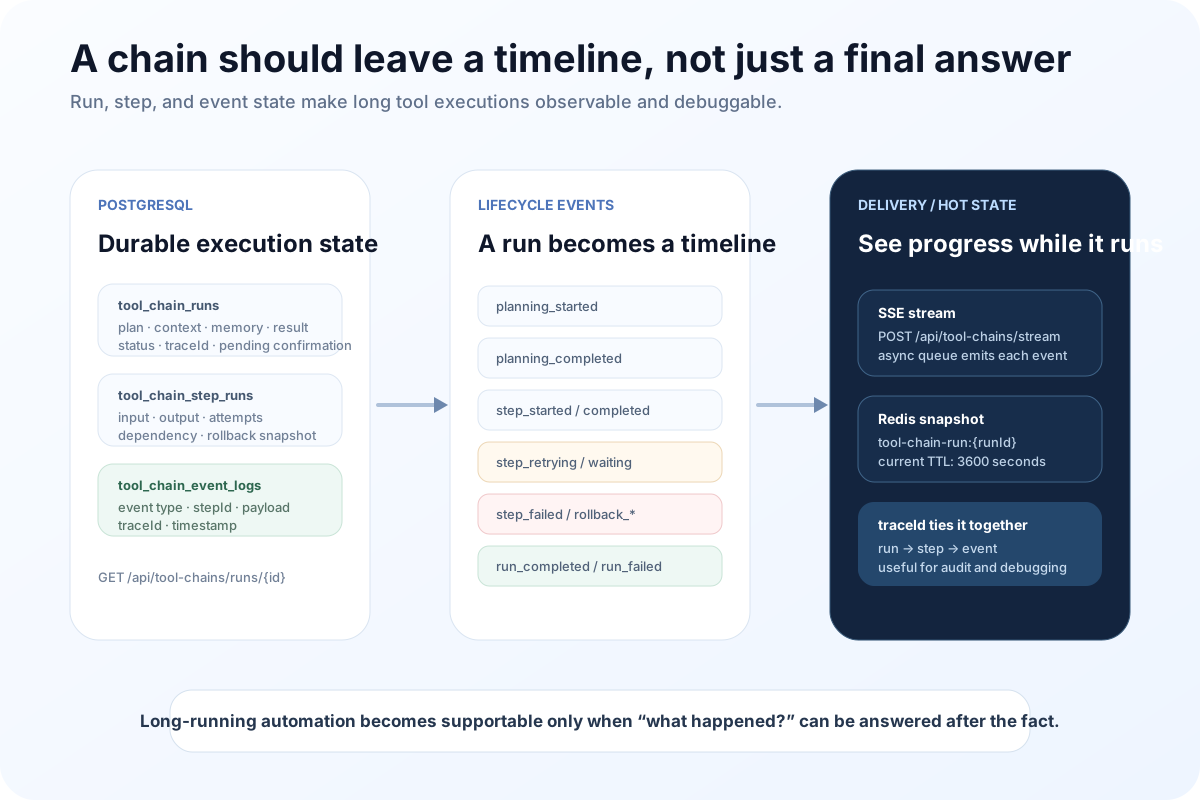
事件包括:
planning started / completed;
step started / completed;
step retrying;
step waiting confirmation;
step failed;
rollback started / completed;
run completed / failed。
/stream 会通过 SSE 把这些事件逐条推给前端。
每次事件更新后,当前 Run Response 还会缓存到 Redis,当前 TTL 是 3600 秒。
这里我更关心的不是“前端有进度条”。
而是:
如果用户说“刚才为什么停了”,后端有数据可以回答。
如果某个 Skill 经常在第二步重试,系统能看见。
如果 Rollback 只回滚了一半,也有 Event 和 Step State 可以追。
可观测性不是 Runtime 的附属功能。
它是多步骤执行能够进入生产环境的基本条件。
QTable 现在其实有三层容易被混在一起的 Runtime
看代码时还有一个地方很容易困惑。
QTable 现在并不只有一个叫 Runtime 的东西。
至少有三条相关路径:
Multi Tool Chain Runtime
重点是 ToolChainPlan、Step Dependency、Memory、Retry、Rollback、SSE 和 Run Persistence。
Agent Runtime
重点是 Intent → Plan → Preview / Confirm → Tool Execution → Observation 的通用 Agent 状态机,并且已经开始按 batch 使用并行执行。
Agent Workflow / LangGraph
已经有真正的 StateGraph,把 Planner、Tool Executor、Observer、Retry、Human Approval、Finalize 作为 Node,并支持 checkpoint / resume 方向。
它们之间有不少共用概念,但现在还不是一套完全统一的执行内核。
这也是接下来架构上最值得收敛的地方。
我不希望未来出现:
Tool Chain 有一套 Retry。
Agent Runtime 又有一套 Retry。
LangGraph Workflow 再有第三套 Retry。
真正稳定以后,它们应该逐渐共享:
同一个 Tool Contract;
同一个 Context;
同一套 Confirmation;
同一种 Step State;
同一条 Observability;
同样的 Permission / Side Effect 规则。
至于上层是“一次 Agent 请求”、一个固定 Workflow,还是模型动态规划的一条 Chain,只应该是编排方式不同。
执行语义不应该因此变三套。
我会怎么继续补这个 Runtime
如果按当前代码继续往下做,我会优先补四件事。
第一,真正的 DAG Scheduler。
不是依赖 Plan 顺序,而是显式 Validation、Cycle Detection、Indegree、Ready Queue、并发上限和 Successor Release。
第二,Checkpoint / Resume。
特别是 Confirmation 和 Long Task,必须能从持久化 Step State 恢复,而不是重新创建一个 Run。
第三,把 Retry、Rollback、Confirmation 收敛到一个执行层。
不要让 Tool Chain、Agent Runtime、LangGraph Workflow 各自再实现一遍近似逻辑。
第四,给 Side Effect 加更明确的并发与补偿契约。
例如是否 Idempotent、是否可并行、是否有 Compensation、是否需要 Serial Key,这些都应该成为 Tool Metadata,而不是由 Planner 猜。
这几件事完成以后,“Multi Tool Chain”才真正从一个很好的 Plan Contract,变成一个可以长期承担复杂业务工作的 Runtime。
Agent 真正需要的不是更多 Tool,而是更明确的执行语义
Tool 数量很容易增长。
查表。
搜索。
生成 Gantt。
发通知。
创建任务。
更新负责人。
调用第三方系统。
但 Tool 越多,并不会自然得到一个更强的 Agent。
如果没有执行语义,Tool 越多,失败方式只会越多。
所以我现在更在意的是这些问题:
谁依赖谁?
哪些可以并行?
哪一步失败可以重试?
哪些操作不能自动重试?
哪里必须暂停等人确认?
失败后能补偿什么?
Run 怎么恢复?
整个过程留下了什么证据?
这些问题不是模型参数能解决的。
它们属于 Runtime。
这也是我对 Multi Tool Chain Runtime 最核心的判断:
Agent 的能力不只是“会调用多少 Tool”,而是“系统能不能把多个 Tool 组织成一条可解释、可暂停、可重试、可恢复、可审计的执行链”。
第五篇写的是“怎么执行”。
下一篇我会回到 QTable 本身一个很容易被低估的问题:Grid、Kanban、Gantt 为什么不应该是三套数据。
同一条 Record 如何在不同 View 中保持同一个事实,为什么 View 只能投影和组织数据,而不应该制造第二份业务状态——这会直接决定 AI、Automation 和人工操作最后能不能围绕同一个产品模型协作。
QTable 已经开源
如果你对本文讨论的数据模型、AI 工作流或开源工程实践感兴趣,可以直接阅读代码、提交 Issue 或参与贡献。