
Agent 不該負責所有自動化:QTable 的 Automation Engine 為什麼把確定性執行留給規則系統
AI Native 不代表所有 Workflow 都要交給 Model。本文結合 QTable 目前的 AutomationRule、AutomationEvent、AutomationExecution、ChangeSet、Scheduler、Worker、Retry、Loop Guard 與 Execution History 實作,拆解為什麼已知 Trigger、Condition 和 Action 應該留在確定性的 Rule Engine,以及 Automation 與 Agent 應該如何分工。
做到這個系列第九篇時,一個問題變得越來越重要:
既然 QTable 已經有 Agent、Tool、Context Engine 和 Action Plan,為什麼還需要單獨做 Automation Engine?
表面上看,它們都在「幫使用者自動完成事情」。
使用者可以說:
「任務進入 Review 之後通知負責人。」
Agent 可以理解這句話。
Tool Chain 也可以執行 Notification。
那是不是以後所有 Automation 都交給 Agent 就好?
我現在的答案很明確:
不是。能夠明確寫成 Trigger → Condition → Action 的工作,應該盡量保持 Deterministic。
Agent 適合處理模糊 Goal。
Automation 適合重複執行已經被產品定義清楚的 Rule。
兩個 Runtime 不是競爭關係。
它們更像 AI Native Work System 裡的兩種執行模式。
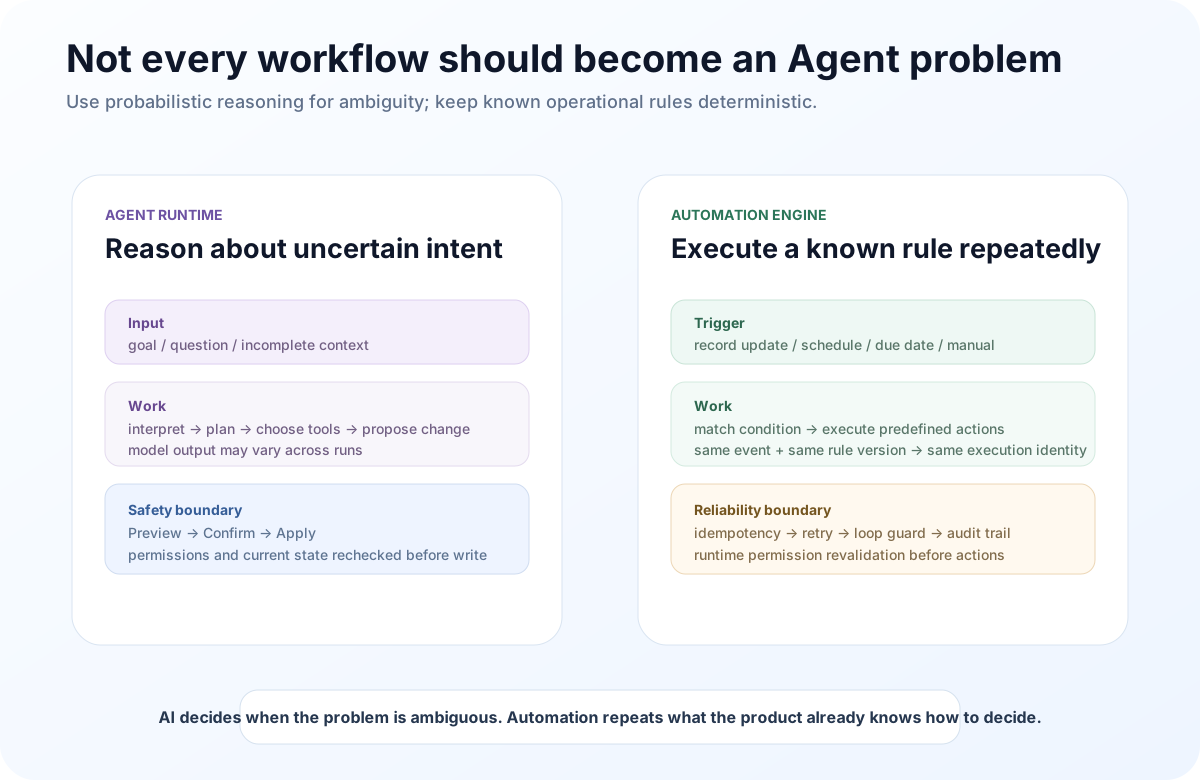
AI Native 不等於 Model Everywhere
AI 產品很容易出現一種誘惑:
只要 Model 足夠強,就讓 Model 判斷所有事情。
例如:
- 判斷 Status 是否變成 Review;
- 判斷 Due Date 是否到期;
- 判斷某個 Number 是否大於 10;
- 決定要不要發 Notification;
- 決定要把某個固定 Field 更新成什麼值。
這些工作 Model 當然都能做。
問題是沒有必要。
如果 Business Rule 已經明確到:
「當 status 從 backlog 變成 review,並且 priority = high 時,通知 assignee。」
那麼再把整條 Record 丟給 Model,讓它重新判斷一次,其實是在把一個 Deterministic Problem 重新變成 Probabilistic Problem。
這也是第五篇 Multi Tool Chain Runtime 提過的一條原則:
能不用 Model 完成的 Deterministic Work,最好不要再讓 Model 做一次。
Automation Engine 就是這條原則在 Product Layer 的落地。
目前 Automation v1 的模型很克制
QTable 後端核心模型在 app/models/automation.py。
它沒有被設計成一個無限自由的 Script Host。
目前主要是三個 Persisted Object。
AutomationRule
描述使用者設定的 Rule。
包含:
- trigger;
- conditions;
- actions;
- timezone;
- max retries;
- version;
- run-as user;
- next run time。
AutomationEvent
描述一個已經發生、等待 Dispatch 的 Durable Event。
包含:
- Table / Record;
- before / after data;
- changed fields;
- actor;
- source;
- trace;
- root event;
- parent execution;
- depth;
- queue status。
AutomationExecution
描述某個 Rule Version 對某個 Event 的一次執行。
包含:
- Rule Version;
- Trigger Event;
- Attempt;
- Action Results;
- ChangeSet IDs;
- Error;
- Next Retry;
- Trace ID;
- Final Status。
這裡最重要的一點是:
Rule、Event、Execution 是三個不同物件。
如果只存 Rule,Event 一來就直接同步執行,很多 Reliability 能力都會消失。
你很難回答:
這次 Rule 為什麼觸發?
哪一個 Action 失敗?
Retry 了幾次?
這次 Execution 用的是 Rule v1 還是 v2?
它寫出了哪些 ChangeSet?
它是不是某個 Automation Chain 的 Child Execution?
QTable 選擇把這些狀態 Persist 下來。
所以 Automation 更接近一個真正的 Runtime,而不是一堆 if。
Trigger 目前只支援幾種明確語意
目前 validation.py 明確支援的 Trigger Type 是:
record.created;record.updated;scheduled;due_date;manual。
這個限制很重要。
Automation Platform 很容易變成「什麼都可以塞」的 JSON Configuration Surface。
QTable v1 比較像是在收緊語意。
例如 record.updated 可以指定:
- 哪些 Field 變化才觸發;
- 單一 Field 時可以指定
from; - 可以指定
to。
因此:
「status 發生變化」
和:
「status 從 backlog 變成 review」
是不同的 Trigger Contract。
Number / Date Value 也會根據 Field Type 先做 Normalize。
Malformed Date 直接 Fail Closed,而不是拿 String 做模糊比較。
Condition 也不是任意 Expression Execution
Condition 支援 and / or Group。
Leaf Operator 會依 Field Type 限制。
Text-like Field 可以做:
- equals;
- not_equals;
- contains;
- not_contains;
- in;
- not_in;
- empty;
- not_empty。
Number / Date 還支援:
- gt;
- gte;
- lt;
- lte。
目前也有明確 Hard Limit。
Condition Nesting 最大深度是 8。
Condition Item 最多 64。
這些限制並不「聰明」。
但它讓 Rule Complexity 可以被預期。
對一個要被 Validate、Retry、Audit、長期 Operate 的系統來說,Predictable Complexity 是優點。
Action v1 也刻意維持很小
目前 Action Type 只有:
update_record;create_record;notify。
Action 在 Persist 前會先被 Validate。
Formula、Auto Number、Created Time、Modified Time、Created By、Modified By 等不可寫 Field,不允許被 Automation 寫入。
Notification Recipient 可以來自:
- Explicit User IDs;
- 某個 Member Field。
但 Runtime 還會再限制到目前 Workspace 裡真實存在的 Member。
這表示目前 Automation Engine 的重點,不是「連接所有 SaaS」。
而是先把 QTable 內部 Business Execution Boundary 做實。
Webhook、Connector、External Action 以後可以加。
但不應該靠放寬目前 Action Contract 偷跑。
Record Write 完成之後,不會在同一個 Request 裡直接同步跑 Automation
這是目前實作裡很重要的一層。
QTable 的 Record Write 原本就會產生 ChangeSet / ChangeItem。
Automation 不要求每一種 Write API 再手動多呼叫一次「觸發規則」。
而是由 Worker 從已經 Applied 的 ChangeItem materialize 出 Durable AutomationEvent。
也就是:
Business Write 先成為 Fact。
ChangeSet 先成為 Audit Fact。
Automation 再對這個 Committed Fact 做後續工作。
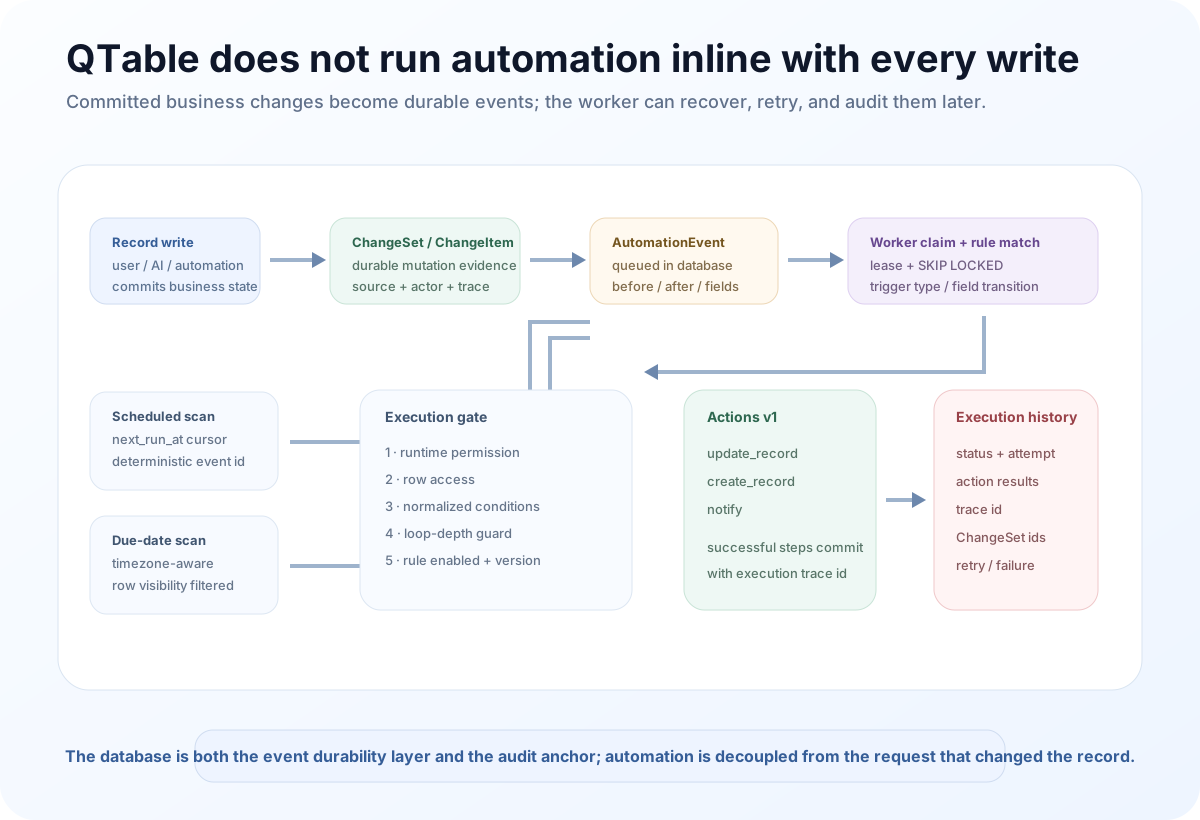
這樣有幾個直接好處。
第一,使用者 Request 不需要等 Automation 執行完成。
第二,Worker Crash 之後 Event 還在。
第三,同一個 ChangeItem 可以透過 Unique Source Identity 防止重複 materialize。
第四,未來新增 Record Mutation Entry Point,不需要每個地方都自己維護 Automation Hook。
只要 Business Write 最後進入同一套 ChangeSet Model,Automation 就可以從共用的 Audit Fact 建立 Event。
這跟第六篇「不同 View 操作同一份 Fact」其實是同一種 Architecture Preference:
不要讓每個入口都維護一套自己的 Side-effect Chain。
Scheduled 和 Due Date 用的是 Durable Cursor,不是暫時 Timer
如果 Periodic Job 只靠 Memory 裡的 sleep,Application Restart 之後很容易忘記自己做到哪裡。
QTable Rule 上有 next_run_at。
Scheduler 會掃描已經 Due 的 Rule。
scheduled 依照 Interval 產生 Synthetic Event。
due_date 則會掃描 Run-As User 目前可見的 Record,再根據:
- Date Field;
- Rule Timezone;
- Offset Minutes;
- Scan Interval;
計算應該觸發的 Record。
這裡也處理了一個常見錯誤:
沒有 Timezone 的 Date Value 要怎麼解讀。
目前邏輯會先用 Rule 的 Timezone 解讀 Local Wall Time,再轉成 UTC。
不會直接把「09:00」當 UTC。
Due Date Event ID 也會用 Rule、Version、Record、Field、Due Time、Offset 等資訊做 Deterministic Generation。
同一個 Reminder Window 掃描兩次,不應該產生兩次 Notification。
這不是 AI Capability。
但這些小地方才真正決定 Automation 能不能被信任。
Idempotency 不代表「永遠不失敗」
Automation 一定會遇到 Failure。
Database 可能暫時異常。
Notification Recipient 可能失效。
Action 之間 Permission 可能改變。
Rule 在 Retry 前可能被修改。
真正需要設計的是:
失敗以後再來一次,會發生什麼?
QTable 的 AutomationExecution 有一個 Unique Contract:
automation_id + automation_version + trigger_event_id
同一個 Event 在同一個 Rule Version 下,最後會收斂到同一個 Execution Identity。
但 Multi-action Rule 還有另一個問題。
假設:
- create_record;
- notify。
第一步成功、第二步失敗。
如果 Retry 時全部從頭開始,很可能建立 Duplicate Record。
所以 Executor 會 Persist 每一個 Action Result。
Retry 時,已經是 succeeded 的 Action 直接 Skip。
只重試沒有成功的部分。
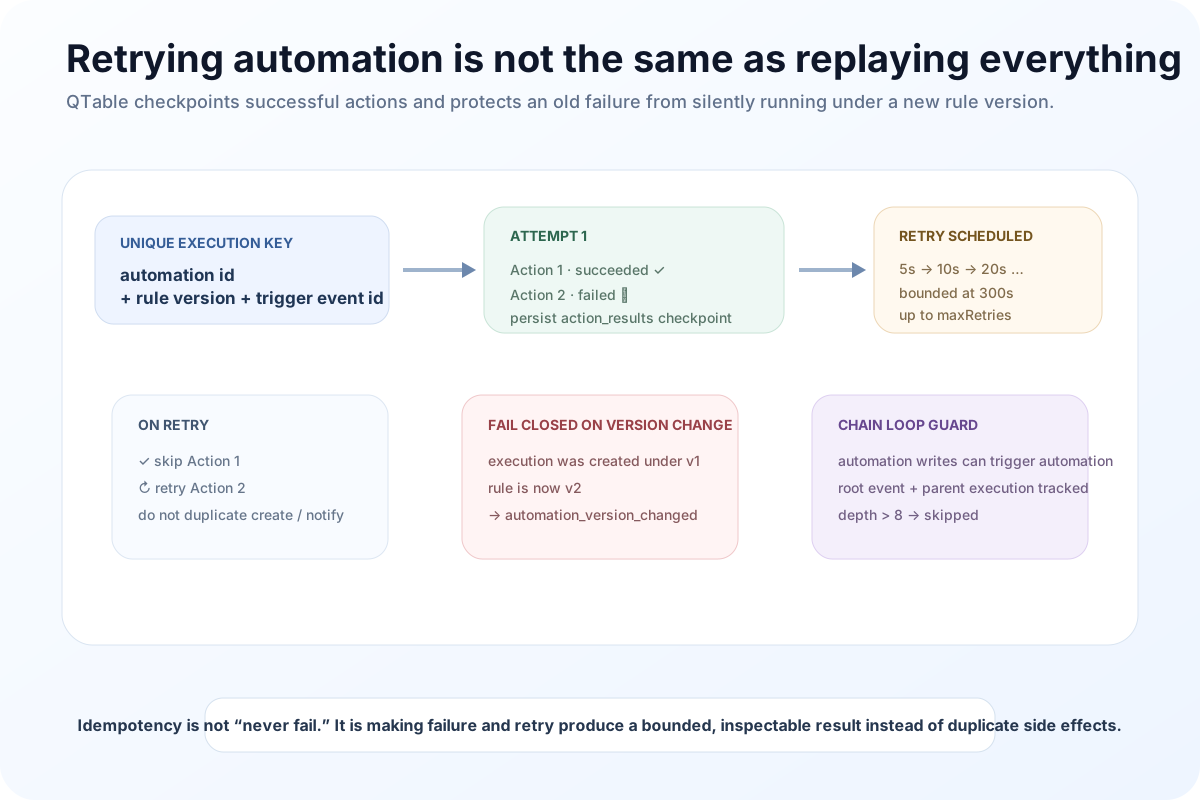
目前 Retry Delay 從 5 秒開始做 Exponential Backoff。
上限 300 秒。
Rule 的 maxRetries 目前最多允許 10。
Execution 最後可能是:
- succeeded;
- skipped;
- failed;
- partially_failed。
這裡有一個需要明確寫出的 Boundary:
目前多個 Action 不是一個跨 Action 的 Global Atomic Transaction。
前面的 Action 可能已經 Commit。
後面的 Action 才 Failure。
系統不是靠「全部 Rollback」保證 Reliability。
而是靠:
- Action Checkpoint;
- Retry;
- ChangeSet;
- Partially Failed Status;
把真正已經發生的世界記錄下來。
這比假裝所有 External Side Effect 都可以 Rollback 更實際。
Rule Version 是 Execution Semantics 的一部分
假設:
Rule v1:
「建立一條 Record,再通知 A。」
Create 成功。
Notify 失敗。
在 Retry 之前,使用者把 Rule 改成 v2:
「不要建立 Record,改成通知 B。」
如果舊 Retry 直接載入最新 Rule 執行,整段 History 就失去可解釋性。
所以 QTable Execution 會保存 automation_version。
當 Trigger / Condition / Action / Timezone / Retry Semantic 改變時,Rule Version 會增加。
Retry 前,如果 Runtime 發現 Current Rule Version 和原 Execution Version 不一致,會直接終止:
automation_version_changed
舊 Execution Fail Closed。
新的語意要透過 New Event 或 New Manual Run 開始新的 Execution。
核心原則是:
Retry 應該重試當時那次 Execution,而不是把舊 Failure 偷偷重新解釋成新 Rule。
Automation 寫 Record,也可能再觸發 Automation
Rule A 更新 Field X。
Field X 的變化觸發 Rule B。
Rule B 更新 Field Y。
Field Y 又可能觸發 Rule A。
所以 Event / Execution 會保存:
root_event_id;parent_execution_id;depth。
Automation Write 使用自己的 trace_id。
後續 ChangeSet 被 Materialize 成 Event 時,可以找到 Parent Execution,把 Depth 加一。
目前 Automation Chain 最大深度是 8。
超過後 Execution 會被標記:
skipped / loop_guard
這不是完整 Graph Cycle Detection。
但它先建立一個 Hard Safety Ceiling。
對 v1 來說,這很務實。
Worker 會先 Claim Event,再開始執行
目前 Worker 是 Application Internal 的 Async Polling Worker。
每一個 Cycle 會:
- 從 ChangeSet Materialize Record Event;
- 掃 Scheduled / Due Rule;
- 處理 Due Retry;
- Claim Event;
- Dispatch Rule。
Event Claim 使用 Database Row Lock 和 skip_locked。
Claim 後 Event 變成 processing。
同時 available_at 被當成 Lease Deadline。
目前 Event Lease 是 300 秒。
如果 Worker Claim 後 Crash,Lease Expire 之後其他 Worker 可以重新拿。
Retry Claim 也使用同樣思路。
目前 Automation Queue 沒有引入 Kafka 或 RabbitMQ。
Database 就是 Durable Queue。
對目前 Alpha 規模,這減少了一層 Deployment Complexity。
但它也代表 Runtime 是 Polling-based。
Latency / Throughput 會直接受到 Poll Interval、Batch Size、Database Scan 和 Worker Count 影響。
如果未來 Automation Scale 顯著成長,可能需要更獨立的 Worker / Queue Plane。
這是 Scaling Boundary,不代表目前沒有 Durable Event。
Enabled Rule 不是永久 Permission Ticket
第七篇提過:
Agent 權限不能高於目前使用者。
Long-lived Automation 也有同樣問題。
一條 Rule 可以 Enabled 幾個月。
所以 Rule 保存 run_as_user_id。
建立 Rule 時代表 Creator。
Executable Semantic 被修改時,Run-As Identity 會更新成目前編輯 Rule 的 User。
但 Identity 本身不是永久 Grant。
每一次真正 Execution,Runtime 都會重新檢查:
這個 Run-As User 現在對 Table 還有沒有 Action 所需要的 Permission。
只有 Notification,至少需要 Read。
Create / Update Record 則需要 Update。
Record-triggered Execution 還會檢查 Row Visibility。
而 update_record 在每一次真正 Write 前,還會再做一次 Row Access Check。
原因很實際:
前一個 Action 可能剛剛修改了控制 Row Permission 的 Member Field。
所以不能因為 Execution 開始時有權限,就假設後面的 Action 一直有權限。
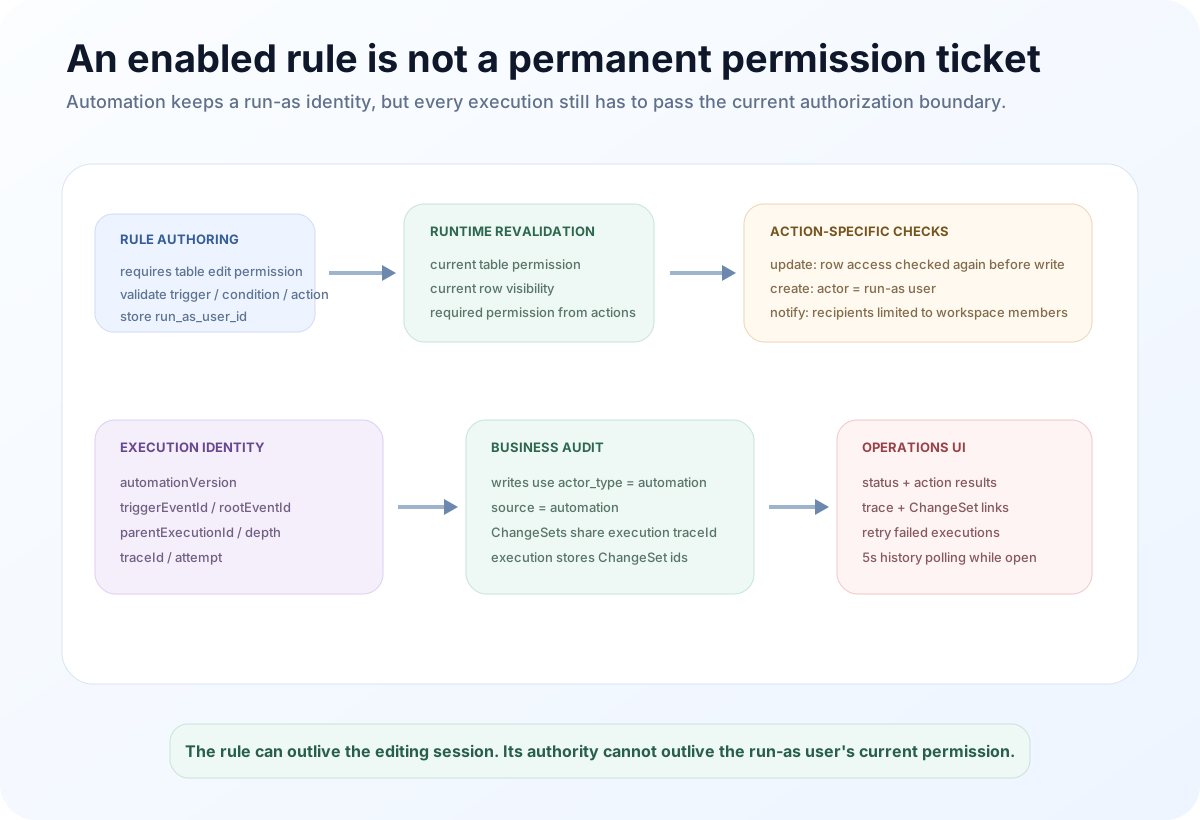
現有 Test 也專門覆蓋 Permission Loss。
如果 Run-As User 後來失去 Access,Automation 不會繼續修改 Record。
也就是說:
Enable Rule 不是永久授權。
Audit 不能只記一句「Automation succeeded」
Automation 寫 Record 時,會沿用 QTable 的 ChangeSet System。
Mutation 使用:
actor_type = automation;source = automation;- Execution 的
trace_id。
Execution 完成後,還會把相同 Trace 下的 ChangeSet IDs 收集回來。
所以 Execution History 不只可以顯示:
「成功。」
還能保留:
- Rule Version;
- Attempt;
- 每個 Action Result;
- Record;
- Trace ID;
- ChangeSet IDs。
這個連結很重要。
因為 Automation Observability 不能停在 Worker Log。
Business User 真正關心的是:
這條 Automation 到底修改了哪些 Business Fact?
ChangeSet 就是 Automation Runtime 和 Business Audit 之間的 Bridge。
QTableUI 已經不是 Placeholder Automation Page
目前 QTableUI 已經有真正的 Automation Center。
而且有專門的 UI Contract Check,防止之後 Regression 回 Placeholder。
Editor 會對應 Backend v1 的 Trigger / Action Family。
Save 前先呼叫 validateAutomation。
Save 完再從 Server 重新讀取 Rule,確認 Persisted State。
對已保存 Rule,UI 可以呼叫 automationPreview。
Preview 會顯示:
- Condition 是否 Match;
- 是否會 Execute;
- Required Permission;
- Action Summary。
這裡要特別區分:
Preview 是 Preview。
Manual Run 是 Real Execution。
目前 UI Contract 還要求 Manual Run 必須明確告訴使用者:
「這不是模擬預覽。」
因為 runAutomation 會真的 Create / Update Data。
Manual Run 只繞過 Trigger Matching。
不會繞過 Validation 或 Runtime Permission。
這和第三篇 Preview → Confirm → Apply 的 Product Principle 很接近:
使用者應該清楚知道系統現在是在「展示結果」,還是在「造成結果」。
Execution History 是產品介面,不只是 Debug Console
目前 Execution History Drawer 打開時會每 5 秒 Poll。
可以看到:
- Execution Status;
- Attempt;
- Rule Version;
- Error Code / Message;
- 每個 Action Result;
- Record;
- Trace ID;
- ChangeSet IDs。
Failed / Partially Failed Execution,在使用者具備 Edit Permission 時可以 Retry。
所以 Automation Center 不應該只被理解成 Rule Editor。
它還有一半其實是 Operations Console。
Rule 建立只是開始。
長期運行以後更重要的是:
哪些 Rule 在 Fail?
是不是同一個 Error 一直發生?
Retry 有沒有恢復?
有沒有 Duplicate Side Effect?
哪些 Business Change 是這個 Rule 寫出來的?
未來 Operations History 甚至可能比 Editor 本身更重要。
目前實作仍然有清楚 Boundary
目前 v1 已經是一個真正 Runtime,但不是 Unlimited Workflow Platform。
1. Action Family 還很窄
目前只有:
- update_record;
- create_record;
- notify。
還沒有 Generic Webhook、HTTP Request、Connector Action、Skill Action。
每增加一種 External Action,都要同時回答:
Permission 怎麼定義?
Secret 怎麼保存?
Retry 是否安全?
Idempotency 怎麼做?
Audit 怎麼記?
External Side Effect 能不能 Duplicate?
2. Trigger 仍以 Internal / Time-based 為主
目前沒有 Record Delete Trigger、Webhook Trigger、Generic External Event Trigger。
主要是 QTable Record Change、Schedule、Due Date 和 Manual。
這會直接銜接 Roadmap 裡的 Table-as-API、Webhook 和 Connector Platform。
3. Action Sequence 是 Linear,不是 DAG
Rule 目前是一個 Ordered Action List。
沒有 Branch。
沒有 Parallel Node。
沒有 Explicit Compensation Graph。
這和第五篇 Multi Tool Chain Runtime 的 DAG 問題不同。
如果未來 Automation 也走向 DAG,要很謹慎判斷哪些 Runtime 能力可以 Reuse,哪些 Deterministic Rule Semantic 必須保持獨立。
4. Automation 明確要求 Database Backend
GraphQL Layer 直接要求:
Automations require database backend.
Legacy File Backend 不會假裝提供相同 Durable Queue、Locking、Retry 和 Execution Semantics。
我認為這是正確選擇。
可靠 Automation 最危險的事情之一,就是在不具備 Durability 的 Backend 上假裝「也能跑」。
5. Worker 還是 Application Polling Worker
目前已經有:
- Durable Event;
- Lease;
- Skip Locked;
- Batch;
- Retry。
但 Worker Lifecycle 仍然很靠近 QTable Application Runtime。
未來更高 Throughput、Isolation、Independent Scaling、Queue Metrics、Dead Letter 等能力,可能需要獨立 Worker Plane。
這屬於 Future Hardening,不是目前已完成能力。
Agent 和 Automation 應該合作,而不是互相取代
真正有意思的未來不是:
Agent 取代 Automation。
而是:
Agent 幫使用者 Author、Explain、Diagnose Automation;Automation 負責長期 Deterministic Execution。
例如使用者說:
「高優先級任務進入 Review 後提醒負責人,如果三天沒完成再提醒一次。」
Agent 可以:
理解 Intent。
找到哪個 Field 是 Priority。
哪個是 Status。
哪個是 Assignee。
哪個是 Due Date。
Generate Automation Draft。
Explain Trigger Condition。
但一旦使用者確認 Rule:
後面的每一次執行都不應該再呼叫 Model。
應該回到:
Trigger → Condition → Action。
這會形成一個很清楚的 Product Split:
AI 是 Rule Authoring Interface。
Automation Engine 是 Rule Execution Runtime。
AI Native Work System 兩個都需要。
Automation 真正要消滅的是「每次重新解釋」
Traditional Automation 常讓人覺得太 Mechanical。
AI Product 又很容易走到另一個極端:
每次都重新理解一次。
更合理的中間路徑是:
第一次,用 AI 把 Intent 變成 Structured Rule。
之後,用 Deterministic Runtime 重複執行。
Business Rule 改變,再讓 AI 幫你修改 Rule。
而不是每一個 Record Update,都重新問 Model:
「這一次要不要通知?」
這不只比較便宜。
更重要的是:
更容易 Explain。
更容易 Test。
更容易 Retry。
更容易 Audit。
也更容易知道系統為什麼做了這件事。
所以第九篇最想留下的結論是:
AI Native 不代表把 Deterministic Work 交給 Model。成熟的 AI Native System,應該知道什麼時候停止 Reasoning,開始執行 Rule。
QTable 目前 Automation Engine 已經有 Rule / Event / Execution 三層模型、ChangeSet Event Materialization、Scheduled / Due Trigger、Typed Condition、Run-As Permission、Action Checkpoint、Retry、Rule Version、Loop Guard、Trace、ChangeSet Audit 和真實 Execution History。
同時,它仍然是一個 v1:
Trigger / Action Family 有限。
Worker 仍是 Database-backed Polling。
Action Sequence 仍是 Linear。
Connector / Webhook / External Side Effect Contract 還需要繼續設計。
這些 Boundary 越清楚,後續越容易安全擴展。
第十篇也會是這個系列的最後一篇。
我會把視角從「功能如何正確執行」移到「系統如何長期活著」:
一個能跑起來的 QTable,怎麼變成一個能長期 Upgrade、Backup、Restore、Observe 和 Operate 的 Self-hosted System。
真正進入 Production 以後,最後一個 Engineering Question 通常不是:
「Feature 有沒有。」
而是:
出問題之後,我們知不知道發生了什麼;Upgrade 失敗之後,我們回不回得來。
QTable 已經開源
如果你對本文討論的資料模型、AI 工作流程或開源工程實踐有興趣,可以直接閱讀程式碼、提交 Issue 或參與貢獻。