
Agent 不该负责所有自动化:QTable 的 Automation Engine 为什么把确定性执行留给规则系统
AI Native 不意味着所有工作流都要交给模型。本文结合 QTable 当前 AutomationRule、AutomationEvent、AutomationExecution、ChangeSet、Scheduler、Worker、Retry、Loop Guard 与 Execution History 实现,拆解为什么已知触发器、条件和动作应该留在确定性的规则引擎里,以及 Automation 和 Agent 应该如何分工。
做到这个系列第九篇时,一个问题变得越来越重要:
既然 QTable 已经有 Agent、Tool、Context Engine 和 Action Plan,为什么还需要单独做 Automation Engine?
看起来它们都在“帮用户自动完成事情”。
用户说一句:
“任务进入 Review 之后通知负责人。”
Agent 可以理解这句话。
Tool Chain 也可以执行通知。
那是不是以后所有自动化都交给 Agent 就好了?
我现在的答案很明确:
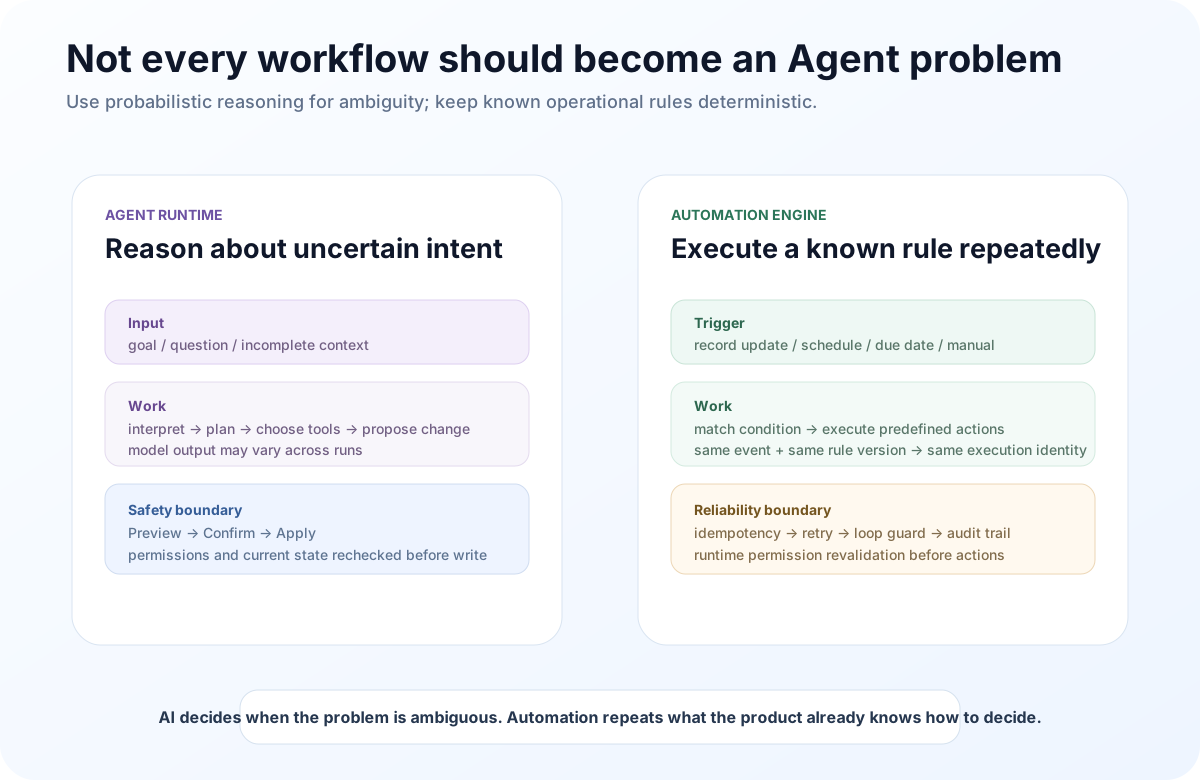
不是。能被明确写成 Trigger → Condition → Action 的工作,应该尽量保持确定性。
Agent 适合处理模糊目标。
Automation 适合重复执行已经被产品定义清楚的规则。
这两个系统不是竞争关系。
它们更像 AI Native 工作系统里的两种执行模式。
AI Native 不等于 Model Everywhere
AI 产品很容易有一种诱惑:
只要模型足够强,就让模型判断所有事情。
比如:
- 判断状态是不是变成了 Review;
- 判断截止日期是不是到了;
- 判断某个字段是不是大于 10;
- 决定要不要发通知;
- 决定要把某个固定字段更新成什么值。
这些工作模型当然能做。
问题是没有必要。
如果业务规则已经明确到:
“当 status 从 backlog 变成 review,并且 priority = high 时,通知 assignee。”
那么再把整条 Record 发给模型,让模型重新判断一次,实际上是在把一个确定性问题重新变成概率问题。
这也是第五篇写 Multi Tool Chain Runtime 时我提过的一条原则:
能不用模型完成的确定性工作,最好不要再让模型做一次。
Automation Engine 就是这条原则在产品层面的落地。
当前 Automation v1 的模型很克制
QTable 当前后端的核心模型在 app/models/automation.py。
没有设计成一个无限自由的脚本平台。
目前主要是三个对象:
AutomationRule
描述规则本身。
里面有:
trigger;conditions;actions;timezone;max_retries;version;run_as_user_id;next_run_at。
AutomationEvent
描述一个已经发生、等待处理的事件。
它保存:
- Table / Record;
- before / after data;
- changed fields;
- actor;
- source;
- trace;
- root event;
- parent execution;
- depth;
- queue status。
AutomationExecution
描述某一条 Rule 在某一个 Event 上的一次执行。
它保存:
- Rule Version;
- Trigger Event;
- Attempt;
- Action Results;
- ChangeSet IDs;
- Error;
- Next Retry;
- Trace ID;
- 最终状态。
这里最重要的一点是:
Rule、Event、Execution 是三个不同对象。
如果只存 Rule,然后事件来了直接同步执行,就会丢掉大量可靠性能力。
你会很难回答:
这次规则到底为什么触发?
失败的是第几个 Action?
重试过几次?
这次执行使用的是规则 v1 还是 v2?
它写了哪些 ChangeSet?
它是不是某条 Automation Chain 的子执行?
QTable 选择把这些状态持久化下来。
这也让 Automation 更接近一个真正的 Runtime,而不是一个 if 语句集合。
Trigger 目前只支持几种明确语义
当前 validation.py 明确允许的 Trigger 类型是:
record.created;record.updated;scheduled;due_date;manual。
这其实很重要。
因为 Automation 平台最容易做成一个“什么都能配”的 JSON 黑洞。
但 v1 更像是在收紧语义。
例如 record.updated 可以指定:
- 哪些 Field 变化才触发;
- 单字段时可以指定
from; - 可以指定
to。
也就是说:
“status 发生变化”
和:
“status 从 backlog 变成 review”
是不同的 Trigger。
对于 Number / Date Field,Trigger Value 还会先做类型归一化。
日期输入不合法时直接 Fail Closed,而不是拿字符串做模糊比较。
Condition 也不是任意表达式执行
当前 Condition 允许 and / or Group。
Leaf Condition 根据 Field Type 限定 Operator。
文本类型可以做:
- equals;
- not_equals;
- contains;
- not_contains;
- in;
- not_in;
- empty;
- not_empty。
Number / Date 还可以做:
- gt;
- gte;
- lt;
- lte。
同时实现里有明确上限:
Condition Nesting 最大深度 8。
Condition Item 最多 64。
这些限制并不“智能”。
但它们让 Automation Definition 有可预测的复杂度。
对于一个以后需要长期运行、重试、审计的规则系统,我觉得这种约束比“允许用户执行任意表达式”更健康。
Action v1 也刻意只做了三类
当前 Action 类型是:
update_record;create_record;notify。
而且 Action 在保存之前会先校验。
Formula、Auto Number、Created Time、Modified Time、Created By、Modified By 这类非可写 Field 不允许被 Automation Action 写入。
Notification Recipient 可以来自:
- 显式 User IDs;
- 某个 Member Field。
但运行时还会再限制到当前 Workspace 的真实 Member。
这说明当前 Automation Engine 的重点不是“连接世界上所有 SaaS”。
它先把 QTable 自己内部的业务执行边界做实。
Webhook、Connector、External Action 这些能力以后可以扩展。
但它们不应该靠放宽当前 Action Contract 来偷跑。
Record 写入以后,并不会在请求里直接同步跑 Automation
这是当前实现里我觉得很关键的一层。
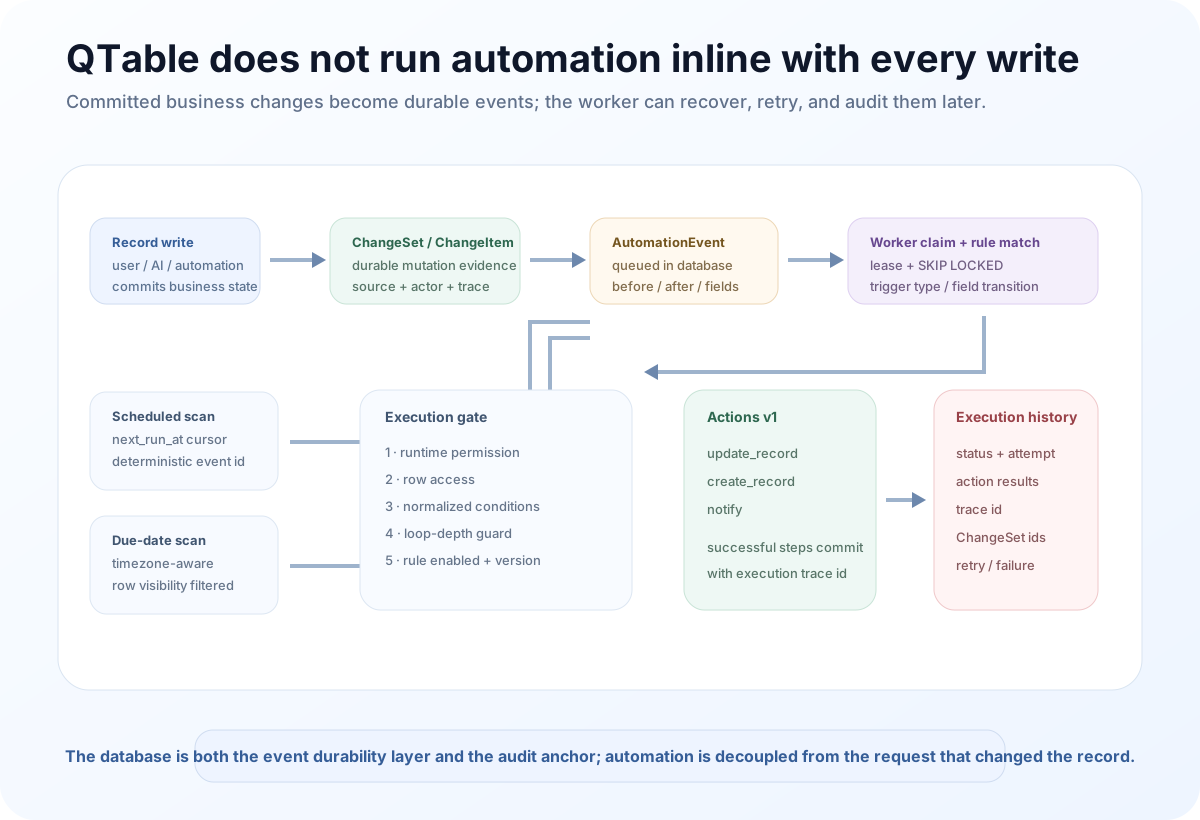
QTable 的 Record Write 本来就会产生 ChangeSet / ChangeItem。
Automation 没有要求每一条写 API 再额外手工调用一次“触发自动化”。
而是由 Worker 从已经提交的 ChangeItem 里 materialize 出 durable AutomationEvent。
也就是说业务写入和 Automation Dispatch 被解耦了。
Record 先成为事实。
ChangeSet 先成为审计事实。
Automation 再基于这个已经提交的事实继续工作。
这种设计有几个直接收益。
第一,业务写入不需要等待 Automation 执行完成。
第二,Worker 崩掉以后事件还在。
第三,同一个 ChangeItem 可以用唯一 Source ID 防止重复 materialize。
第四,Automation 不需要侵入每一种未来新增的 Record Mutation API。
只要最终业务修改进入同一条 ChangeSet 体系,Automation 就能从统一的审计事实里建立事件。
这和第六篇“不同 View 操作同一份事实”其实是同一种架构偏好:
不要让每个入口都维护一套自己的副作用链。
Scheduled 和 Due Date 不是临时 Timer,而是持久化 Cursor
周期任务如果只靠内存里的 sleep,应用重启以后很容易忘记自己该做什么。
QTable 的 Rule 上有 next_run_at。
Scheduler 会扫描已经到期的 Rule。
对于 scheduled,根据 Interval 生成 Synthetic Event。
对于 due_date,会扫描当前用户能看到的 Record,再根据:
- Date Field;
- Rule Timezone;
- Offset Minutes;
- Scan Interval;
计算应该触发的 Record。
这里还专门处理了一个很容易出错的问题:
没有时区的日期值如何解释。
当前逻辑会按 Rule 自己的 Timezone 解释 Local Wall Time,再转换成 UTC。
不是直接把一个 “09:00” 当 UTC。
另外 Due Date Event ID 是根据 Rule、Version、Record、Field、Due Time、Offset 等信息确定性生成的。
同一个提醒窗口被扫描两次,不应该产生两次 Notification。
这不是高级 AI 能力。
但这是企业自动化真正会踩坑的地方。
Idempotency 不是“永远不失败”
Automation 系统迟早会失败。
数据库短暂异常。
Notification 下游失败。
某个 Record 在两次 Action 之间权限变化。
某个 Rule 运行时已经被修改。
真正需要设计的是:
失败以后再来一次,会发生什么?
QTable 的 AutomationExecution 有一个唯一约束:
automation_id + automation_version + trigger_event_id
同一个 Rule Version 对同一个 Trigger Event,只应该有一个 Execution Identity。
如果两个 Worker 发生并发竞争,也会通过唯一约束收敛到同一个 Execution。
但这还不够。
因为一条 Rule 可能有多个 Action。
例如:
- create_record;
- notify。
如果第一步成功,第二步失败,然后整个 Rule 从头重跑,最坏的结果就是创建两条 Record。
所以当前 Executor 会把每一个 Action Result 持久化。
Retry 时已经成功的 Action 会直接跳过。
只重试没有成功的部分。
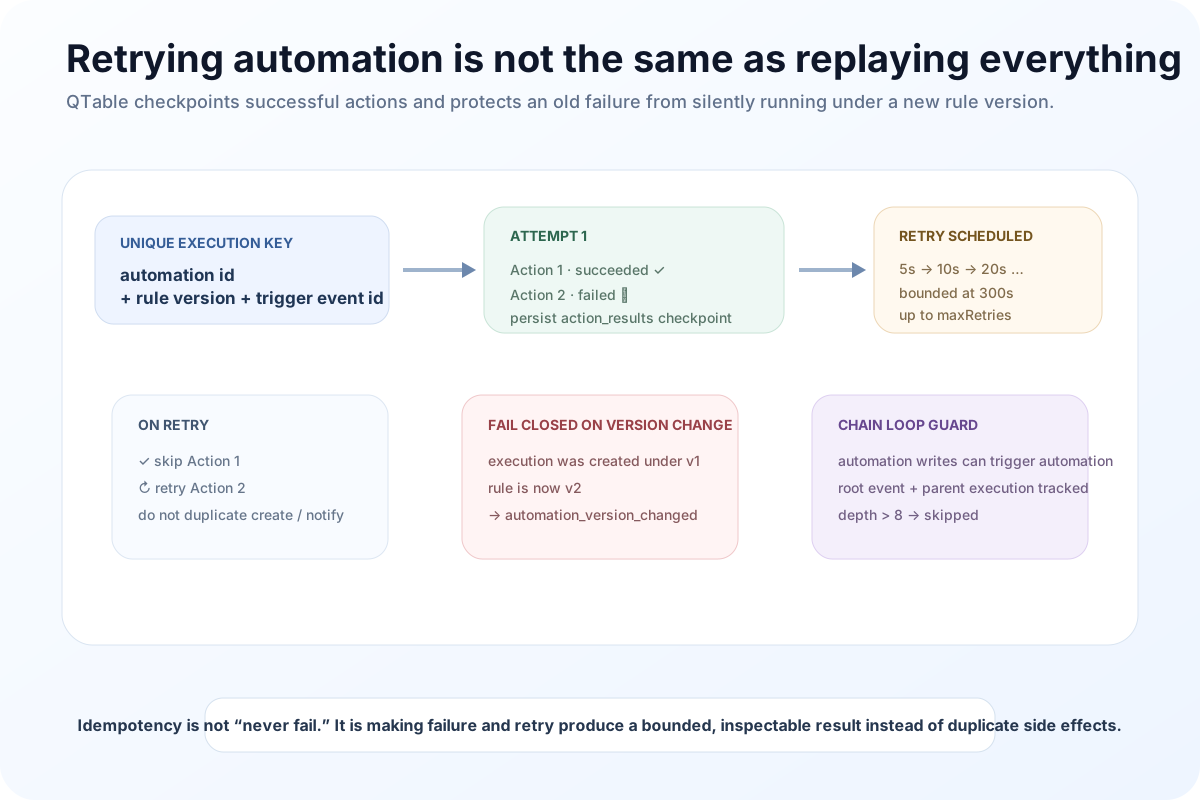
当前 Retry Delay 从 5 秒开始指数退避。
上限 300 秒。
Rule 自己可以配置 maxRetries,当前最大允许 10。
最终可能得到:
- succeeded;
- skipped;
- failed;
- partially_failed。
这里有一个必须明确的语义:
Automation 的多个 Action 当前不是一个跨 Action 的全局原子事务。
前面的 Action 可能已经成功提交。
后面的 Action 才失败。
所以系统不是通过“把一切 rollback”保证可靠。
而是通过:
- Action Checkpoint;
- Retry;
- ChangeSet;
- Partially Failed Status;
把实际已经发生的世界记录下来。
我认为这比假装所有外部副作用都可以事务回滚更现实。
Rule Version 是执行语义的一部分
假设:
Rule v1:
“创建一条 Record,然后通知 A。”
执行第一步以后,第二步失败。
此时用户编辑 Rule,改成 v2:
“不要创建 Record,改成通知 B。”
如果旧的 Retry 直接加载最新版 Rule 继续执行,会发生什么?
你已经无法解释这次 Execution 到底属于哪个规则。
所以 QTable 的 Execution 会保存 automation_version。
Rule 的 Trigger / Condition / Action / Timezone / Retry 等执行语义变化时,Version 会增加。
Retry 前如果发现当前 Rule Version 和原 Execution 不一致,会直接:
automation_version_changed
旧执行 Fail Closed。
要求通过新的 Event 或新的 Manual Run 开始新执行。
这是一件很小但很重要的事:
Retry 应该重试当时那次执行,而不是把旧失败偷偷解释成一条新规则。
Automation 写 Record,也可能触发另一个 Automation
这会马上带来循环问题。
Rule A 更新字段 X。
字段 X 的变化触发 Rule B。
Rule B 又更新字段 Y。
字段 Y 又触发 Rule A。
如果没有 Chain Context,很容易出现无限循环。
QTable 的 Event / Execution 会保存:
root_event_id;parent_execution_id;depth。
Automation 产生的写入使用自己的 trace_id。
后续 ChangeSet 再被 materialize 成 Event 时,系统可以找到 Parent Execution,把 Depth 加一。
当前最大 Automation Chain Depth 是 8。
超过以后 Execution 会被标记为:
skipped / loop_guard
这不是完整的图算法循环检测。
但它先给系统设置了一个硬上限。
对于 v1 来说,这是一个很务实的安全边界。
Worker 不是“拿到 Event 就执行”,而是先 Claim
当前 Worker 是应用内部的异步 Polling Worker。
它不断调用 process_automation_cycle。
每个 Cycle 会做:
- 从 ChangeSet materialize Record Events;
- 扫 Scheduled / Due Rules;
- 处理到期 Retry;
- Claim Event;
- Dispatch Rule。
Event Claim 使用数据库行锁和 skip_locked。
Claim 后会把 Event 设为 processing,同时把 available_at 当成 Lease Deadline。
当前 Event Lease 是 300 秒。
如果 Worker 在 Claim 后崩掉,Lease 过期以后其他 Worker 可以重新拿到。
Retry Claim 也有同样的 Lease 思路。
这说明当前 Automation Queue 并没有引入 Kafka、RabbitMQ 之类的外部 Broker。
Database 就是 Durable Queue。
对于现在的 Alpha 规模,这减少了一层部署复杂度。
但它也意味着当前系统是 Polling 模式,延迟和吞吐会直接受到 Poll Interval、Batch Size、数据库扫描以及 Worker 数量影响。
未来如果 Automation 规模真的变大,这一层可能需要独立 Worker / Queue Architecture。
但现在不能把“未来需要专用消息系统”写成“当前没有可靠事件”。
当前已经有 Durable Event、Lease、Skip Locked 和 Idempotency。
只是实现载体是 Database Queue。
Automation 也不能获得永久权限
第七篇说:
Agent 权限不能高于当前用户。
Automation 其实有同样的问题,而且更危险。
因为 Rule 可以活很久。
今天创建。
三个月以后还在跑。
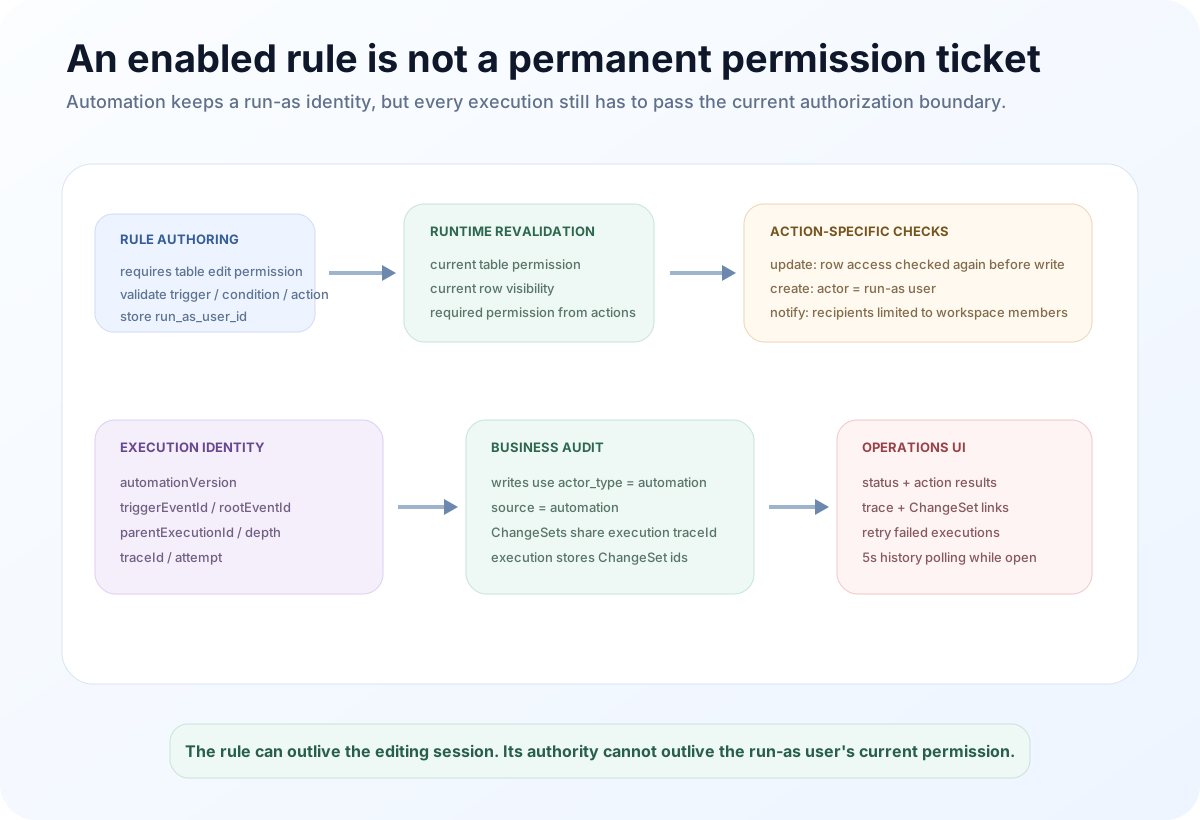
所以 Rule 保存了 run_as_user_id。
创建 Rule 时,它代表创建它的用户。
执行语义被修改时,也会把 Run-As Identity 更新为当前编辑用户。
但这个 Identity 本身不等于权限票。
每一次实际 Execution,系统都会重新检查:
这个 Run-As User 现在对 Table 还有没有需要的权限。
如果 Action 只有 Notification,至少需要 Read。
如果 Action 会 Create / Update Record,需要 Update。
对于具体 Record,还会检查 Row Permission。
而且 update_record 在每一次真正写之前,还会再次检查 Row Access。
原因很现实:
前一个 Action 可能刚刚改了 Member Field。
而这个 Member Field 可能正好决定 Row Visibility。
所以不能因为 Execution 开始时有权限,就假设 Action 3 执行时仍然有权限。
如果 Run-As User 后来被移出 Workspace,Execution 会失败。
现有测试里专门验证了:
权限丢失以后,Automation 不会继续更新 Record。
也就是说:
Enable Rule 不是永久授权。
这是我认为所有长期运行 Automation 都应该有的基本语义。
Audit 不能只记一句“Automation succeeded”
Automation 写 Record 时,当前实现会沿用 QTable 的 ChangeSet 体系。
写入使用:
actor_type = automation;source = automation;- Execution 的
trace_id。
执行结束后,Execution 会把同一个 Trace 下的 ChangeSet IDs 收集回来。
所以在 Execution History 里,不只可以看到:
“成功了。”
还可以看到:
这次执行用了哪个 Rule Version。
Attempt 是第几次。
每一个 Action 成功还是失败。
对应哪个 Record。
Trace ID 是什么。
产生了哪些 ChangeSet。
这种链接非常重要。
因为 Automation 的可观测性不能停留在 Worker Log。
业务用户更关心的是:
这条自动化到底改了什么业务事实?
ChangeSet 就是 Automation Runtime 和 Business Audit 之间的桥。
QTableUI 已经不是一个“以后接入”的 Automation 占位页
当前 QTableUI 里已经有真实 Automation Center。
并且有专门的 UI Contract Check,防止以后回归成 Placeholder。
Editor 当前明确支持 Backend v1 的 Trigger 和 Action Families。
保存前会先调用 validateAutomation。
保存以后还会重新从 Server 读取这条 Rule,确认持久化结果。
对于已经保存的 Rule,UI 可以调用 automationPreview。
这个 Preview 会告诉用户:
- 当前 Condition 是否匹配;
- 是否会 Execute;
- 需要什么 Permission;
- Action Summary。
这里要特别区分两件事。
Preview 是 Preview。
Manual Run 是真实执行。
当前 UI Contract 里还特意要求 Manual Run 明确告诉用户:
“这不是模拟预览。”
因为 runAutomation 会真正执行 Update / Create。
它只绕过 Trigger Matching,不绕过 Validation 和 Runtime Permission。
这和第三篇 Preview → Confirm → Apply 的思路很像:
产品必须明确告诉用户:
现在是在看。
还是在做。
Execution History 是 Automation 的产品界面,不是 Debug Console
当前 Execution History Drawer 会在打开时每 5 秒轮询。
用户能看到:
- Execution Status;
- Attempt;
- Rule Version;
- Error Code / Message;
- 每个 Action Result;
- Record;
- Trace ID;
- ChangeSet IDs。
对于 Failed / Partially Failed Execution,在有 Edit Permission 时还可以 Retry。
这个设计让我觉得 Automation Center 已经不应该只被理解成“规则编辑器”。
它实际上还有一半是 Operations Console。
创建规则只是开始。
长期运行以后真正重要的是:
哪些规则正在失败?
失败多久了?
是不是同一个错误反复出现?
Retry 有没有恢复?
有没有产生重复副作用?
哪些 ChangeSet 是这条规则写出来的?
这部分以后甚至可能比 Editor 本身更重要。
当前实现仍然有很明确的边界
这一篇同样不应该把当前 v1 写成一个无限扩展的工作流平台。
现在至少有几个清晰边界。
1. Action Family 还很窄
只有:
- update_record;
- create_record;
- notify。
还没有 Generic Webhook、HTTP Request、Connector Action、Skill Action。
这件事我认为应该慢慢扩展,而不是直接开放任意脚本。
每增加一种 Action,都应该同时回答:
权限怎么定义?
Secret 怎么保存?
Retry 是否安全?
幂等性怎么做?
Audit 怎么记录?
External Side Effect 能不能重复?
2. Trigger Family 还没有 Record Delete / Webhook / External Event
当前只有 Create、Update、Schedule、Due Date、Manual。
这意味着 Automation 还主要围绕 QTable 内部数据变化和时间驱动。
这和 Roadmap 里的 Table-as-API / Webhook / Connector Platform 是明显衔接点。
3. Action Sequence 是线性的,不是 DAG Runtime
当前 Rule 有一个 Action List。
它会按顺序执行。
没有分支。
没有 Parallel Node。
没有显式 Compensation Graph。
这和第五篇 Multi Tool Chain Runtime 解决的问题并不一样。
如果未来 Automation 也演化成复杂 DAG,需要很谨慎地判断:
应该复用 Tool Chain Runtime 的哪些能力。
哪些又必须保持 Rule Engine 的确定性语义。
4. 目前主要是 Database-backed Runtime
GraphQL 层明确要求:
Automations require database backend.
Legacy File Backend 不会假装提供同样的 durable queue、locking、retry 和 execution semantics。
我认为这是正确的。
可靠自动化最危险的事情之一,就是在一个不具备持久化语义的 Backend 上假装“功能也能跑”。
5. Worker 仍然是应用内 Polling Worker
现在已经有:
- Durable Event;
- Lease;
- Skip Locked;
- Batch;
- Retry。
但 Worker Lifecycle 仍然跟 QTable Application Runtime 很近。
未来更高吞吐、更强隔离、独立伸缩、队列监控、Dead Letter 等能力,可能需要把它进一步拆成独立 Worker Plane。
这属于规模化问题。
不是当前 v1 已经完成的能力。
Agent 和 Automation 最终应该怎么合作
我认为真正有意思的不是:
Agent 替代 Automation。
而是:
Agent 帮用户生成、解释、诊断 Automation;Automation 负责长期确定性执行。
例如用户说:
“高优先级任务进入 Review 后提醒负责人,如果三天没完成再提醒一次。”
Agent 可以负责:
理解用户意图。
发现 Table 里哪个字段叫 Priority。
哪个字段叫 Status。
哪个字段是 Assignee。
哪个字段是 Due Date。
生成一条 Automation Draft。
解释它会在什么情况下触发。
但一旦用户确认规则:
后面每一次运行不应该再问模型。
它应该进入:
Trigger → Condition → Action。
这会带来一个很重要的产品分层:
AI 是 Rule Authoring Interface。
Automation Engine 是 Rule Execution Runtime。
同一个 AI Native 产品,两者都需要。
Automation 真正要消灭的是“每次重新解释”
传统 Automation 产品经常给人一种机械感。
AI 产品又很容易走到另一个极端:
什么都重新理解一遍。
我更希望 QTable 中间这条路是:
第一次,用 AI 帮你把意图变成结构化规则。
以后,用 Deterministic Runtime 执行。
业务变化以后,再让 AI 帮你修改规则。
而不是每一次 Record 更新,都重新调用模型问:
“这一次是不是应该通知?”
这样做不仅更便宜。
更重要的是:
它更可解释。
更容易测试。
更容易重试。
更容易审计。
也更容易知道系统到底为什么做了这件事。
所以第九篇最想留下的结论是:
AI Native 不意味着把确定性工作交给模型。真正成熟的 AI Native 系统,应该知道什么时候停止推理,开始执行规则。
QTable 当前 Automation Engine 已经有 Rule / Event / Execution 三层模型、ChangeSet Event Materialization、Scheduled / Due Trigger、条件归一化、Run-As Permission、Action Checkpoint、Retry、Rule Version、Loop Guard、Trace、ChangeSet Audit 和真实 Execution History。
同时,它仍然是一个 v1:
Action / Trigger Family 有限。
Worker 还是 Database-backed Polling。
Action Sequence 还是线性的。
Connector / Webhook / External Side Effect Contract 仍然需要继续设计。
这些边界很清楚,反而更方便后面继续扩展。
第十篇也是这个系列的最后一篇,我想把视角从“功能如何正确执行”移到“系统如何长期活着”:
一个能跑起来的 QTable,怎么变成一个能长期升级、备份、恢复、观测和运营的 Self-hosted 系统。
因为真正进入生产以后,最后一个工程问题通常不是:
“功能有没有。”
而是:
出问题以后,能不能知道发生了什么;升级以后,能不能回来。
QTable 已经开源
如果你对本文讨论的数据模型、AI 工作流或开源工程实践感兴趣,可以直接阅读代码、提交 Issue 或参与贡献。