
Context 不是把更多資料塞進 Prompt:QTable 的 Context Engine 如何建立真實業務上下文
Agent 真正進入業務系統後,最先要解決的不是模型能記住多少,而是它如何知道目前使用者是誰、正在操作哪個 Workspace、哪張表、哪個 View、哪段對話,以及這些資訊在哪一條權限邊界內成立。本文結合 QTable 目前的 Context Engine 實作,拆解業務上下文如何被建立、壓縮、快取、持久化並注入 Agent Runtime。
上一篇談 Preview → Confirm → Apply 時,我最後留下了一個問題:
Preview 裡的那份計畫,到底是建立在什麼 Context 上產生的?
這個問題聽起來沒有「AI 自動執行工作」那麼吸引人,但它其實更基礎。
使用者在 QTable 裡說:
「幫我看看這個專案為什麼延期。」
對人來說,「這個專案」通常不難理解。我們知道自己剛剛打開了哪個 Workspace,正在看哪張表,目前是哪個 View,前面討論過什麼,也知道自己是誰。
模型不知道。
如果系統只把這句話送給模型,它面對的還不是一個專案管理問題,而是一堆隱含指涉:
「這個專案」是哪一個?
應該看哪張表?
目前使用者能看哪些資料?
剛才提過的「後端任務」還算不算上下文?
使用者正在看 Kanban、Gantt,還是另一個 View?
這次請求屬於哪一個 Session、Workflow 或 Agent?
所以我越來越不喜歡「給模型更多上下文」這種說法。
真正的問題不是多,而是上下文有沒有身份、範圍、邊界和座標。
QTable 的 Context Engine 想做的,就是在 Agent 開始推理之前,先把「誰、在哪裡、面對什麼業務物件、沿著哪段對話、處在哪條執行鏈路」整理成結構化物件。
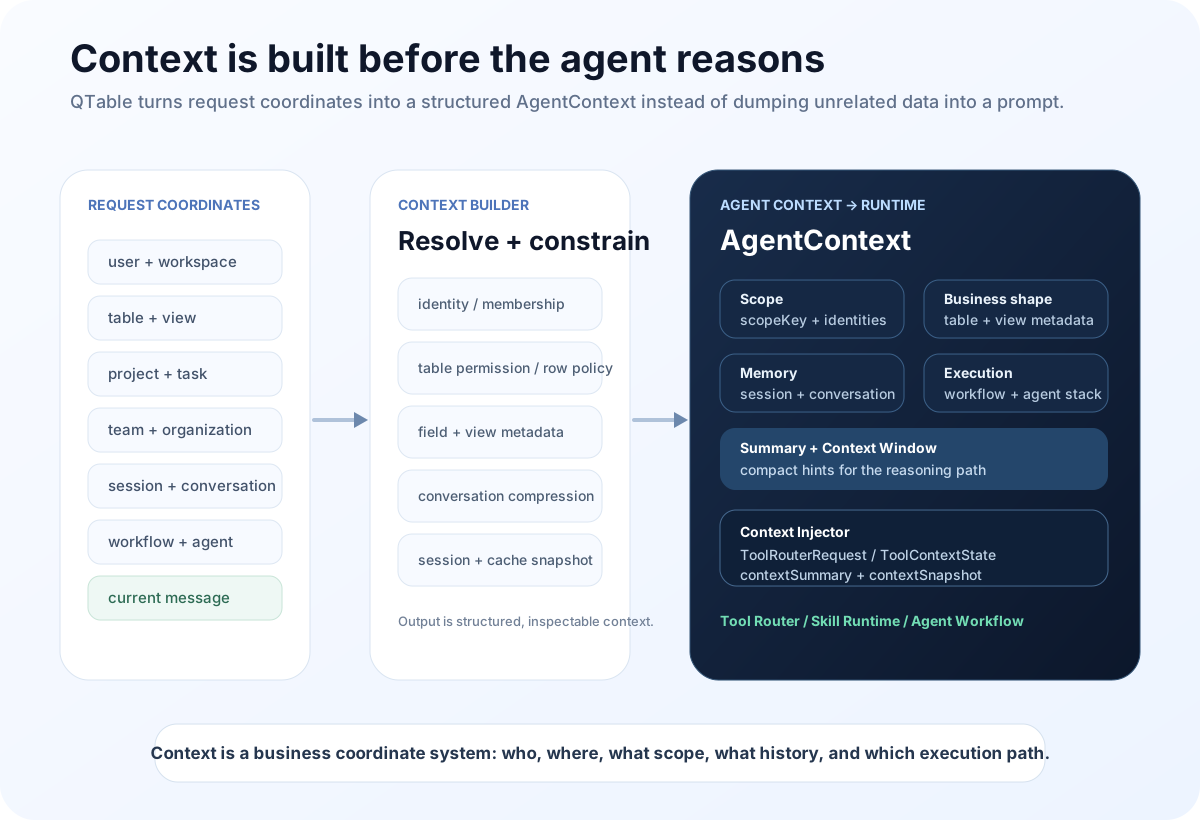
「Context」首先是一組座標,而不是一段 Prompt
QTable 目前的核心上下文模型定義在 app/context_engine/models.py。
入口物件叫 ContextBuildInput。
它接收的不是一大段已經拼好的文字,而是一組明確座標:
- user;
- session / conversation;
- workspace;
- project;
- table;
- view;
- task;
- team;
- organization;
- workflow;
- agent;
- 目前 message;
- locale、timezone 和額外 metadata。
這些 ID 看起來很普通,但它們解決了一個很重要的產品問題:系統不需要讓模型自己猜「現在在哪」。
在 QTable 目前的 AI Chat 和 Agent 路徑裡,app/api/ai.py 會從請求和 Header 中抽出這些座標,建立 ContextBuildInput,再交給 Context Engine。
PM Agent 也沿著同一個方向。app/api/pm_agent.py 會把 workspace、project、table、view、task、team、organization 等座標帶進 Builder,再把產生的 AgentContext 交給後續 Workflow。
這表示 Context 不再只是某個 Prompt Template 裡的私有變數。
它開始變成不同 AI 入口共用的一層產品基礎設施。
先決定「這是誰的上下文」,再決定裡面放什麼
上下文最危險的一種錯誤,不是缺少資訊,而是把不屬於目前請求的資訊混進來。
例如:
- Workspace A 的表結構被帶進 Workspace B;
- 上一次 Conversation 的任務繼續影響新的 Session;
- 管理員看過的欄位進入一般成員的上下文;
- 同一個瀏覽器 Session 裡,不同使用者共用了快取。
所以 Context Builder 的第一步不是「查更多資料」,而是建立 scopeKey。
目前實作位於 app/context_engine/repository.py。Scope 由 user、workspace 和 session 組合而成。沒有明確 Session 時,會退回 conversation;再沒有時才使用 anonymous。
也就是說,Context 從一開始就不是全域快取物件。
它屬於某個使用者、某個 Workspace、某段 Session。
在這個基礎上,Cache Key 還會繼續加入 tableIds、viewId、projectId、taskId、teamId、organizationId、workflowId、agentId,以及目前 message 的一部分,最後產生穩定 Hash。
這套 Key 設計的價值不只在「快取命中率」。
它也防止兩個看起來很像的請求,被錯誤地當成同一份上下文。
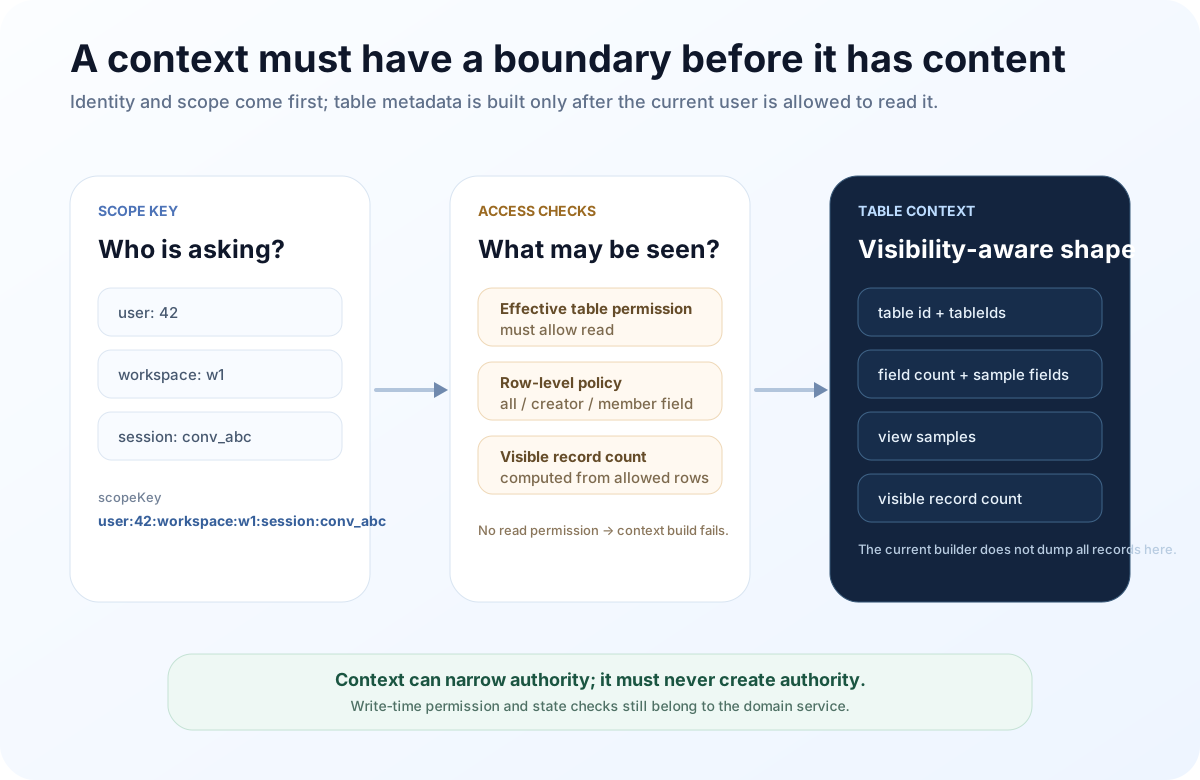
Table Context 不是「把整張表交給模型」
這是很容易踩到的一個設計陷阱。
很多人一說「讓 AI 理解目前表」,第一個實作想法就是把所有欄位、所有 Record 序列化,再塞進模型。
QTable 目前的 Context Builder 沒有這麼做。
在資料庫後端下,_build_table_context 會先解析目前使用者對 Table 的有效權限。沒有 read 權限,Context Build 直接失敗。
如果 Table 啟用了 Row-level Permission,Builder 會依照 Row Permission Policy 算出目前使用者可見的 Record ID,進一步得到權限感知的 record count。沒有額外限制時,才統計整張表的 Record 數量。
目前產生的 Table Context 主要包含:
- 目前主 Table ID;
- 請求中的全部 tableIds;
- field count;
- 最多 12 個欄位的 id / name / type 樣本;
- 最多 6 個 View 樣本;
- 目前使用者可見範圍內的 record count。
這裡有一條很重要的邊界:目前 Context Engine 不會在這一步把所有 Record 內容塞進 AgentContext。
我認為這個方向是對的。
Context Engine 更像是在告訴 Runtime:你現在在哪裡,這個業務介面大概長什麼樣。
真正要讀取任務、訂單或客戶資料時,應該由具體 Tool 在清楚的權限規則下查詢。
這比把整張表一次性變成 Prompt 更穩。
Context 不會隨著 Record 數量成長而無限膨脹。
資料存取時仍可以走原本的 Record / Relation / Row Permission 規則,而不是相信一份事先拼好的副本。
而且 Context 不會變成第二份事實。真正的業務資料仍然留在 Table / Record 模型裡。
當然,目前實作也有一個很清楚的限制:請求可以攜帶多個 tableIds,但詳細欄位、View 和 record count 目前主要圍繞第一張 Table 建立,其他 Table ID 只保留在 metadata 中。
所以今天還不能把它寫成「已經完整理解多表關係」。
AgentContext 是可檢查的 Snapshot,不是藏在 System Prompt 裡的字串
Context Builder 聚合完成後,會產生 AgentContext。
目前這個物件包含:
- User;
- Project;
- Workspace;
- Table;
- Task;
- Team;
- Organization;
- View;
- Session;
- Conversation;
- Workflow;
- Agent Stack;
- Context Summary;
- Context Window;
- generatedAt。
這種結構有一個很直接的工程價值:上下文可以被檢查。
如果 Agent 做出奇怪判斷,系統至少可以追問:
它當時認為 Workspace 是什麼?
拿到的 Table ID 是什麼?
View 是什麼?
Conversation Summary 是什麼?
這個 Snapshot 來自哪個 Session?
Context Window 當時用了多少預算?
這比「我們應該有在某個 Prompt 裡拼過那些資訊」可靠得多。
不過這裡也要把現況說清楚。
Workspace、Table、View、Conversation 已經有比較具體的 Builder 邏輯;Project、Task、Team、Organization 目前在 Context Builder 裡仍然比較淺,主要是 ID 加上呼叫方傳入的 metadata,還沒有全部透過各自領域服務解析成完整業務實體。
所以今天的 AgentContext 更像是一套已經穩定下來的上下文契約骨架,不同區塊目前的豐富程度並不相同。
這其實也是結構化模型的好處。
缺什麼是顯式的,後續可以一層一層補,而不是一直往巨大 Prompt 裡追加字串。
對話記憶不能靠「把歷史全部帶上」
長對話是 Context Engine 另一個很實際的問題。
一個專案討論十幾輪之後,如果每次都把每條歷史訊息原樣交給模型,成本會越來越高,而且更早的資訊並不一定還值得佔據相同權重。
QTable 目前的策略很樸素。
Conversation Builder 使用 tail-window + heuristic-summary:
- 最近最多 20 條訊息保留為 recent turns;
- 更早的訊息進入壓縮區;
- 目前實作會用壓縮區靠後的幾條訊息形成啟發式摘要;
- 摘要和 recent turns 一起進入
ConversationContext; - 同時記錄 original chars、compressed chars、保留數量與壓縮數量。
這不是一套複雜的「AI 長期記憶」。
它反而很簡單、可讀、可預測。
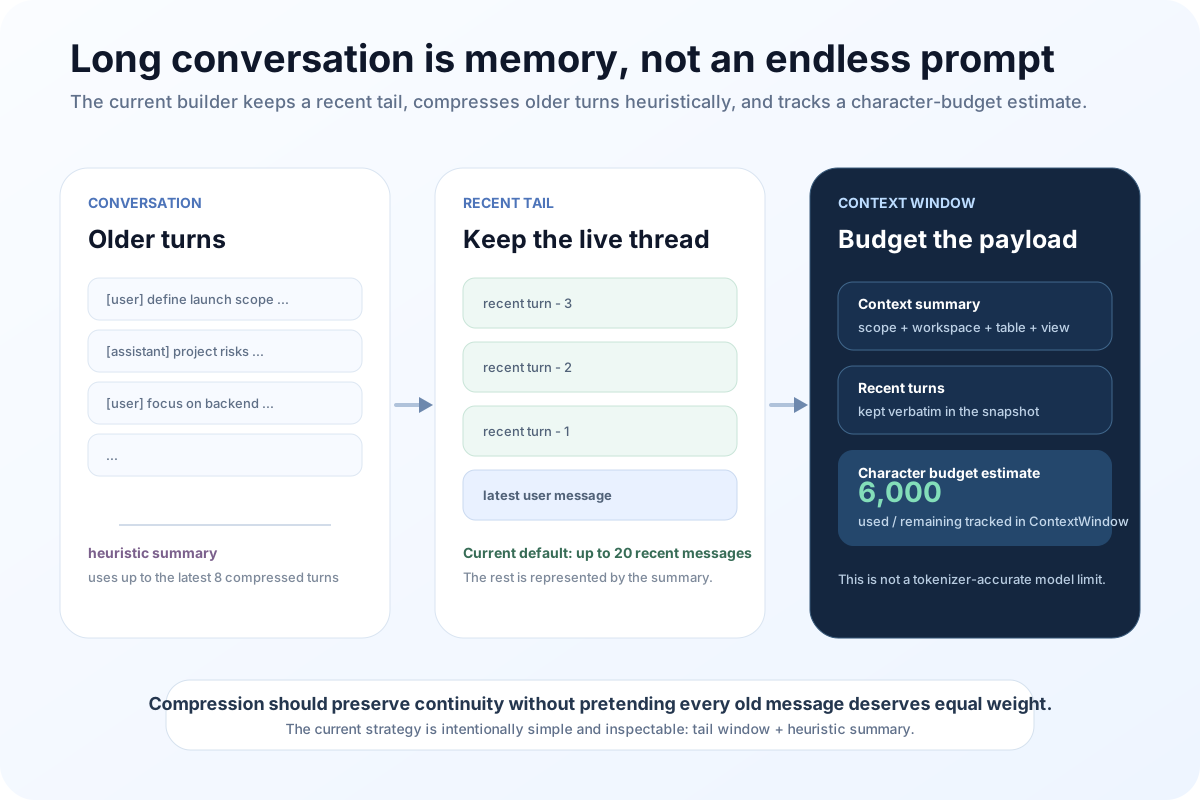
目前設定裡的 CONTEXT_MAX_CONVERSATION_MESSAGES 是 20,CONTEXT_COMPRESSION_CHAR_BUDGET 是 6000。
這裡我刻意使用「字元預算」,而不是「Token Window」。
因為現在的 ContextWindow 計算的是 summary text 加 recent turns 的字元數量。它適合當一個穩定的內部預算指標,但不等於不同模型真正的 tokenizer 消耗。
如果未來 QTable 同時支援更多 Context Window 差異很大的模型,這一層應該繼續演進成 provider / model aware 的 token budgeting,而不是假裝 6000 個字元對所有模型都代表同一種成本。
Session、Cache 和 Snapshot 解決的是三個不同問題
如果每一輪都重新查完整上下文,延遲會增加。
如果只做快取,又會失去事後可追蹤性。
所以目前 Context Repository 同時有三層狀態。
Redis Context Cache 負責熱路徑。
目前 Snapshot Cache 預設 TTL 是 300 秒。相同 Scope 與請求座標可以直接重用聚合後的 AgentContext。
Context Session 負責一段互動的連續性。
目前 Session 預設 TTL 是 86400 秒,也就是一天。Session 會保存 workspace、conversation、project、table、view、task、team、organization、workflow、agent,以及 memory summary 和最近一次 context hash。
Context Snapshot 負責留下真正 Build 過的上下文證據。
當系統需要重新建構 Context、而不是直接命中 Hot Cache 時,可以把 summary、完整 snapshot、compression metadata、source 和可選 trace id 寫入資料庫。
這三層的責任不一樣。
Cache 是為了快。
Session 是為了連續。
Snapshot 是為了回答:「當時 Agent 看見了什麼?」
這也是為什麼我不把 Context Engine 看成 Prompt Assembly。
Prompt 通常在推理結束後就消失了,而 Context Snapshot 可以成為整個業務系統追蹤鏈的一部分。
Context Injector 的工作,是把業務座標帶進執行鏈路
Context 建好了還不夠。
如果它只停留在一個獨立 Service 裡,Tool Router 和 Skill Runtime 還是會各自重新猜「目前上下文」。
QTable 的 app/context_engine/injector.py 就是這座橋。
Injector 會把結構化 Context 寫回 ToolRouterRequest 與 ToolContextState,包括:
- sessionId;
- workspaceId;
- tableIds;
- conversationId;
- projectId;
- viewId;
- taskId;
- teamId;
- organizationId;
- workflow;
- agentStack;
- contextSummary;
- contextSnapshot。
它還會把 scope、summary highlights 和 context window 放進 variables,並把精簡摘要加進 runtime notes。
這樣後面的 Router、Tool Adapter、Skill Runtime 就不需要每一層都重新定義「目前 Workspace 是什麼」。
這比每個 Tool 自己讀 Header,更接近一個真正統一的 Runtime。
Context Snapshot 絕對不能變成寫入權限
這裡必須把第四篇和第三篇連起來。
Context Engine 會快取。
目前 Hot Snapshot 預設可以存 300 秒。
這五分鐘裡,真實世界可能已經改變:
- 使用者權限變了;
- Table Schema 變了;
- Row Permission 變了;
- Record 被別人修改;
- Workspace Member 關係改變。
所以一份 Context Snapshot 可以回答:
「這個 Agent 在做判斷時,被告知自己處在哪個環境裡?」
它不能回答:
「現在這一刻,這個寫入一定被允許。」
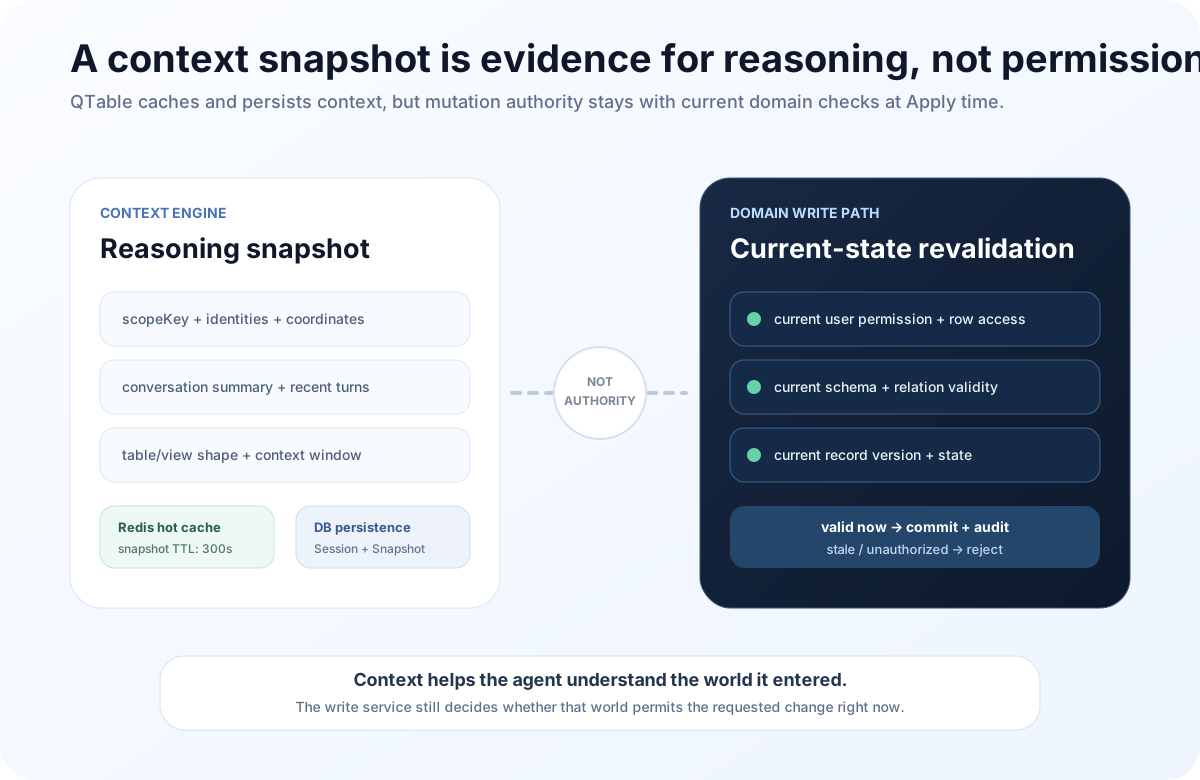
這就是上一篇 Preview → Confirm → Apply 裡,Apply 一定要重新檢查 Permission、Schema、Relation 和 Record version 的原因。
如果寫入層直接相信快取的 Context Snapshot,那 300 秒的 Cache 就可能變成 300 秒的過期權限視窗。
所以我更傾向把兩層責任分清楚:
Context Engine 回答:「我在哪裡,我正在理解哪個業務世界?」
Domain Service 回答:「現在這一刻,這個改動到底允不允許?」
這條邊界很重要。
因為 Agent 系統最容易犯的架構錯誤之一,就是把「模型知道什麼」和「模型被允許做什麼」混成同一個概念。
目前 Context Engine 還沒有解決完哪些問題
我不想把這一篇寫成「QTable 已經有一套完整的企業級 Context Platform」。
還沒有。
目前實作已經把骨架搭起來,但下一步也很清楚。
第一,Project / Task / Team / Organization Context 還比較淺。
現在主要依賴 ID 和呼叫方提供的 metadata。後續應該由各自 Domain Service 真正解析業務實體,而且同樣經過權限過濾。
第二,Multi-Table Context 還需要更豐富。
目前詳細 Table Context 主要聚焦第一張表。真正跨表 Agent 需要理解 Relation Graph,而不是只有一串 tableIds。
第三,Conversation Compression 仍然是啟發式。
它簡單可預測,但不一定知道五十輪以前某條限制仍然很重要。長期記憶需要更好的語義能力,同時又不能讓模型產生的摘要悄悄取代原始事實。
第四,Cache Invalidation 目前主要依賴 Key 和 TTL。
當 Schema、Permission 或業務狀態變得更動態時,未來應該考慮版本或事件驅動的主動失效,而不是只等五分鐘過去。
第五,Context Window 現在仍然是字元估算。
要真正優化不同 Provider 的成本,後續還需要 tokenizer-aware budgeting、Tool Call Budget,甚至不同執行階段使用不同 Context 配額。
這些不是要否定現在的實作。
相反地,它們是 Context 在架構裡有了明確位置之後,才真正看得見的工程問題。
好的 Context Engine,使用者不應該感覺到它存在
使用者不會在意 ContextBuildInput、scopeKey 或 ContextSnapshot。
他們只會感覺到失敗:
「我明明就在看這個專案,為什麼 AI 還要問是哪一個?」
「我已經說三次後端優先,為什麼它突然忘了?」
或者更糟:
「為什麼 AI 看到了我本來不應該看到的資料?」
所以一個好的 Context Engine,理想狀態其實是沒有存在感。
使用者繼續在 Workspace、Table、View、Conversation 裡工作。
Context Engine 默默把這些 Product State 轉成 Agent 可以理解的業務座標,同時保留 Scope 與 Traceability。
Agent 不需要假裝自己「記得一切」。
它只需要在每一次推理開始之前,拿到這一次真正相關、屬於目前使用者、而且可以被解釋的 Context。
這也是我現在對 Context 最核心的理解:
Context 不是給模型更多資訊,而是告訴模型:你替誰工作、你在哪裡、你正在處理什麼,以及你理解這個世界的邊界在哪裡。
有了這層座標,下一步才輪到 Runtime 真正執行工作。
下一篇我會繼續寫 QTable 的 Multi Tool Chain Runtime:當一個請求需要多個 Tool 組成 DAG,出現並行、依賴、重試、失敗和回滾時,Agent Runtime 要怎麼避免退化成一串不可控的 Function Call。
QTable 已經開源
如果你對本文討論的資料模型、AI 工作流程或開源工程實踐有興趣,可以直接閱讀程式碼、提交 Issue 或參與貢獻。