
Self-hosted 不是 docker compose up:QTable 如何把升级、备份、恢复和可观测性变成系统边界
Self-hosted 真正困难的不是把容器启动起来,而是升级时知道自己在改变什么、故障时知道丢了什么、备份后确认能否恢复、运行中知道系统是否真的健康。本文结合 QTable 当前 PostgreSQL / Redis / MinIO / QTable / QTableUI Compose、Alembic、Health Check、Release Gate、ChangeSet 与 Runtime Trace,梳理一个 AI Native 工作系统走向长期运营所需要的边界。
这是《构建 QTable:一个 AI Native 工作系统的设计与实现》的最后一篇。
前九篇一直在讨论:
怎么建数据模型。
怎么让 AI 安全写业务数据。
怎么建立 Context。
怎么执行 Tool Chain。
怎么让不同 View 操作同一份事实。
怎么限制 Agent 权限。
怎么建立开源供应链信任。
怎么把确定性的工作留给 Automation Engine。
但系统真正进入长期运行之后,问题会突然从“功能怎么做”变成另一类问题:
升级之后起不来怎么办?
数据库坏了怎么办?
附件还在,但数据库里的引用没了怎么办?
数据库恢复了,但 Encryption Key 丢了怎么办?
容器显示 healthy,但用户实际上已经无法正常工作怎么办?
一条 Automation 把错误状态写进了几百条 Record,应该从哪里查?
这些都不是 UI Feature。
却决定一个 Self-hosted 产品到底是不是一个可以长期托付业务数据的系统。
所以最后一篇我想讨论的是:
Self-hosted 的完成标准,不是 docker compose up 成功,而是系统拥有明确的升级边界、恢复边界和观测边界。
Self-hosted 的真实对象不是一个 Container
QTable 当前 canonical Compose 不是只有两个应用镜像。
它至少包含:
- PostgreSQL;
- Redis;
- MinIO;
- QTable;
- QTableUI。
QTableUI 作为 Web Edge。
它通过 Nginx 把 REST、GraphQL、WebSocket、Auth、OAuth 转发给 QTable Backend。
Backend 再依赖 PostgreSQL、Redis 和 S3-compatible Object Storage。
这意味着当运维人员说:
“我要备份 QTable。”
真正要问的是:
你说的是哪个状态?
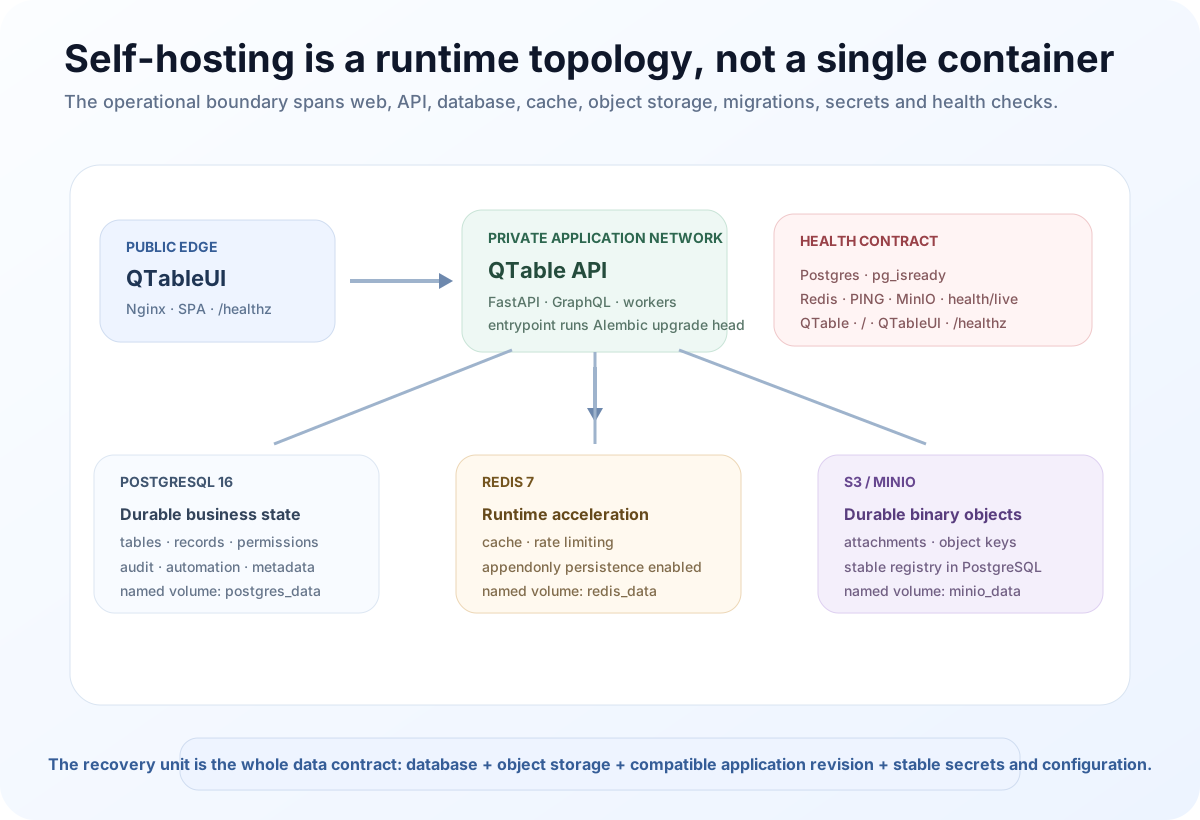
PostgreSQL 里是:
- Workspace;
- Table / Field / Record;
- Permission;
- ChangeSet;
- Automation Rule / Event / Execution;
- Attachment Registry;
- 以及大量业务 Metadata。
MinIO / S3 里是真实附件 Object。
Redis 当前参与 Cache、Rate Limit 等 Runtime 能力,canonical Compose 也启用了 AOF 并使用独立 Volume。
Application Image 又决定:
当前代码理解什么 Schema。
当前 Alembic Head 是什么。
当前 GraphQL / Runtime Contract 是什么。
Secret 和环境变量决定:
Token 怎么验证。
敏感数据怎么解密。
Object Storage 去哪里找。
因此:
“容器镜像”不是系统状态的全部。
Self-hosted 真正需要维护的是:
Code + Schema + Business Data + Binary Objects + Secrets + Deployment Configuration 的一致性。
Named Volume 不是 Backup
当前 Compose 为:
postgres_data;redis_data;minio_data;
定义了 Named Volume。
这解决的是:
Container 被重新创建之后,数据不应该跟着 Container Filesystem 一起消失。
但 Volume Persistence 和 Backup 是两回事。
如果 Disk 整体损坏。
如果误执行 docker compose down -v。
如果宿主机丢失。
如果应用逻辑写错数据。
如果管理员误删了 Record。
Named Volume 并不能回答:
“我能回到昨天 03:00 的状态吗?”
所以我现在会把几个概念严格分开:
Persistence
服务 Restart / Recreate 后,状态仍在。
Backup
系统在另一个 Failure Domain 中保存了可恢复的副本。
Restore
可以从 Backup 重新构建出可工作的状态。
Restore Drill
不是等事故发生才第一次执行 Restore,而是定期证明它真的能成功。
Self-hosted 产品只做到第一层,不能叫 Disaster Recovery。
QTable 当前最核心的 Durable State 是 PostgreSQL + Object Storage
当前 Release Guidance 已经明确建议:
升级真实部署之前,先备份:
- PostgreSQL;
- Object Storage。
这是合理的。
因为 QTable 的附件模型本来就是双层的。
数据库里保存 Stable Attachment Reference。
真正的 Binary Object 在 S3-compatible Storage。
例如一个 Attachment Registry Row 可能知道:
- attachment id;
- object key;
- table id;
- record id;
- field id;
- filename;
- size;
- content type;
- status。
但是 Binary Body 并不在 PostgreSQL 里。
所以只备份数据库会得到一种非常危险的“半恢复”:
UI 里还能看到附件 Metadata。
点开以后 Object 已经不存在。
反过来,只备份 MinIO 也不够。
你会得到一堆 Object Key。
但不知道它们属于哪个 Workspace、Table、Record、Field。
这就是为什么:
Database Backup 和 Object Backup 必须属于同一个 Recovery Set。
Secret 也属于恢复边界
还有一类东西经常不在数据库备份里。
Secret。
当前 Production Compose 明确要求:
POSTGRES_PASSWORD;SECRET_KEY;ENCRYPTION_KEY;ATTACHMENT_S3_ACCESS_KEY;ATTACHMENT_S3_SECRET_KEY。
缺失时会 Fail Closed。
这不是启动麻烦。
这是正确的安全行为。
尤其是 ENCRYPTION_KEY。
如果业务数据中存在使用这个 Key 加密的内容,数据库文件还在,但 Key 永久丢失,那么从恢复角度看:
数据实际上已经不可恢复。
所以 Disaster Recovery Plan 必须同时回答:
Secret 存在哪里?
谁能恢复?
有没有版本历史?
Secret Backup 是否和 Data Backup 分开保存?
Rotation 以后老数据如何解密?
Production Secret 不应该直接打包进普通 Backup Archive。
但它必须有自己的 Recovery Path。
“安全地不能恢复”不等于“可运营”。
升级不是 pull 新镜像然后 restart
当前 QTable Container 的 docker-entrypoint.sh 很简单:
如果 QTABLE_RUN_MIGRATIONS=true:
执行:
alembic upgrade head
然后启动 Uvicorn。
这对部署体验很好。
但从运维角度看,它同时说明:
Application Upgrade 可能包含 Schema Upgrade。
一旦 Schema 发生变化,“换回旧镜像”就不一定等于 Rollback。
因为旧代码未必理解新 Schema。
新 Migration 也未必提供完全可逆的 Downgrade。
甚至 Data Migration 可能已经改变业务数据的表示方式。
所以升级流程不能写成:
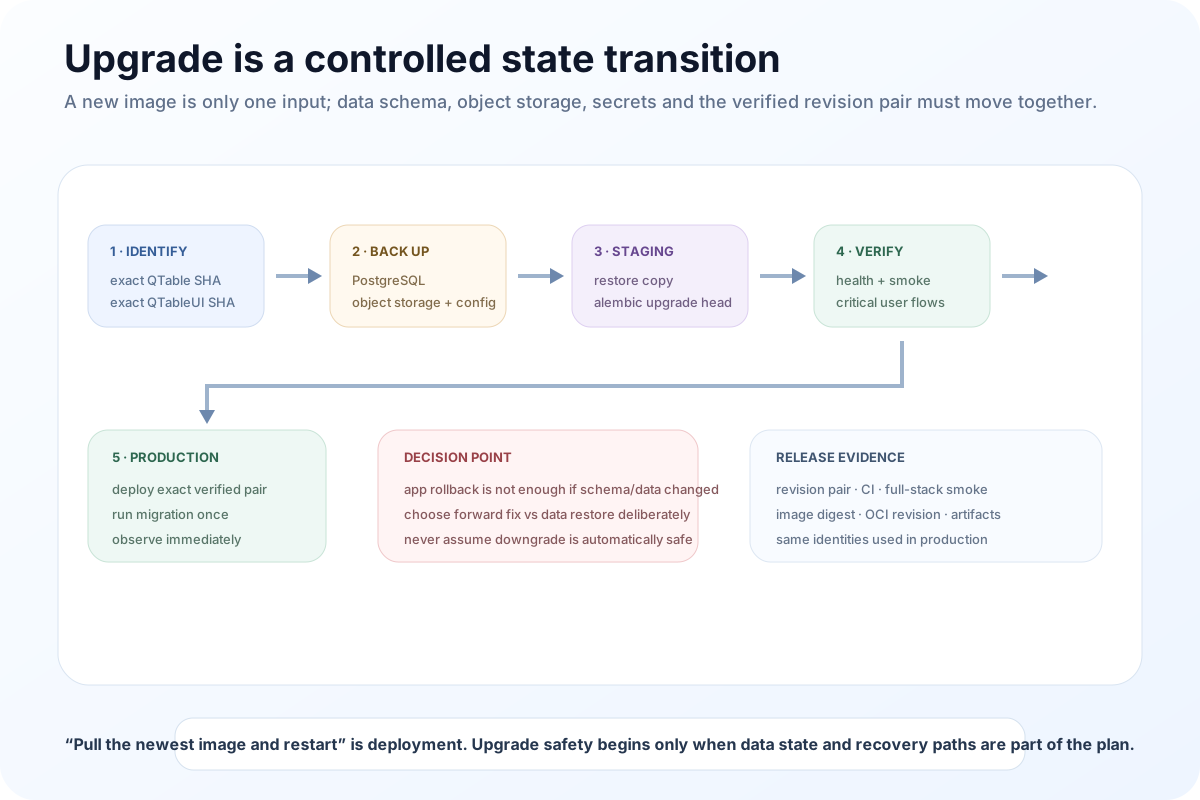
Pull → Restart → 出问题就切回旧 Tag。
更安全的模型应该是:
先明确 Revision。
先 Backup。
先在 Staging Restore 一份真实数据副本。
在那里执行 Migration。
在那里跑 Smoke / Critical Flow。
确认以后再 Production Rollout。
这也是为什么第八篇讨论的 Release Provenance 在这里又出现了。
如果 Production 出问题,最重要的信息之一是:
现在跑的 Backend 到底是哪一个 Revision?
Frontend 是哪一个 Revision?
Image Digest 是什么?
这个组合有没有跑过 Full-stack Gate?
如果只知道:
“我们部署的是 alpha。”
信息远远不够。
Moving Tag 不是 Recovery Identity。
Exact Revision / Digest 才是。
Migration 最危险的不是执行失败,而是“成功到一半你才发现语义不兼容”
QTable 当前已经有正式 Alembic History。
并且对 Empty Database 做 Baseline Bootstrap。
之后继续存在:
- OAuth Session Migration;
- Task Profile;
- Board Order;
- Collaboration;
- Automation;
- Attachment;
- Activation State;
等 Revision。
这意味着 Schema 正在成为一个长期演进的 Contract。
当前 Release Guidance 也已经明确:
先在 Staging:
alembic upgrade head
再执行 Application Smoke Test。
我认为后面还应该继续强化几个原则。
Migration 必须和 Application Revision 绑定
不要手工拿某个不确定版本的 Migration Script 对 Production DB 执行。
Migration 应该来自准备部署的那个 Backend Revision。
Migration 前要知道当前 Revision
不是只看“命令执行成功”。
还应该记录:
From Revision。
To Revision。
执行时间。
Application Revision。
不要假设 downgrade 自动安全
Alembic 有 downgrade 机制。
不代表每一个 Business Migration 都应该依赖自动 downgrade。
某些数据变化更适合:
Forward Fix。
或者:
Restore Pre-upgrade Backup。
所以“可升级”不等于“每一个 Migration 都可以无损逆转”。
Full-stack Release Gate 的意义不是替代 Production Monitoring
QTableUI 当前有 Full-stack Release Smoke。
它会:
Checkout 精确 QTableUI Revision。
Checkout 用户明确传入的精确 QTable Backend Revision。
启动 canonical Compose Stack。
检查:
- QTableUI;
- QTable;
- MinIO;
- Redis;
的 Health。
还会保存 Revision Pair Evidence。
另外更完整的 Release E2E 会真正覆盖:
- Register / Login;
- Record Persistence;
- Filter / Sort;
- Permission;
- Realtime;
- Collaboration;
- Notification Redaction;
- Access Loss;
- Automation;
- Dashboard;
- Offline Fail Closed;
- Recycle Lifecycle。
并且保存 Screenshot、Console Log 和 DevTools Trace。
这很有价值。
但它回答的问题是:
这个精确 Revision Pair 在 Release Gate 环境里是否通过了我们定义的关键流程?
它不回答:
你自己的 Production 今天 14:37 是否健康?
Release Verification 和 Runtime Observability 是两回事。
一个发生在“发布之前”。
一个发生在“运行期间”。
都需要。
Health Check 只是第一层
当前 canonical Compose 已经有 Health Check。
PostgreSQL:
pg_isready
Redis:
redis-cli ping
MinIO:
/minio/health/live
QTable:
HTTP Root。
QTableUI:
/healthz。
而且 Compose 的依赖顺序会利用这些 Health State。
例如 QTable 等 PostgreSQL / Redis / MinIO Healthy 后再启动。
QTableUI 等 QTable Healthy 后再启动。
这是一个必要的 Operational Foundation。
但这里有一个非常重要的边界:
Liveness 不等于 Readiness。
QTable Root 能返回:
“Welcome to QTable API”
说明 Process 能回答 HTTP。
不代表:
Database Query 正常。
Redis 可用。
Object Storage 可写。
Automation Queue 没有积压。
Migration State 正确。
AI Provider 可用。
用户关键 Workflow 正常。
QTableUI /healthz 更刻意只检查 Nginx 自己。
代码里的注释甚至明确解释:
前端存活探针不依赖 Backend,以免 Backend 短暂重启导致 Frontend Component 被重建。
这是正确的 Liveness 语义。
但它也进一步说明:
以后应该把:
Liveness
和:
Readiness / Dependency Health
明确拆开。
“页面能打开”也不是业务健康
假设:
QTableUI 200。
QTable API Root 200。
PostgreSQL 也能连。
但是:
一个 Permission Query 大量 500。
Attachment Upload 全部失败。
Automation Worker 卡住。
Realtime Subscription 已断。
这种时候 Container Orchestrator 可能认为所有 Service 都是 Healthy。
用户却认为系统已经坏了。
所以 Production Observability 最终需要从:
Process Health
继续上升到:
Dependency Health。
Request Health。
Queue / Worker Health。
Business Flow Health。
Recovery Health。
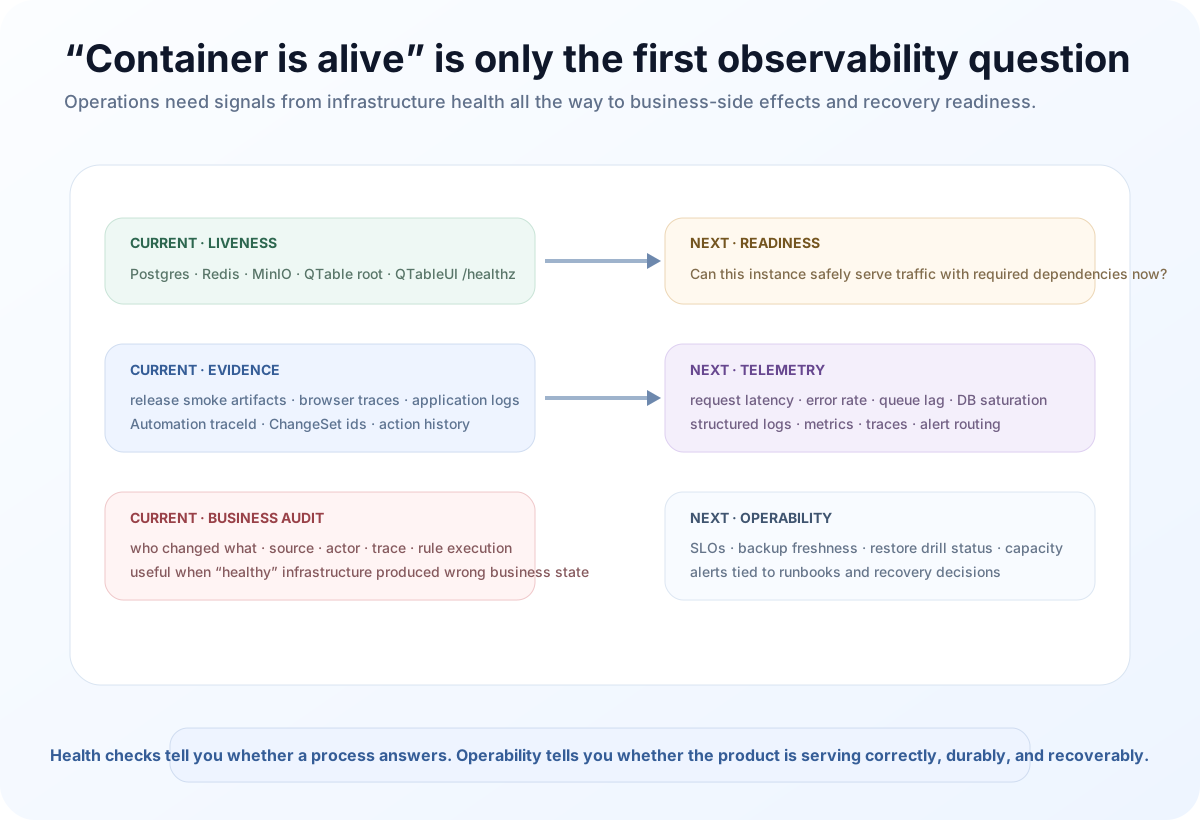
当前 QTable 已经有一些很重要的第二层 Evidence。
比如:
Automation Execution 有:
- traceId;
- action results;
- ChangeSet ids;
- error code;
- attempt。
Record Write 有 ChangeSet。
Release Gate 有 Browser Trace。
Container 有 Log。
这些 Evidence 在排查业务错误时非常重要。
因为很多 Production Incident 不是:
CPU 100%。
而是:
系统非常健康地执行了一件错误的业务动作。
这种时候 Prometheus 可能全绿。
真正需要看的是:
谁触发的。
哪个 Agent / Automation。
使用哪个 Rule Version。
写了哪些 Record。
形成哪些 ChangeSet。
所以 AI Native 产品的 Observability 一定不能只有 Infrastructure Metrics。
它还需要 Business Audit。
Backup 不能只问“有没有文件”
Backup 最容易产生一种假安全感:
每天 Cron 成功。
每天都有 Archive。
Retention 也正常。
于是大家认为 Disaster Recovery 已经完成。
但真正的问题应该是:
这个 Backup 能不能恢复出一套可用的 QTable?
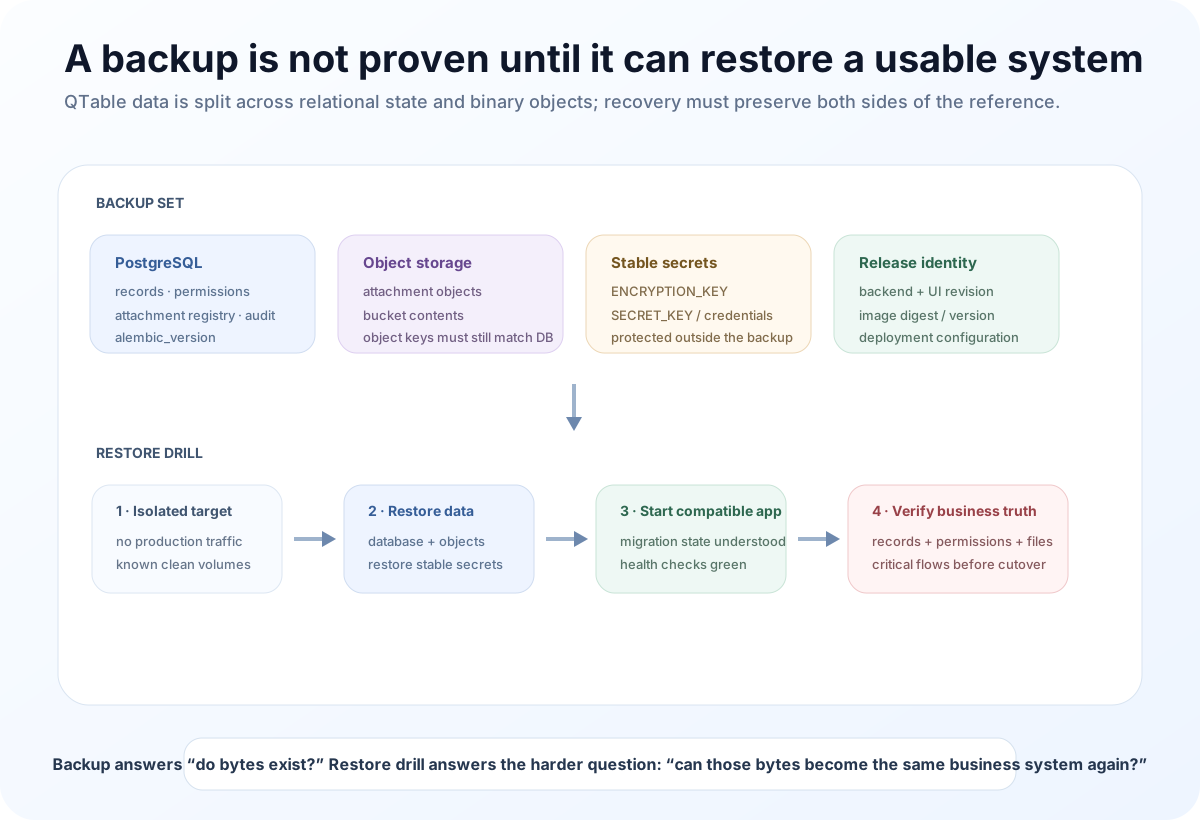
一个真正有意义的 Restore Drill 至少应该检查:
Database 能恢复。
Alembic Revision 可以识别。
Application 可以在对应 Revision 上启动。
Workspace / Table / Record 数量合理。
Permission 仍然有效。
Attachment Registry 对应 Object 确实存在。
用户可以下载附件。
Critical Flow 可以执行。
如果只验证:
PostgreSQL Dump 可以 Import。
还远远不够。
Restore 顺序也很重要
假设你有:
昨天的 Database Backup。
今天的 Object Storage Backup。
把它们组合起来恢复。
可能会得到:
数据库引用一个昨天还不存在的 Object?
或者:
Object 存在,但数据库已经没有对应 Registry?
所以随着产品进入更严格的 Production 场景,Backup 还需要明确:
Backup Timestamp。
Consistency Window。
Database Snapshot 和 Object Snapshot 的关系。
RPO。
RTO。
RPO
最多可以接受丢多少数据。
例如:
15 分钟。
1 小时。
24 小时。
RTO
故障以后多长时间必须恢复服务。
例如:
30 分钟。
4 小时。
1 天。
不同团队答案会完全不同。
Self-hosted 产品不一定替用户决定数字。
但应该提供足够清楚的 Deployment Contract,让用户能自己制定。
当前 QTable 还没有完整的 Backup / Restore Product
这里必须很明确地区分现状和目标。
当前仓库里已经有:
- Docker Named Volume;
- PostgreSQL;
- MinIO / S3 Contract;
- Release Guidance 中的 Backup 要求;
- Alembic Migration;
- Full-stack Release Smoke;
- Runtime Health Check;
- ChangeSet / Trace 等 Audit Foundation。
但这不等于已经有:
“一键备份”。
“一键恢复”。
Scheduled Backup Manager。
Backup Catalog。
Retention Policy UI。
Point-in-time Recovery。
Restore Drill Automation。
Backup Freshness Alert。
所以这篇讨论的是:
现在的架构已经有哪些 Recovery Foundation,以及下一阶段应该把哪些 Operational Contract 产品化。
而不是说这些能力已经全部完成。
Object Storage 的恢复还多一层“Registry Consistency”
QTable 的 Attachment Storage 实现里有一个很重要的设计:
Record 里不会只存一个临时 Presigned URL。
而是保存 Stable Reference:
attachmentId + objectKey + metadata。
真实 AttachmentObject Registry 在数据库里。
下载时系统通过 Registry 和 Scope 再确认:
这个 Attachment 是否真的属于:
当前 Table。
当前 Record。
当前 Field。
这对 Security 很重要。
从恢复角度看也一样重要。
Restore 验证不能只检查 Bucket Object Count。
应该检查:
Database Registry → Object Storage Key
这条关系仍然成立。
否则:
“Object Storage 100% 恢复”
依然可能得到坏掉的 Attachment Experience。
未来甚至可以做 Periodic Reconciliation:
找出:
Registry 指向 Missing Object。
Object Storage 中没有 Registry 的 Orphan。
Upload Pending 超时。
Cleanup Pending 长期失败。
这类 Storage Integrity Signal,本质上也是 Observability。
Automation Worker 也需要 Operational Signal
上一篇讲过,Automation Queue 当前是 Database-backed。
Worker 会:
Materialize Event。
Scan Scheduled Rule。
处理 Retry。
Claim Event。
Dispatch Rule。
当前有:
Event Lease。
Retry Lease。
Skip Locked。
Retry State。
Execution History。
这些都已经提供了可靠性基础。
但进入长期运营后,还需要新的问题:
Queued Event 最老多久?
Retry Scheduled 有多少?
过去一小时 Failed Execution 比例是多少?
有没有某条 Rule 连续失败?
Worker 最后一次成功 Cycle 是什么时候?
Scheduler Delay 多大?
这些指标现在还没有形成统一 Platform Metrics Contract。
但 Automation 已经有足够结构化的数据,可以把这些 Signal 做出来。
这也是为什么前面几篇一直强调:
不要只打 Log。
把 Runtime State 建模。
只有建模以后,才有可靠的 Metrics。
AI Runtime 也需要和传统 Web Monitoring 不同的指标
AI Native 产品还有另一类 Operational Cost。
传统 API 常看:
Request Rate。
Latency。
Error Rate。
CPU。
Memory。
Database Connection。
AI Runtime 还应该关心:
Model Request Latency。
Provider Error。
Token / Cost。
Tool Failure。
Context Build Time。
Action Plan Preview / Apply Failure。
Confirmation Abandonment。
Agent Permission Denial。
Tool Chain Retry。
但这里也要保持边界。
当前 QTable 代码里有 AI Logging 和不同 Runtime Trace Foundation。
不代表已经有完整统一的 AI Telemetry Platform。
未来应该把:
Provider。
Model。
Conversation。
Tool Call。
Action Plan。
Trace。
Cost。
Latency。
Error。
统一成能被 Operator 理解的 Signal。
不是为了“监控模型”。
而是为了回答:
为什么这次 Agent 体验变差了?
Production 配置必须 Fail Closed
Self-hosted 还经常出现一个问题:
Development Default 被直接复制到 Production。
当前 registry Compose 已经做了一些重要收紧。
例如 Production 下:
POSTGRES_PASSWORD 必填。
SECRET_KEY 必填。
ENCRYPTION_KEY 必填。
Attachment Storage Credential 必填。
Legacy JWT Acceptance 默认关闭。
Password Reset Debug Token 关闭。
Dynamic OAuth Client Registration 关闭。
Plain PKCE 关闭。
这体现一个原则:
Production Configuration 不应该因为“配置缺失”自动退回 Insecure Development Behavior。
Self-hosted 友好不等于:
什么都给默认值然后让服务先起来。
有些错误最正确的处理方式就是:
拒绝启动。
因为:
明显地失败
比:
悄悄用危险配置运行三个月
安全得多。
Public Exposure 也应该最小化
当前 Docker Hub Deployment Guidance 里已经明确:
推荐只把 QTableUI 公开。
PostgreSQL、Redis、MinIO、QTable API 默认都 Bind 在 Loopback / Private Network。
QTableUI 通过 Nginx Proxy 把必要路径转发给 Backend。
这也是很好的 Self-host Contract。
因为数据库、Redis、Object Storage Console 不应该为了“部署方便”直接暴露 Internet。
对外 Surface 越少:
TLS Boundary 越简单。
CORS 越简单。
Firewall 越简单。
Secret Exposure 风险越低。
攻击面也越小。
Self-hosted 产品要尽量做到:
默认拓扑安全,而不是依赖每个 Operator 都自己变成 Security Engineer。
Upgrade 的另一面是 Compatibility Window
如果真正做长期 Self-host,用户不可能每个版本都升级。
可能跨:
3 个 Minor Version。
6 个月。
1 年。
这会带来:
Migration Chain 是否仍然支持。
旧 Config Key 是否被移除。
旧 JWT / OAuth Contract 是否兼容。
Attachment Schema 是否改变。
Frontend 和 Backend 可以跨几个版本搭配。
所以后面版本管理不能只维护:
VERSION。
还需要维护:
Upgrade Path。
Minimum Supported Source Version。
Breaking Change。
Migration Note。
Configuration Change。
Recovery Note。
尤其是 AI Native 产品变化快。
如果没有 Upgrade Contract,Self-hosted 用户最终会把 Version Pin 死。
因为“升级”变成一次赌博。
Release Artifact 和 Backup Artifact 是两条不同的信任链
第八篇讨论 SBOM / Provenance 时,重点是:
我拿到的这个 Image 是不是从被验证的 Source 构建出来的。
这篇 Backup / Restore 讨论的是另一件事:
我的业务状态能不能回来。
它们分别回答:
Software Supply Chain Trust
和:
Data Continuity Trust
一套成熟 Self-hosted System 两个都需要。
Release Artifact 应该有:
Version。
Revision。
Digest。
SBOM。
Provenance。
Backup Artifact 应该有:
Timestamp。
Source Deployment Identity。
Database Revision。
Object Snapshot Identity。
Retention。
Encryption。
Verification Result。
以后甚至可以在 Restore Drill Report 里记录:
Restore 使用哪个 QTable Image Digest。
恢复的是哪个 Backup Set。
最后验证了哪些 Flow。
这样 Incident 期间不用靠记忆拼接系统状态。
“能恢复”必须进入 Release Engineering
我认为后面 QTable 真正要补齐的一条工程线是:
Recovery Gate。
今天 Release Gate 主要证明:
新版本能不能从干净环境和测试数据运行。
未来还应该增加:
从一个 Previous Release 的 Data Snapshot 启动。
执行 Upgrade Migration。
验证业务数据还在。
验证 Attachment 还在。
验证 Permission 还在。
验证 Automation History 还在。
验证关键页面可打开。
甚至:
把 Backup Restore 到 Fresh Environment。
再跑同一套 Release Smoke。
这时“升级安全”就不再只是文档建议。
而会成为 CI / Release Engineering 中真正执行过的 Evidence。
可观测性最后应该连接 Runbook
Metrics 本身不解决 Incident。
Alert 也不解决。
真正有用的是:
Signal → Decision → Runbook。
例如:
Database Connection Saturation。
告诉 Operator:
先看哪些 Dashboard。
如何确认 Connection Leak。
是否可以 Safe Restart。
Automation Queue Lag。
告诉 Operator:
怎么看 Worker 状态。
怎么看最老 Event。
是否要 Disable 某条 Rule。
Attachment Storage Error。
告诉 Operator:
如何验证 Bucket。
如何检查 Credential。
如何看 Pending Cleanup。
Backup Stale。
告诉 Operator:
最后一次成功 Backup 是什么时候。
上一次 Restore Drill 是否通过。
如果没有 Runbook,Alert 最终只是更快地告诉你:
“系统坏了。”
但不知道下一步做什么。
Self-hosted 的体验应该包括“如何安全失败”
做产品时,我们常常优化 Happy Path:
安装更简单。
按钮更少。
启动更快。
但 Self-hosted 长期价值,很大一部分来自:
Failure Path。
Migration 失败怎么办。
Storage 满了怎么办。
Secret 错了怎么办。
Backup 不完整怎么办。
Provider 不可用怎么办。
Agent Tool Timeout 怎么办。
Automation Rule 连续失败怎么办。
用户真正信任系统,不是因为它从不出错。
而是因为:
出错以后它的状态是可理解的。
恢复路径是可执行的。
这和前面九篇其实是同一条主线。
第三篇的 Preview → Confirm → Apply,是让 AI 写入失败得可控。
第五篇 Tool Chain Runtime,是让多步骤执行失败得可追踪。
第七篇 Permission Boundary,是让越权失败得安全。
第九篇 Automation Retry,是让规则执行失败得可恢复。
第十篇只是把这个思想扩展到整个 Deployment:
一个系统的成熟度,很大程度上取决于它如何失败。
回头看这十篇,QTable 真正在做什么
第一篇问:
为什么还要做一个多维表格。
第二篇回答:
因为结构化 Field / Record / Relation 是 Agent 很好的业务数据底座。
第三篇继续:
AI 写入不能直接成为事实,需要 Preview → Confirm → Apply。
第四篇:
Agent 不能靠无限 Prompt,需要真实 Context Boundary。
第五篇:
复杂工作不是函数调用列表,需要 Tool Chain Runtime。
第六篇:
Grid、Kanban、Gantt 不应该各存一份状态,而应该投影同一份事实。
第七篇:
Agent 不是管理员,权限不能高于当前用户。
第八篇:
开源不是 Public Repository,而是可验证的 Software Supply Chain。
第九篇:
AI Native 不等于所有工作都交给模型,确定性规则应该进入 Automation Runtime。
最后这篇:
Self-hosted 不是 Container Running,而是一个可以被升级、恢复、解释和运营的长期系统。
这十篇最后汇到一起,我认为 QTable 真正想构建的并不是:
“带 AI 的多维表格。”
更准确一点是:
一个让业务事实保持结构化,让 AI 在明确边界内理解和行动,让每一次变化都可追踪,并且能够被团队自己长期持有和运营的工作系统。
AI Native 的重点从来不应该只是:
模型更强。
Prompt 更长。
按钮里多一个 Copilot。
真正决定这类系统能不能进入业务核心的是:
Data Model。
Authorization。
Execution Boundary。
Audit。
Deterministic Runtime。
Release Trust。
Recovery。
Operability。
这些看起来都没有 Demo 里的 AI 对话惊艳。
但它们才决定:
AI 能不能从“建议你做什么”,走到“真的帮你做事”。
也决定:
一个开源产品能不能从“我能在本机跑起来”,走到“我敢把团队的数据长期放进去”。
QTable 现在离完整答案还很远。
Backup / Restore 还没有完整产品化。
Readiness / Metrics / Alerting 还需要补。
Dedicated Worker Plane 还需要演进。
Upgrade Compatibility 还需要长期积累。
External Connector / Webhook 也还在后面。
但我更愿意把这些边界写清楚。
因为真正的工程进度不是:
把未来能力提前写成完成状态。
而是:
知道现在已经站在哪里,下一步还缺什么。
这个系列到这里结束。
但 QTable 的工程故事,才刚刚从“把系统做出来”,进入“让系统值得长期运行”的阶段。
QTable 已经开源
如果你对本文讨论的数据模型、AI 工作流或开源工程实践感兴趣,可以直接阅读代码、提交 Issue 或参与贡献。