
开源不是把仓库设成 Public:QTable 如何用 CI、SBOM、Provenance 建立供应链信任
代码公开只是第一步。用户真正运行的是依赖、容器镜像和发布制品。本文结合 QTable / QTableUI 当前 CI、依赖审计、CycloneDX SBOM、Trivy、BuildKit Provenance、OCI Metadata、镜像 Digest 与 Full-Stack Release Gate,拆解一份开源源码如何变成一份可以被追溯和验证的发布制品,以及当前还没有完全闭环的地方。
第一篇写 QTable 为什么要开源时,我提过一句:
开源对 QTable 来说不是发布方式,而是产品约束。
当时列了几个很具体的问题。
Docker 镜像从哪个 commit 构建?
依赖里有没有已知漏洞?
发布物有没有 SBOM 和 provenance?
如果今天重新回到这些问题,我会再加一个更尖锐的问题:
你看到的源码,和你真正运行的那个镜像,中间到底发生了什么?
这其实是供应链信任最核心的地方。
一个仓库公开,不代表 Docker Hub 上某个镜像一定来自这个仓库。
一份 CI Workflow 存在,不代表它真的在这个 Release 对应的 commit 上跑过。
一个镜像名字叫 0.1.2-alpha,也不代表它永远不会被另一份内容覆盖。
甚至一份 SBOM 存在,也不自动说明依赖解析是可重复的,更不说明这份 SBOM 对应的就是你现在运行的那个 Artifact。
所以第八篇我不太想从“什么是 SBOM”开始。
我更关心的是:
一个用户如何从 Release Artifact,一路追溯回 Reviewed Source;一个维护者又如何留下足够的证据,让这个过程不依赖“相信我”。
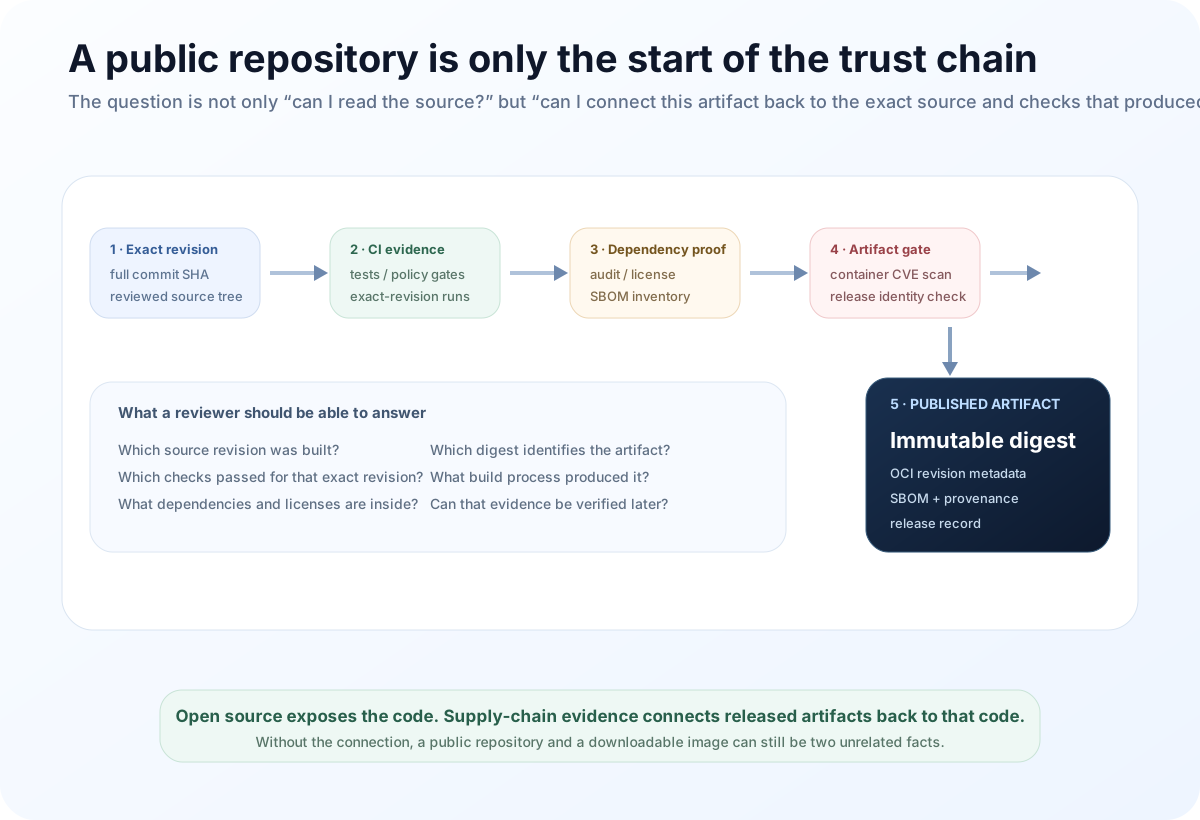
CI 最重要的不是“绿”,而是“哪一个 revision 绿了”
很多项目会把 CI Badge 放在 README 顶部。
这当然有用。
但对 Release 来说,“当前 main 是绿的”远远不够。
假设:
- Commit A 通过了测试;
- Commit B 改了一段权限逻辑;
- Release Tag 指向 Commit B;
- README 上的 Badge 仍然是绿色。
这个 Badge 对 Commit B 没有提供任何证据。
所以 QTable 当前的 Release Draft 对“exact revision evidence”要求得很重。
Backend CI、Frontend CI 和 Full-Stack Release Smoke 都不是一句“CI passed”就结束。
最终 Release Record 应该保存:
- QTable 完整 40 位 commit SHA;
- QTableUI 完整 40 位 commit SHA;
- 对应这两个 revision 的 CI Run;
- Full-Stack E2E / Smoke 对应的 revision pair;
- 最终镜像 Digest;
- 镜像里记录的 OCI Revision。
这也是为什么目前 v0.1.2-alpha 的 Release Note 仍然明确写着 DRAFT / NOT YET RELEASED。
Workflow 已经存在,不等于 Release Gate 已经通过。
这是一个我很愿意坚持的区别:
CI Definition 是规则;CI Run 才是证据。
QTable 当前 Backend CI 和 QTableUI Frontend CI 还是显式 workflow_dispatch Gate,而不是每个 PR / main push 都自动消费 Runner。
这当然意味着发布流程还不是完全自动化。
但它至少没有假装“仓库里有一个 YAML,就等于所有 revision 都经过验证”。
对 Alpha 阶段,我更愿意先把这个语义写清楚,再逐步把 Release Orchestration 自动化。
依赖问题其实至少有四个不同的问题
“依赖安全”经常被说成一个词。
实际至少有四件事。
第一,你最终安装了什么版本?
第二,这些版本有没有已知漏洞?
第三,这些包的许可证能不能进入你的发行物?
第四,你能不能把最终安装结果交给别人检查?
Lockfile、Vulnerability Audit、License Policy、SBOM 分别解决的是不同的问题。
它们不能互相替代。
QTableUI 这一侧目前的链路更完整一些。
仓库里有 package-lock.json。
CI 用 npm ci。
Docker build 也用 npm ci –ignore-scripts,不会重新做一轮自由版本解析。
CI 同时执行:
npm audit;- Dependency License Gate;
npm sbom –sbom-format=cyclonedx;- 把 Audit JSON 和 CycloneDX SBOM 作为 Artifact 上传。
这里的关系很清楚。
Lockfile 约束“装什么”。
Audit 检查“已知风险”。
License Gate 检查“能不能合法进入发行”。
SBOM 则告诉下游“这次环境里最终有什么”。
Backend 的情况更值得写,因为它正处在迁移阶段。
requirements.in 是人工维护的 Direct Dependency Policy,里面当前大部分依赖仍然使用开放 Version Range。
requirements.txt 只是兼容入口,内容只有:
-r requirements.in
同时项目已经实现了 PEP 751 Lock Policy 和 refresh_python_lock.py,目标文件是 pylock.toml。
但当前源码树里 还没有 materialize 这份 pylock.toml。
也就是说,Backend 已经知道“确定性解析”应该怎么做,CI Policy 也已经能验证它,但当前 Release Dependency Resolution 还没有完全锁死。
这一点不能因为已经有 SBOM 就略过。
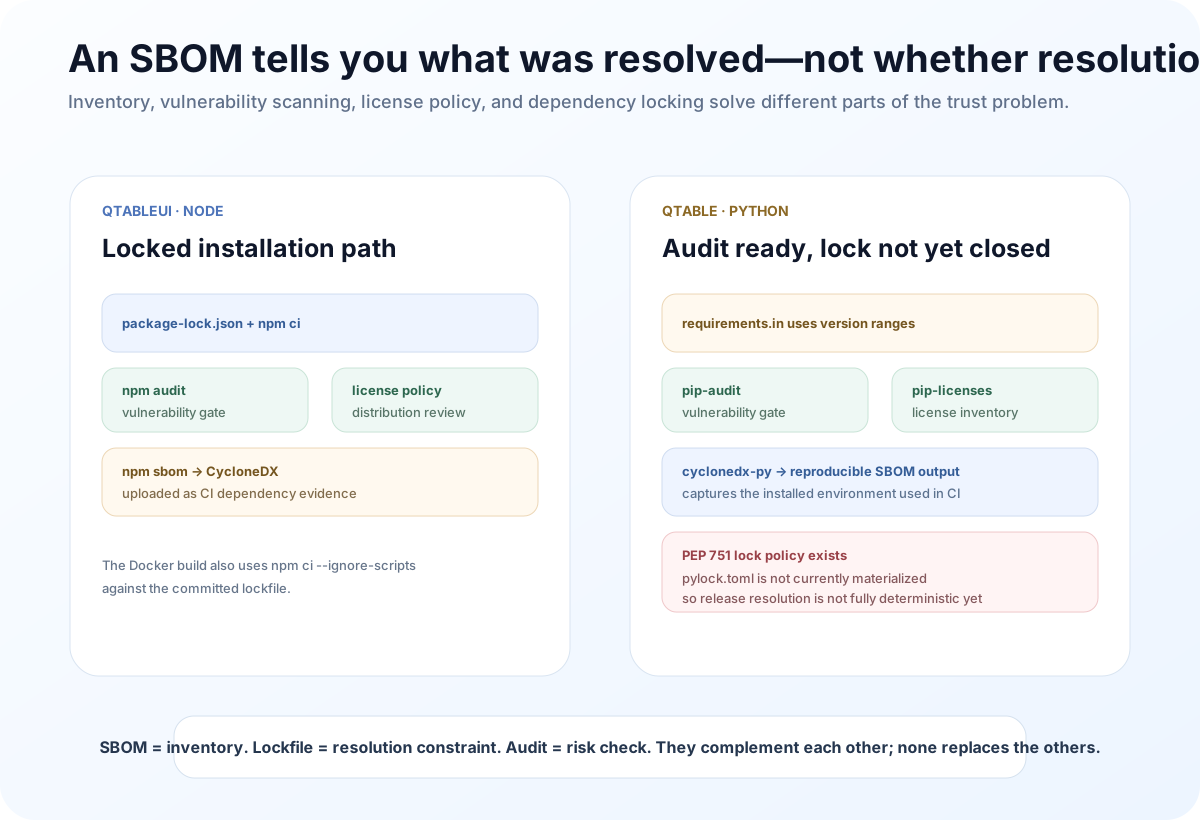
Backend CI 当前执行的 audit_python_dependencies.py 做了三件事:
先 pip check,确保 Installed Distribution 没有破损或依赖冲突。
然后用 pip-audit 做 Vulnerability Audit。
再用 pip-licenses 生成许可证清单,并对 AGPL、SSPL、Business Source License、Commons Clause 等需要显式 Policy Review 的 License 做阻断。
最后用 cyclonedx-py 生成 CycloneDX SBOM。
这些 Evidence 会作为 CI Artifact 上传。
我比较喜欢的一点是,Audit Tool 自己也没有完全浮动。
requirements-audit.txt 里的 pip-audit、cyclonedx-bom、pip-licenses 都是 Exact Pin。
因为“扫描器今天升级以后改变判断逻辑”本身也会影响 Release Evidence。
SBOM 不是“安全证明”,它更像一张可查询的货物清单
SBOM 这个词这几年很容易被包装成一个安全 Badge。
但它其实没那么神奇。
如果一个镜像包含:
- Python Package A;
- Node Package B;
- OpenSSL C;
- Nginx D;
SBOM 解决的是:
这些东西到底是什么,叫什么,是什么版本。
它让后续 Vulnerability Matching、License Review、Incident Response 变得可执行。
比如某个严重漏洞披露以后,维护者不必靠印象回答:
“我们应该没用这个包吧?”
而是可以查 Release 对应的 SBOM。
但 SBOM 本身不会告诉你:
这份 Artifact 一定来自某个 Git Commit。
它也不会告诉你:
依赖一定是按照某个固定 Lockfile 解析的。
更不会自动告诉你:
这份 SBOM 没被替换。
所以真正的信任链一定要继续往 Artifact Identity 和 Provenance 走。
QTable 的 Docker Publish 已经不只是“docker build && docker push”
目前 Backend 和 QTableUI 都有独立的 Docker Publish Workflow。
这条链路里已经有几个我认为很重要的约束。
首先是 Release Identity Check。
发布时会读取仓库里的 VERSION。
Tag Publish 要求 Git Tag vX.Y.Z 和 VERSION 完全一致。
QTableUI 还会额外检查 package.json、package-lock.json Root Version 和 VERSION 一致。
如果版本不一致,Workflow 直接失败。
其次是 Publication Authorization。
即使 Push 了 v* Tag,也不是自动就能把镜像发布出去。
当前 Workflow 还要求 Repository Variable:
DOCKERHUB_PUBLISH_ENABLED=true
否则 Tag Run 只是被阻断。
Docker Hub Token 也通过独立 Secret 注入,不写进源码。
这让“创建 Tag”和“授权公开发布”成为两个不同动作。
第三是 发布前先构建本地镜像做 Vulnerability Gate。
Backend 和 QTableUI 的 Release Workflow 都会先构建当前 exact revision 的 Local Image。
然后用 Trivy 检查 OS / Library Vulnerability。
当前 HIGH 或 CRITICAL 会让发布失败。
只有这一步通过,才进入 Multi-Architecture Build。
第四是 发布构建明确恢复 Official Upstream Source。
这是 QTable 比较特殊的一个工程约束。
为了让 Rainbond 和部分受限网络里的无参数源码构建可以工作,两个 Dockerfile 的默认 Base Image / Registry 都偏向可访问的 Mirror。
但是正式 Docker Hub Release Workflow 会显式把它们重新设置为:
Backend:
python:3.11-slim;- Official PyPI。
QTableUI:
node:22-alpine;nginx:alpine;- Official npm Registry。
也就是说,“开发环境默认能构建” 和 “官方发布产物来自哪条上游供应链” 被刻意区分开了。
这比在 README 写一句“使用官方镜像”更可信,因为 Release Workflow 自己重新声明了这些 Build Args。
Provenance 想回答的是:谁,在什么条件下,构建了这个东西
SBOM 回答“里面有什么”。
Provenance 更接近回答:
“这个 Artifact 是怎么来的?”
QTable / QTableUI 当前发布 Workflow 都在 docker/build-push-action 上设置:
sbom: true
以及:
provenance: mode=max
同时镜像会写入 OCI Metadata:
- source;
- license;
- version;
- revision;
- created time。
其中最重要的是 org.opencontainers.image.revision。
它把 Build Artifact 和 github.sha 连起来。
再加上 Build Output Digest,发布后就能形成:
Source Commit → Build Attestation / Metadata → Image Digest
这条链。
不过这里有一个容易混淆的地方。
Provenance 不等于签名。
BuildKit 生成 Provenance Attestation,能描述 Build Process 和材料来源。
但“下游用户应该用什么 Identity / Key / Keyless Mechanism 验证这个 Attestation 真的是 QingZoneX 授权发布的”,当前还没有一套独立、明确、对消费者公开的 Verification Policy。
也没有看到 Cosign / Sigstore 之类的签名链已经成为 Release Gate。
所以现在更准确的说法应该是:
QTable 的发布路径已经开始生成 SBOM 和 Provenance Evidence,但 Artifact Signing 与 Consumer Verification 还没有形成完整闭环。
这也是为什么我不愿意把 provenance: mode=max 写成“供应链安全已经完成”。
Tag 适合人看,Digest 才更接近机器可以依赖的身份
Docker Tag 很方便。
0.1.2-alpha 很直观。
alpha 更方便。
稳定版以后可能还有 latest。
但 Tag 的问题是:
它是名字。
有些名字是 Moving Pointer。
所以如果一份生产审计记录只写:
“我们部署了 qingzonex/qtable:alpha。”
几个月以后这个信息可能已经无法还原当时究竟跑的是哪份 Manifest。
真正稳定的 Artifact Identity 应该是 Digest。
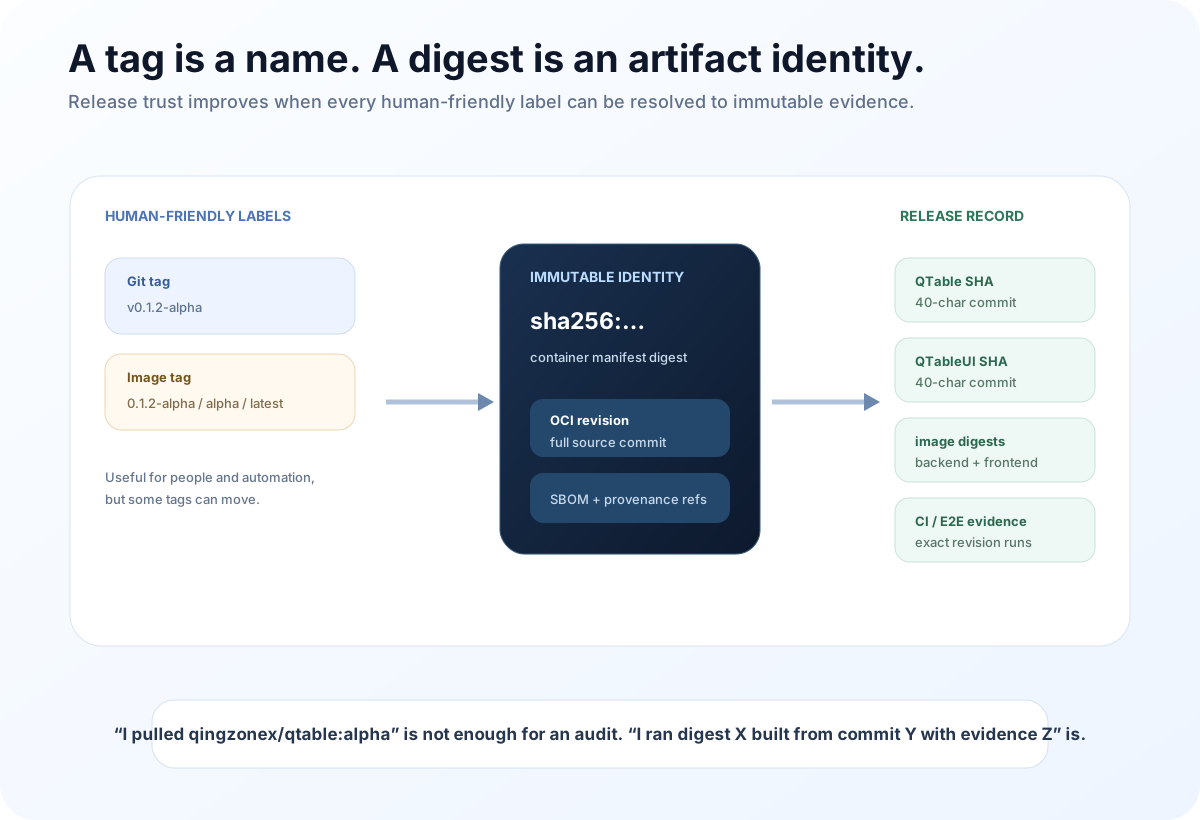
QTable 当前 Release Draft 也明确要求:
发布后记录两个应用镜像的 Digest 和 OCI Revision Label。
同时保存 Backend / Frontend 的 Full SHA。
这比“Release 名叫 0.1.2-alpha”多了非常多信息。
我希望以后生产部署文档也能进一步明确:
如果用户追求可审计部署,Compose / Helm / GitOps 应该优先允许按 Digest Pin。
因为“发布时知道 Digest”和“部署时真正使用 Digest”是两件不同的事。
Full-Stack Release Gate 解决的是“两个正确的组件放在一起还正确吗”
QTable 并不是一个单仓库单 Binary 产品。
Backend 和 QTableUI 各有自己的 CI。
但两个仓库分别通过,不代表组合以后一定通过。
API Contract、Migration、Nginx Proxy、WebSocket、Redis、PostgreSQL、Object Storage、Runtime Environment 都可能在组合以后出问题。
所以 QTableUI 目前还有一个 Full-Stack Release Smoke。
它要求显式输入一个 exact QTable revision。
Workflow 本身运行在 exact QTableUI revision 上。
然后 Checkout 指定 Backend Revision,记录:
- QTableUI SHA;
- QTable SHA;
- requested backend revision;
- event / ref。
接着拉起完整 Compose Stack。
检查:
- QTableUI Health;
- Backend Health;
- MinIO Health;
- Redis;
- Compose Service State。
最后把 revision evidence 和 smoke artifacts 上传。
这解决的是供应链里一个经常被忽略的问题:
Release Artifact 不只是“每个组件各自安全”,还要知道哪些组件版本被一起验证过。
对于未来会有更多 Connector、Worker、Agent Runtime Service 的系统,这个 Pair / Set of Revisions 会越来越重要。
Dependabot 解决“依赖会变”,但不等于变更可以自动信任
Backend 和 Frontend 现在都配置了 Dependabot。
Backend 看:
- pip;
- GitHub Actions;
- Docker。
Frontend 看:
- npm;
- GitHub Actions;
- Docker。
这件事很重要,因为供应链安全不可能靠“一次性审计”。
今天没有 CVE,不代表下周还没有。
但是自动提 PR 只是“发现和更新”的入口。
它不应该自动变成:
“机器人发的,所以可以直接合。”
特别是 GitHub Actions 和 Docker Base Image。
它们实际上是 Build System 的一部分。
一个 Action 版本变化,可能改变 Workflow 权限、Artifact 内容、缓存行为甚至外部网络访问。
一个 Base Image 更新,可能改变 OS Package 和 Runtime Behavior。
所以 Dependabot 的价值,不是减少 Review。
而是让 Review 有稳定入口。
现在还没有完全闭环的地方
如果只看当前 QTable / QTableUI 的 Workflow,供应链工程已经不是空白。
但距离“任何人都能独立验证 Release”还有明显差距。
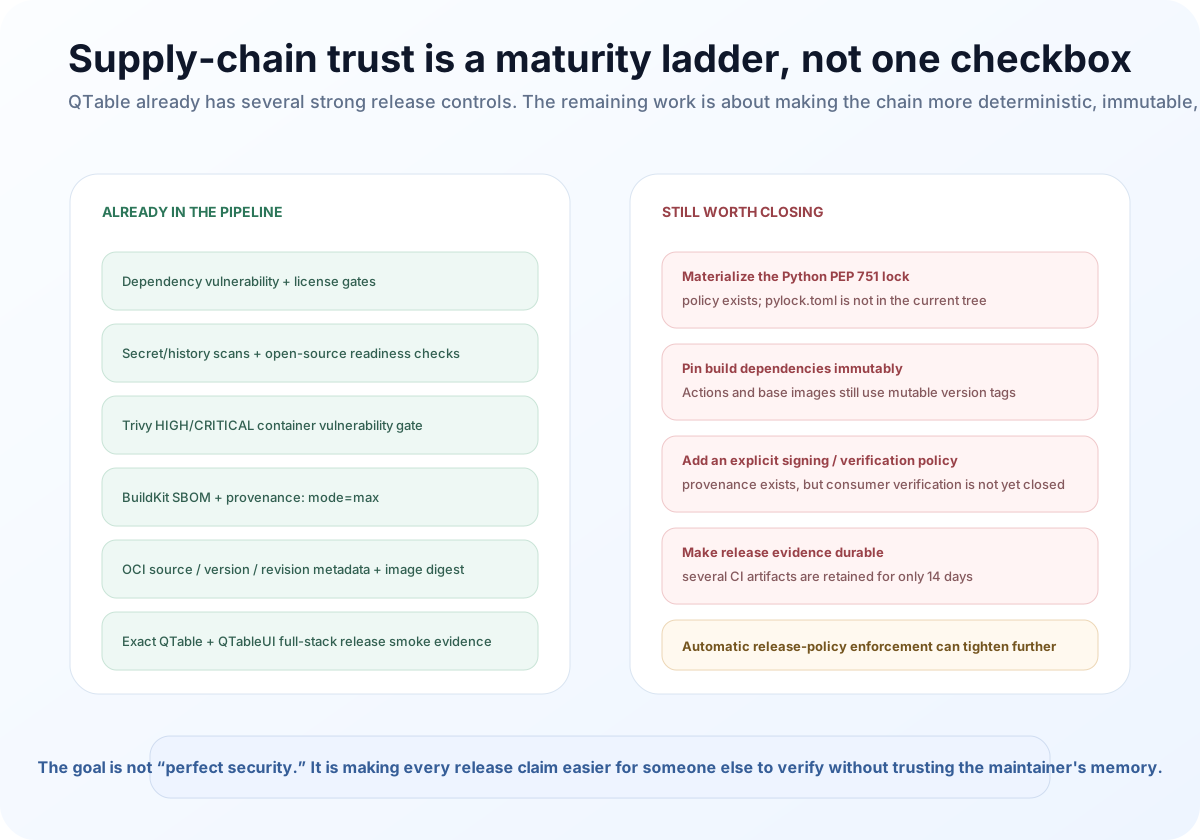
1. Backend 的 Python Lock 还没有真正落地
PEP 751 Lock 的生成脚本、验证逻辑、Release Require-Lock Policy 都已经有了。
但当前 pylock.toml 不在源码树。
这意味着今天同一个 requirements.in,在不同时间解析,仍然可能得到不同的 Transitive Dependency Version。
要让“同一 Source Revision”更接近“同一 Dependency Graph”,这件事必须闭环。
2. GitHub Actions 和 Base Image 仍然大量使用可移动版本标签
当前 Workflow 里能看到:
actions/checkout@v7
actions/setup-python@v7
docker/build-push-action@v7
以及:
python:3.11-slim
node:22-alpine
nginx:alpine
这些版本标签很实用,也有 Dependabot 跟踪。
但它们不是 Full Commit SHA / Image Digest。
从严格 Reproducibility 角度,同一个 QTable Commit 在不同日期重新构建,外部 Build Input 仍可能变化。
后续可以逐步把关键 Action Pin 到 Full Commit,把 Release Base Image Pin 到 Digest,同时保留可读 Version Comment。
3. Provenance 已经生成,但 Sign / Verify Policy 还不完整
现在有 BuildKit SBOM 和 Provenance。
这是很重要的一步。
下一步应该明确:
官方 Artifact 用什么 Identity 签名。
消费者用什么命令验证。
Release Page 如何给出 Verification Instruction。
CI 是否强制验证签名以后才进入部署。
没有 Consumer Verification Path,Attestation 仍然更像“有证据”,还没有变成“每个人都知道怎么验证证据”。
4. CI Evidence 的 Retention 还偏短
Backend Dependency Evidence、Frontend Dependency Audit、Full-Stack Release Smoke Artifact 目前多处是 14 天 Retention。
对日常 PR 很合理。
对正式 Release 不够。
Release Evidence 最好长期跟 Release Record 绑定,或者复制到不可变、长期保存的位置。
否则半年以后,只剩 Release Tag 和镜像,关键 CI Artifact 已经过期。
5. Release Gate 目前仍有人工编排
Backend CI、Frontend CI、Full-Stack Smoke、Tag、Publish Authorization 现在是清晰但相对分散的 Gate。
它们强调 exact revision,这是优点。
但也意味着 Maintainer 还需要自己确保:
“我现在发布的这对 SHA,就是刚才那几条成功 Run 验证的那对 SHA。”
下一阶段更理想的做法,是让一个 Release Orchestrator 接收 Revision Pair,自动检查所有 Required Evidence,通过后才创建 Release / Tag / Publish。
这样可以进一步减少“人记错了”的空间。
为什么 AI Native 产品更需要认真做这件事
有人可能会问:
一个项目管理工具,有必要做这么多供应链工程吗?
我觉得 AI Native 反而让它更重要。
因为未来 QTable 不只是显示表格。
它可能:
- 保存 AI Provider Key;
- 读取项目和成员信息;
- 调用外部 Tool;
- 执行 Automation;
- 生成并应用 Action Plan;
- 访问附件和 Object Storage;
- 在企业网络里长期运行。
用户真正部署的是一个有高业务权限的 Runtime。
这时“源码看起来没问题”只是第一层信任。
第二层必须是:
我运行的东西,真的是那份源码经过我能理解的构建过程生成的吗?
这和上一篇“Agent 权限不能高于当前用户”其实是同一个方向。
上一篇约束 Runtime 的业务权限。
这一篇约束 Release Artifact 的来源。
两者都在做一件事:
减少系统里必须靠相信而无法验证的部分。
我更关心的不是 SLSA 等级,而是能不能回答问题
供应链安全很容易变成标准名词堆叠。
SLSA。
SBOM。
SPDX。
CycloneDX。
Sigstore。
Cosign。
Provenance。
这些标准都很重要。
但一个项目一开始更实际的判断方式是:
能不能回答几个问题。
这个镜像对应哪个 commit?
这个 commit 的 CI 跑了吗?
跑的是这一个 revision,还是别的 revision?
依赖清单在哪里?
高危漏洞扫描过吗?
许可证检查过吗?
这两个前后端 revision 一起跑过吗?
镜像的不可变 Digest 是什么?
Provenance 指向什么 Build?
消费者如何验证官方 Artifact?
六个月后,这些 Evidence 还在吗?
如果这些问题大部分都能直接用机器生成的证据回答,供应链信任就在变得具体。
如果答案主要是:
“应该是。”
“我记得跑过。”
“这个 Tag 一般不会改。”
那再漂亮的 Security Badge 都没有太大意义。
开源真正改变的是责任边界
把源码公开以后,维护者少了一种说法:
“你相信我们就行。”
因为既然用户已经能检查源码,他自然会继续问:
那为什么我要相信这个 Binary?
为什么我要相信这个 Container?
为什么我要相信这个 Dependency Tree?
为什么我要相信这个 Tag?
这不是对开源维护者更苛刻。
恰恰相反。
这是开源最有价值的地方之一:
它把 Trust 从品牌关系,慢慢变成可验证的工程关系。
所以这一篇我最想留下的结论不是:
“QTable 支持 SBOM。”
而是:
真正有价值的开源供应链,不是给 Release 多挂几个安全名词,而是让 Source、Build、Dependency、Artifact 和 Release Record 能够彼此校验。
QTable 当前已经有 Dependency Audit、License Policy、Secret Scan、Container CVE Gate、CycloneDX SBOM、BuildKit Provenance、OCI Revision Metadata、Image Digest 和 Exact-Revision Full-Stack Smoke。
同时,Python Lock、Immutable Build Inputs、Artifact Signing、Consumer Verification、长期 Evidence Retention 和 Release Orchestration 还需要继续补齐。
这才是当前比较准确的状态。
前八篇到这里,也把第一篇最初列出的七个工程问题全部走了一遍。
后面的文章我会继续沿着同一个原则写:不按功能菜单介绍 QTable,而是继续追踪那些真正决定一个 AI Native 工作系统是否能被长期使用、部署和维护的工程边界。
QTable 已经开源
如果你对本文讨论的数据模型、AI 工作流或开源工程实践感兴趣,可以直接阅读代码、提交 Issue 或参与贡献。